|
recaplica
Unicode: cos'è e perché ha sostituito ASCII | |||||||||||||||
| © 2026 Recaplica · recaplica.com — Tutti i diritti riservati | |||||||||||||||
Unicode: cos'è e perché ha sostituito ASCIICosa stampare Con "Margini: predefiniti" compaiono anche i numeri di pagina. SlideScegli il taglio Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta15 slideTutti i capitoli e gli approfondimentiTutte e due hanno le note del relatore. In 30 secondi lettura lampoUnicode è lo standard che assegna un numero univoco, chiamato code point, a ogni carattere di ogni lingua scritta nel mondo. È nato per sostituire ASCII, il codice del 1963 che con i suoi 128 caratteri copriva solo l'alfabeto inglese, senza accenti né altri alfabeti. Il testo viaggia quasi sempre in UTF-8, una delle forme con cui Unicode traduce quei numeri in byte, compatibile all'indietro: un testo scritto solo in ASCII è già un testo UTF-8 valido. La versione 18.0 dello standard, pubblicata a settembre 2026, copre 172.808 caratteri. Punti Chiave
I numeri chiave
L'ApprofondimentoUn numero per ogni carattereSecondo la FAQ del Consortium Unicode, Unicode è lo standard di codifica universale dei caratteri, la base su cui si elaborano, si salvano e si scambiano i testi in qualunque lingua. A ogni carattere possibile — una lettera, un segno di punteggiatura, un simbolo — lo standard assegna un numero univoco, chiamato code point, scritto con la notazione U+ seguita da cifre esadecimali. Il computer, dentro, lavora sempre e solo in numeri binari: Unicode è il ponte che traduce quei numeri in caratteri leggibili da una persona.
Perché ASCII non bastava piùASCII, pubblicato nel 1963 come standard ASA X3.4-1963, usa 7 bit per carattere: un valore da 0 a 127, per un totale di 128 code point, di cui 95 stampabili e 33 di controllo. Bastava per l’inglese scritto con la tastiera americana, ma secondo Wikipedia lo standard non supporta direttamente termini o nomi come résumé, jalapeño o naïve, perché non ha code point per le lettere con segni diacritici. Le revisioni successive provarono ad allargare lo spazio a 8 bit, con famiglie di codifiche “parenti” di ASCII pensate per singole lingue, restando però incompatibili tra loro: nessuna bastava a coprire più alfabeti insieme. Come funziona UTF-8Unicode assegna i numeri; UTF-8 è il modo più diffuso di trasformarli in byte da salvare o trasmettere. Lo specifica l’RFC 3629 dello IETF, pubblicato nel novembre 2003: ogni carattere diventa una sequenza da 1 a 4 byte, a seconda di quanto è alto il suo code point, fino a coprire l’intero intervallo U+0000-U+10FFFF. Il primo byte porta un pattern di bit che dice quanti byte seguono; i byte successivi iniziano sempre con gli stessi due bit, così un programma può sempre capire dove comincia un nuovo carattere, anche aprendo il file a metà. La caratteristica che ha reso UTF-8 la scelta più diffusa sul web è la compatibilità all’indietro: per l’RFC 3629, i caratteri US-ASCII sono codificati in un solo ottetto con il normale valore US-ASCII. Un file scritto solo in ASCII, letto come UTF-8, produce esattamente lo stesso testo — nessuna conversione, nessun byte che cambia. Quando un testo viaggia da un server a un browser, attraverso la rete che porta i dati da un capo all’altro, la codifica dichiarata deve combaciare con quella usata per scrivere il file, o i caratteri arrivano storpiati.
Una storia breveL’idea di una codifica universale nacque, secondo la pagina storica del Consortium, circa quattro anni prima della fondazione dell’ente — quindi attorno al 1987 — da discussioni tra ingegneri di Xerox (Joe Becker) e Apple (Lee Collins e Mark Davis). Lo Unicode Consortium fu costituito formalmente nel gennaio 1991, in California. La Versione 1.0 dello standard, Volume 1, fu pubblicata pochi mesi dopo, in ottobre dello stesso anno. Da allora lo standard è cresciuto versione dopo versione, aggiungendo alfabeti e nuovi intervalli di code point, compreso uno spazio di oltre 137.000 code point riservato all’uso privato, per chi ha bisogno di caratteri personalizzati fuori dallo standard. Chi scrive codice lavora quasi sempre con testo già codificato in Unicode, spesso attraverso l’algoritmo di UTF-8 descritto sopra, anche senza accorgersene: uno degli sviluppi raccontati nella storia del computer. PresentazioneSlide pronte da scaricare e fare tue in PowerPoint o Google Slides, con le note del relatore. Scegli il taglio Lampo o quello Completo.     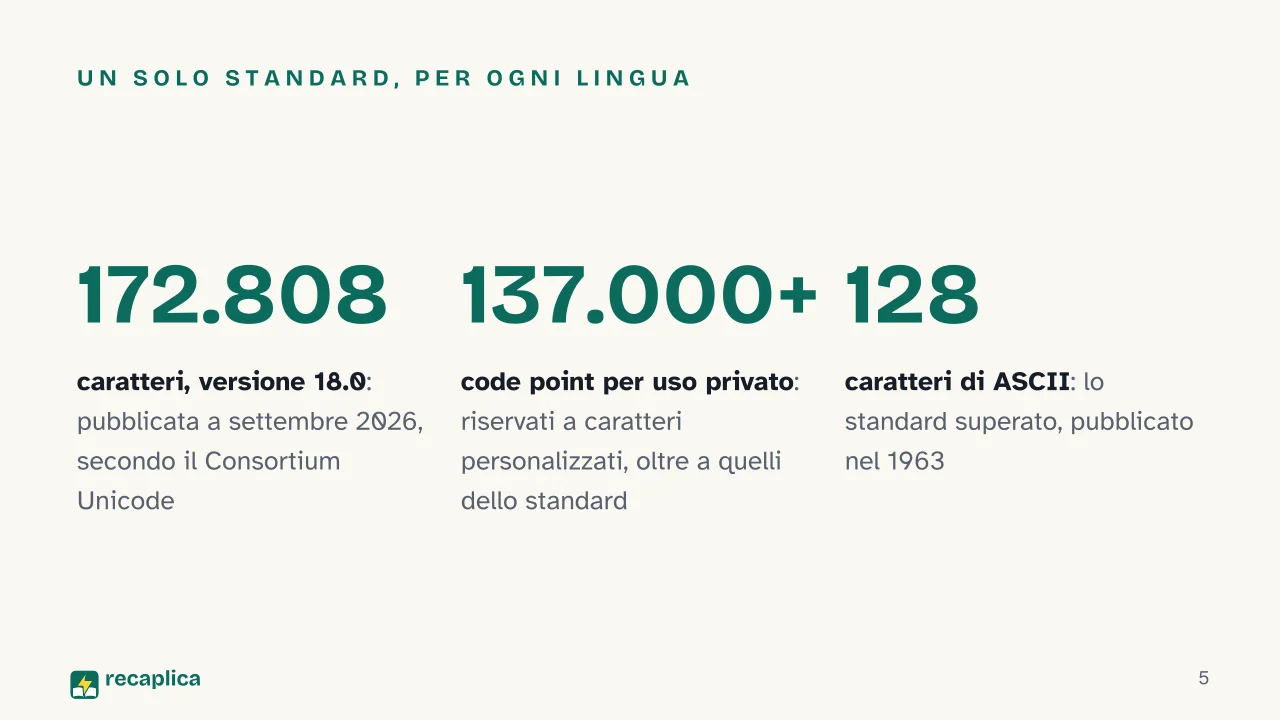  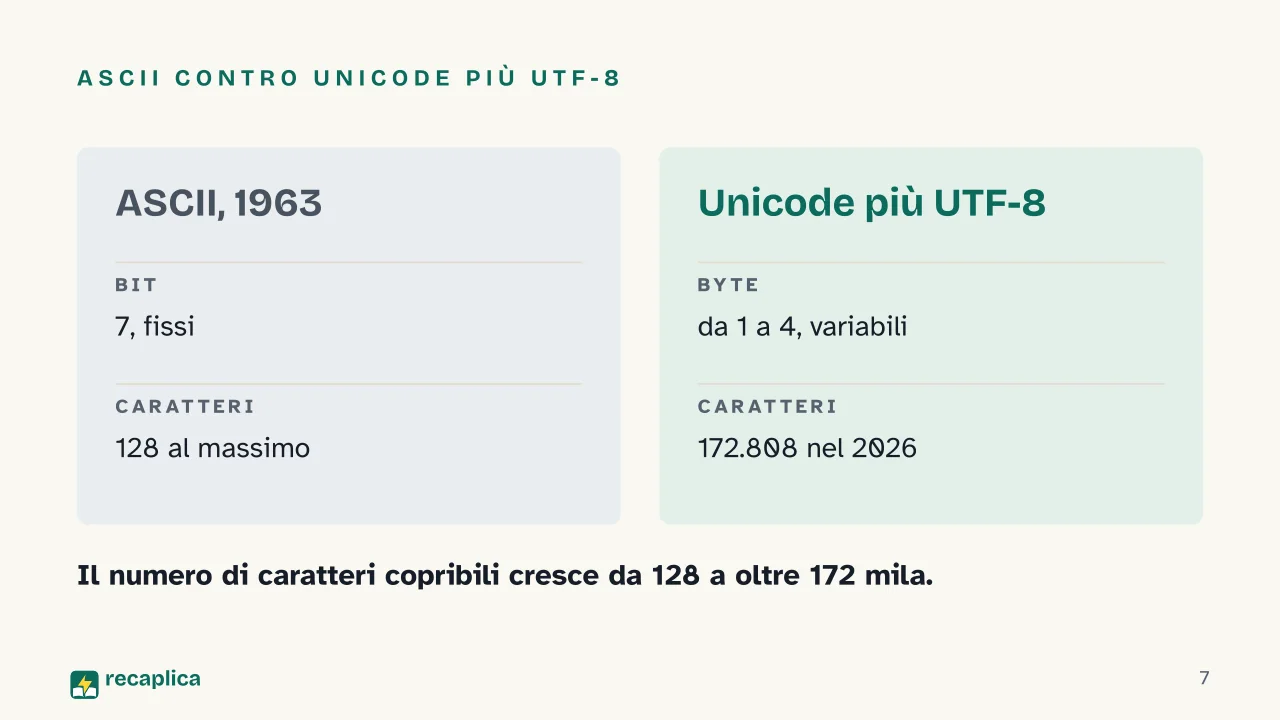 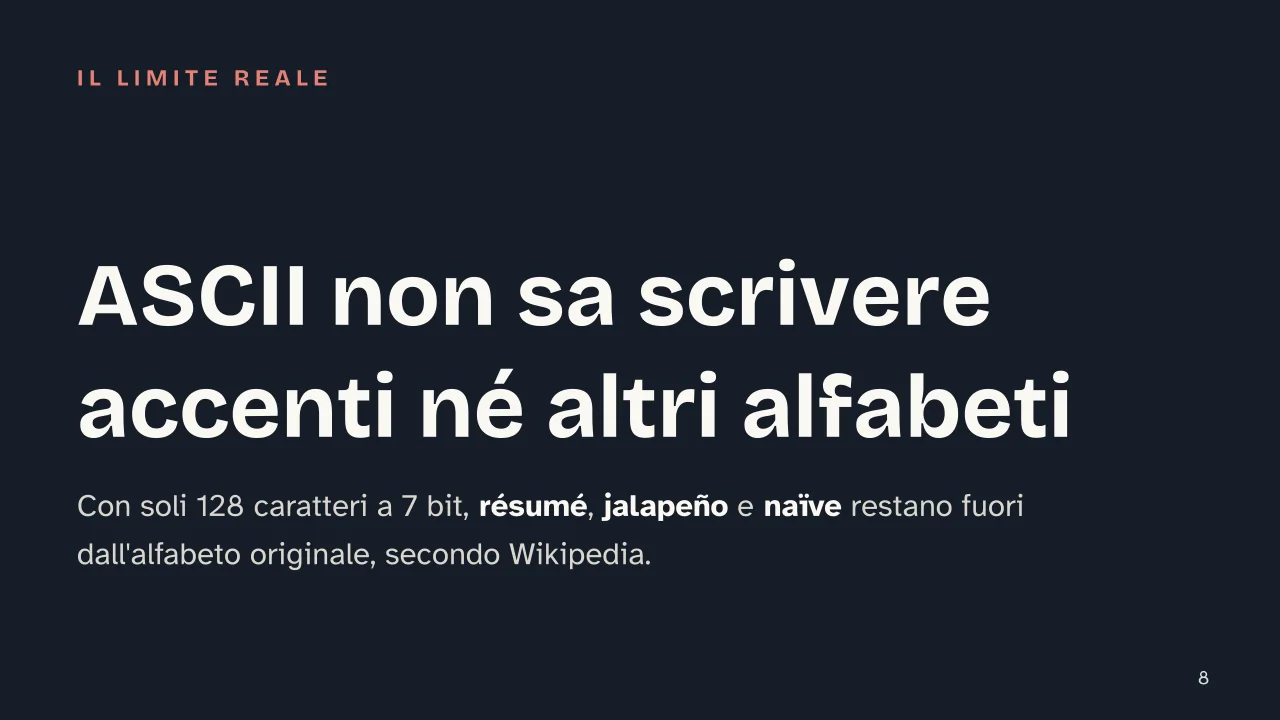  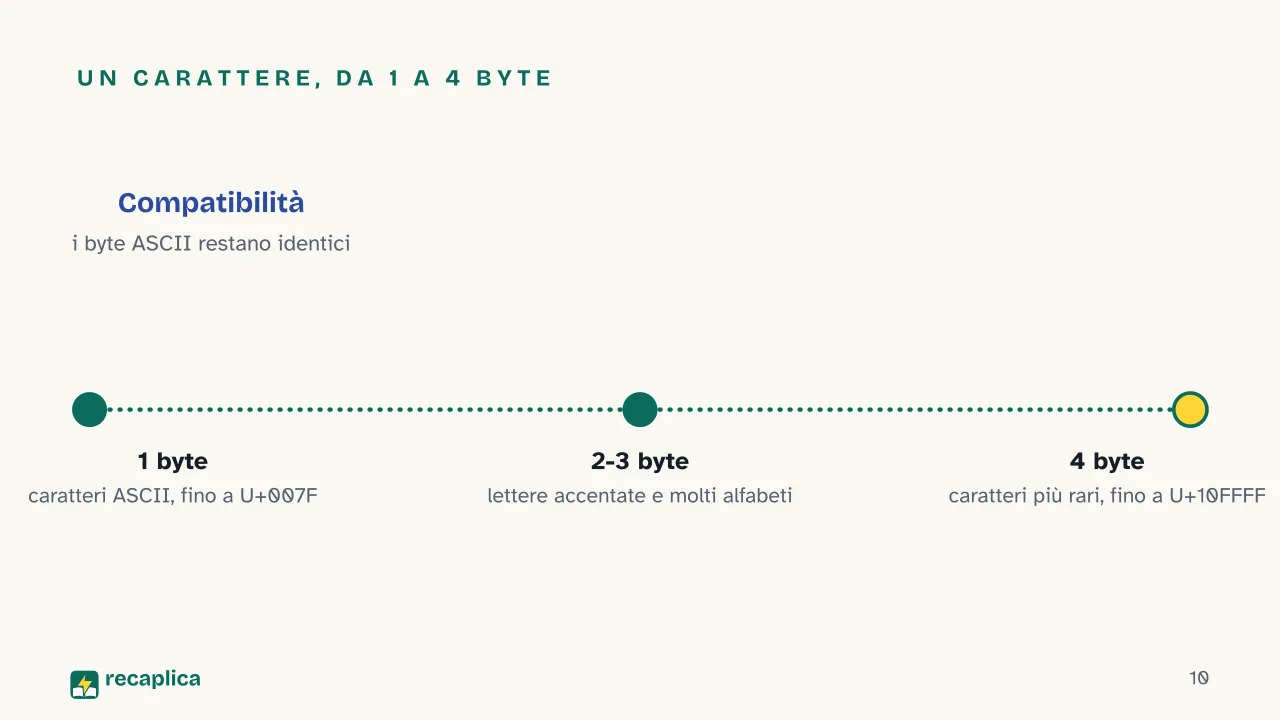 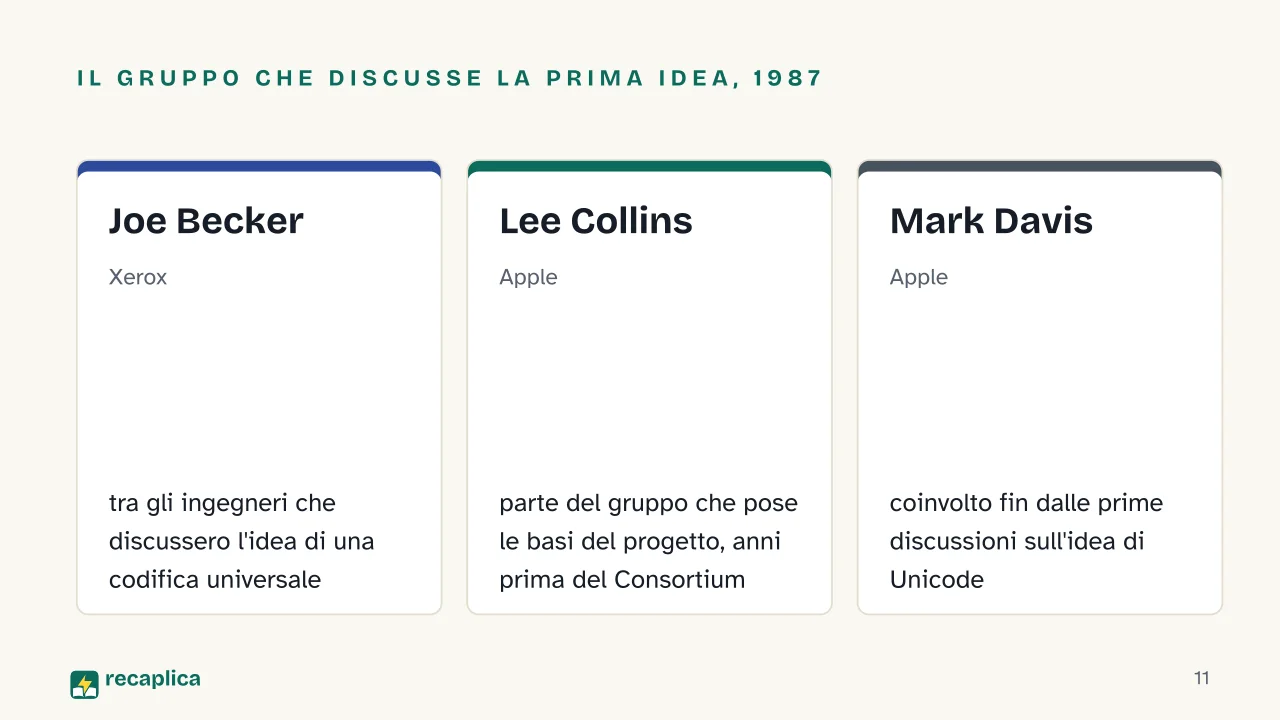  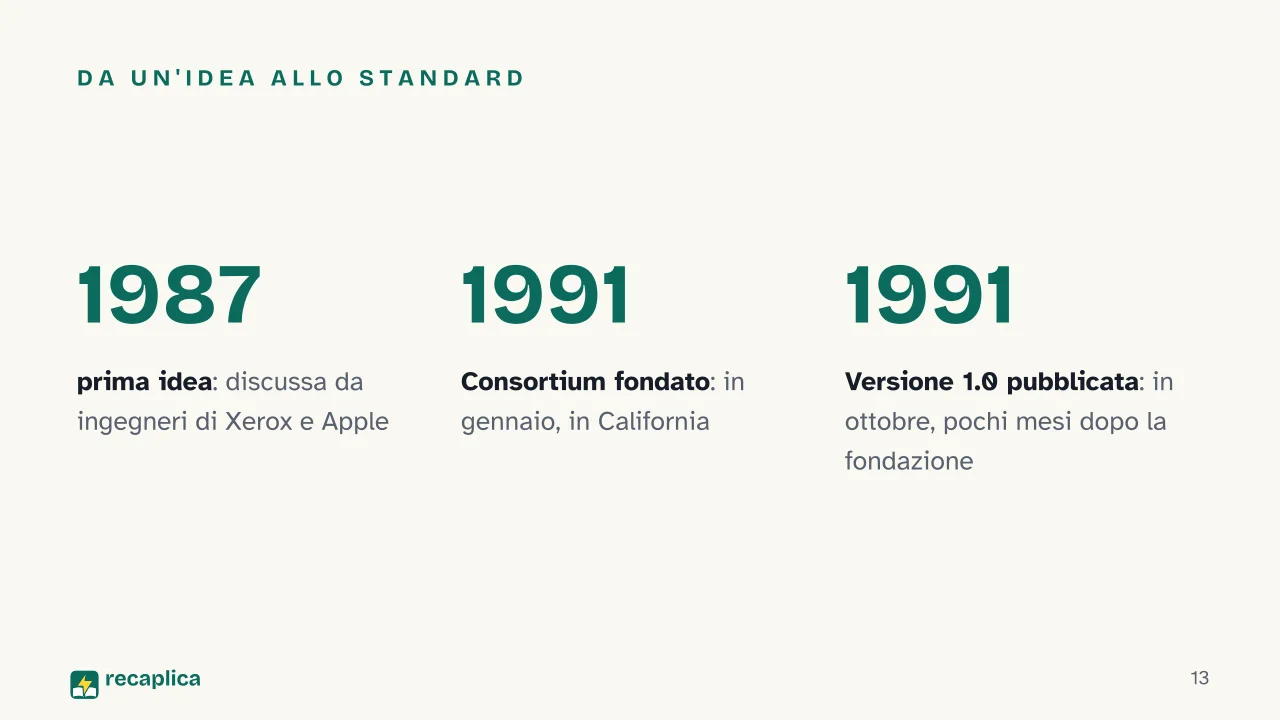 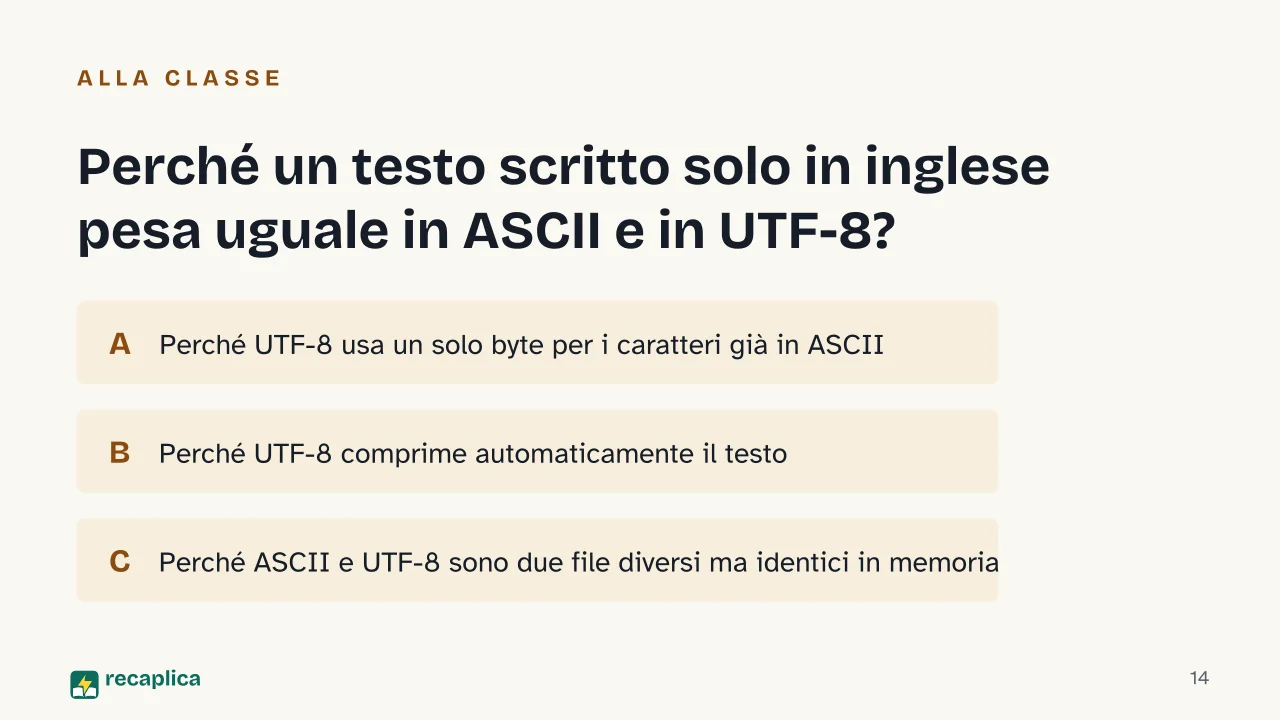  Falsi miti
Mappa concettualeTrascina lo sfondo per muoverti e i nodi per riposizionarli; usa − e + per chiudere e aprire i rami. 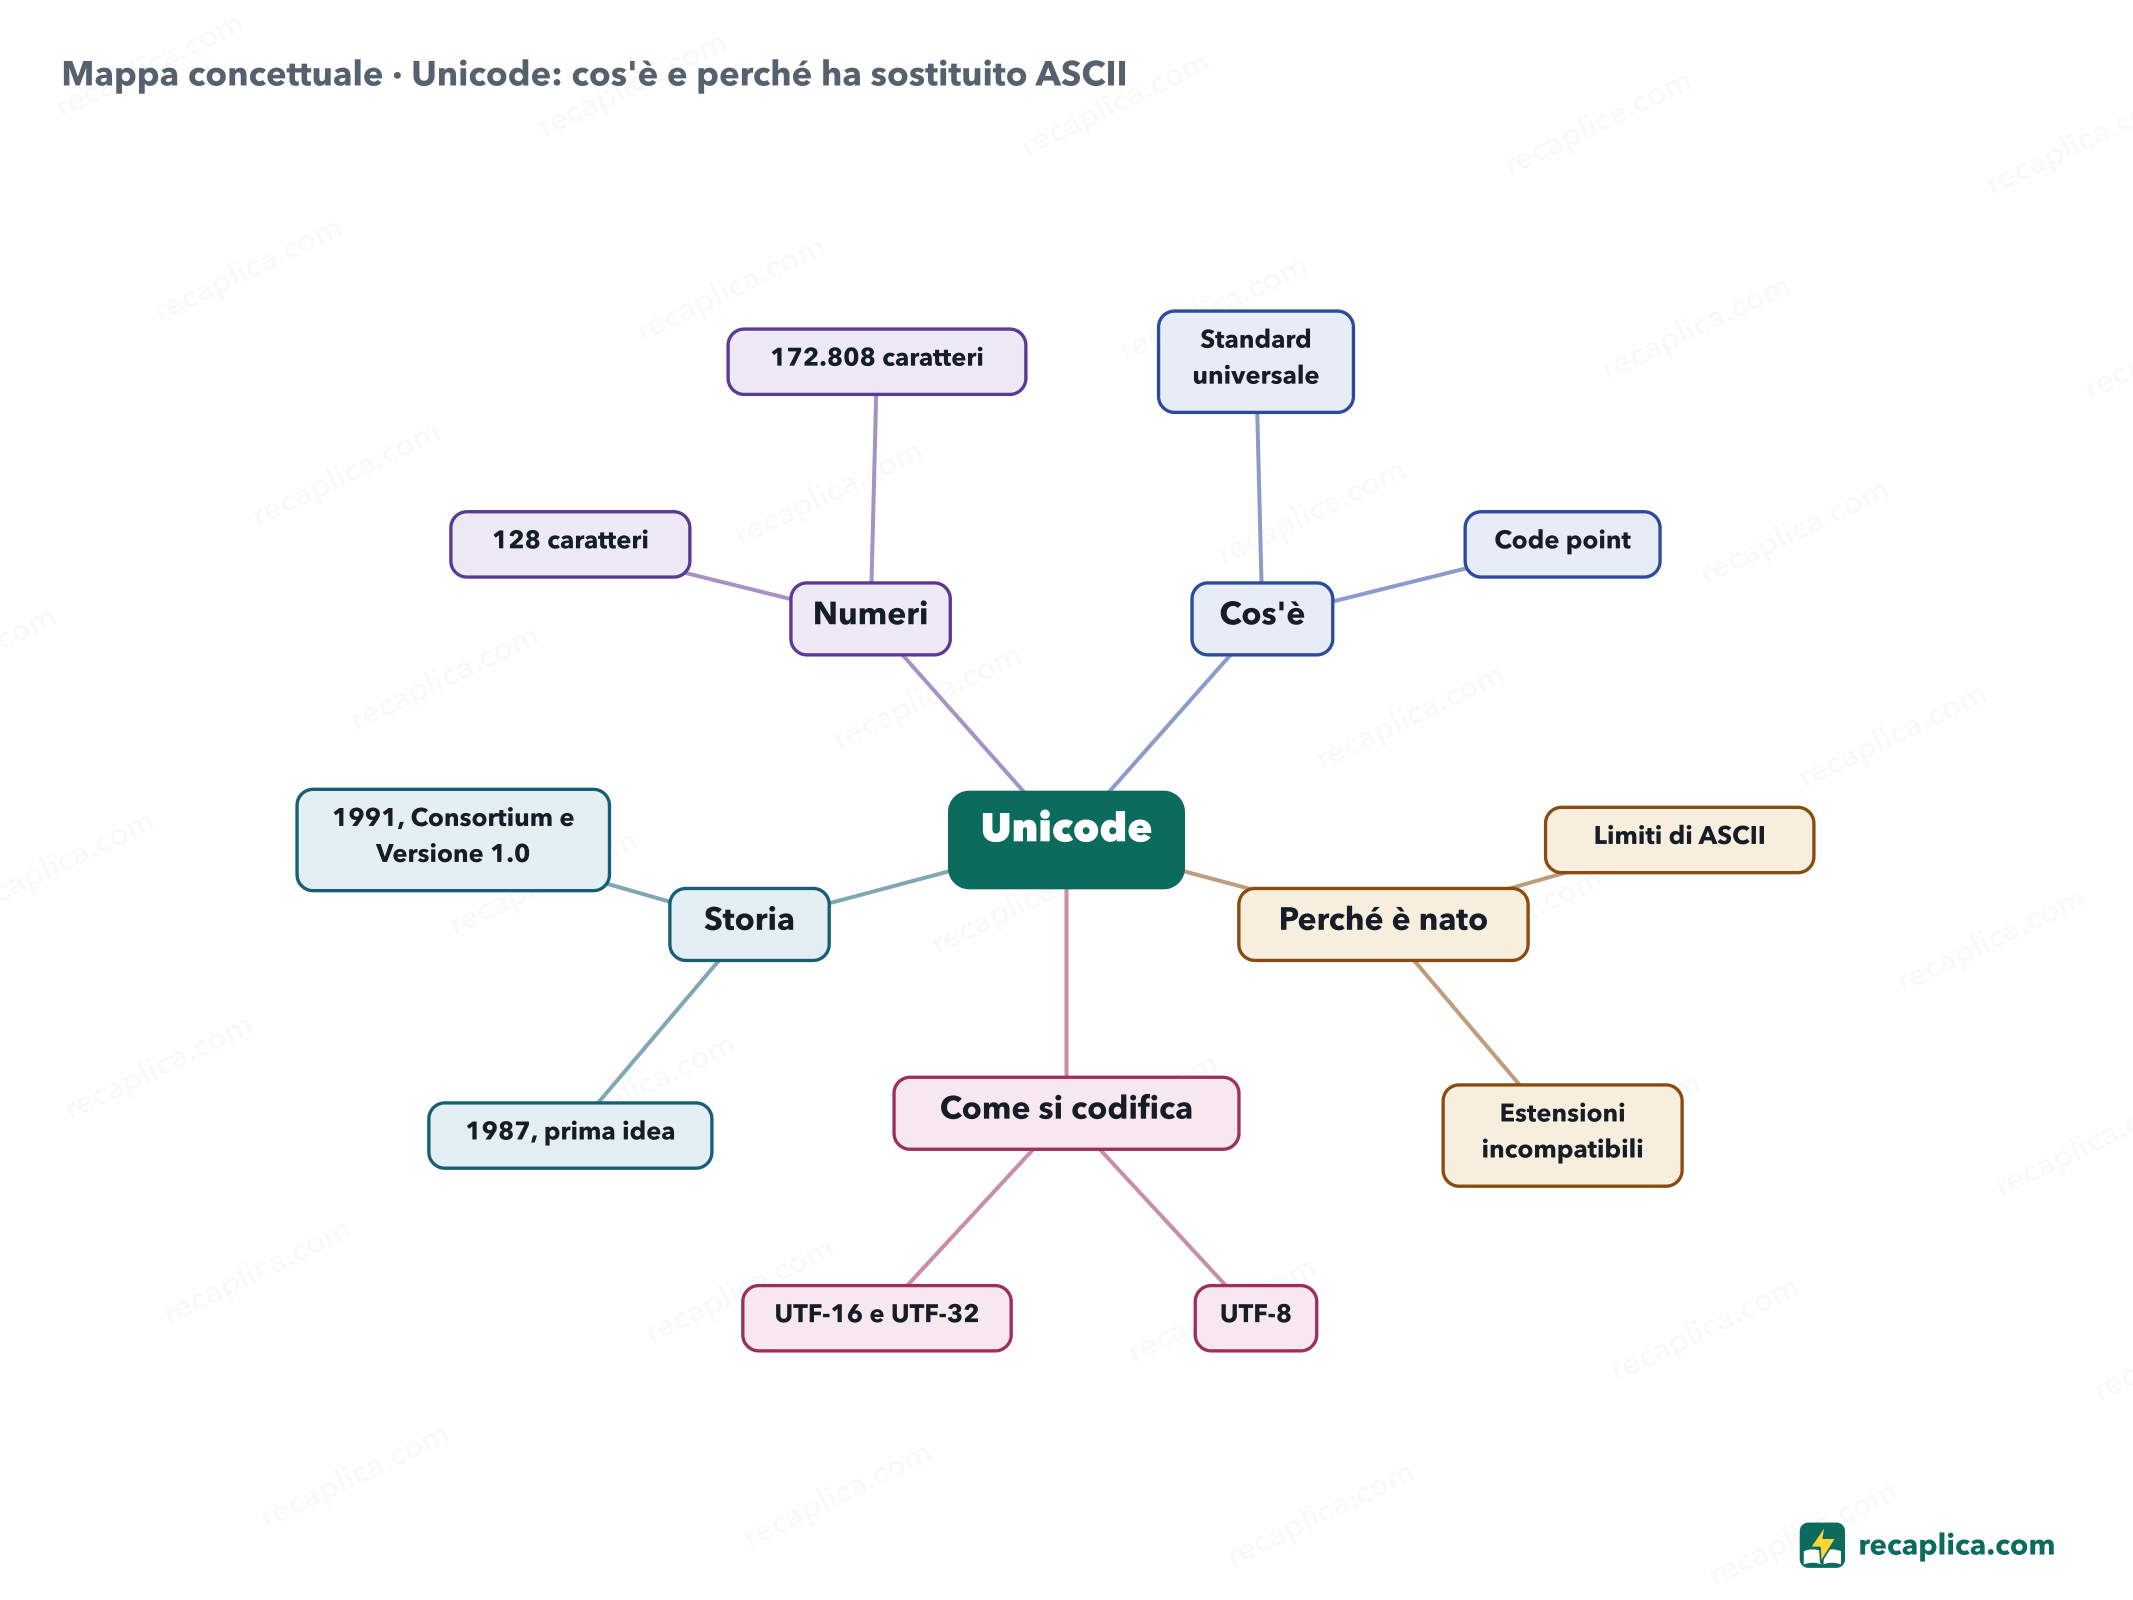
Quiz: mettiti alla provaRispondi alle domande per verificare quanto hai imparato: riceverai subito la correzione e una breve spiegazione. Voto 0/10 0/5
FlashcardsTocca la carta per girarla e verifica se ricordi la risposta, poi passa alla successiva. 1 / 7 Spiegalo con parole tueIl test definitivo: se sai spiegarlo con parole semplici, lo hai capito davvero. Scrivi la tua spiegazione, poi confrontala col Recap. La tua spiegazione resta salvata solo su questo dispositivo.
Domande e risposteUnicode e UTF-8 sono la stessa cosa?No. Unicode è lo standard che assegna un numero, il code point, a ogni carattere; UTF-8 è uno dei modi per tradurre quei numeri in byte da salvare o trasmettere. Esistono anche UTF-16 e UTF-32, altre forme di trasformazione dello stesso standard, secondo la FAQ del Consortium Unicode. Perché ASCII non bastava più?Perché con soli 128 caratteri a 7 bit copriva solo l'alfabeto inglese. Secondo Wikipedia, ASCII non supporta direttamente termini o nomi con segni diacritici come résumé, jalapeño o naïve, perché non ha code point per quelle lettere. Quanti byte occupa un carattere in UTF-8?Da 1 a 4, secondo l'RFC 3629: il numero di byte dipende da quanto è alto il code point del carattere, fino a coprire l'intervallo U+0000-U+10FFFF. Cosa significa la sigla ASCII?American Standard Code for Information Interchange. Fu pubblicato nel 1963, contemporaneamente all'introduzione del Teletype Model 33, secondo Wikipedia. Chi gestisce lo standard Unicode?Lo Unicode Consortium, l'organizzazione fondata nel gennaio 1991 in California, che mantiene e aggiorna lo standard: la versione 18.0, di settembre 2026, copre 172.808 caratteri. Ogni Recap passa da una revisione indipendente prima della pubblicazione. |