Salta al contenuto
recaplica

    Un attimo: controllo di sicurezza

    Cloudflare vuole assicurarsi che tu non sia un robot. Spunta la casella qui sotto e la ricerca riparte da sola.

    EN
    recaplica Database relazionali: come tabelle, righe e chiavi organizzano i dati
    © 2026 Recaplica · recaplica.com — Tutti i diritti riservati
    Home › Tecnologia

    Database relazionali: come tabelle, righe e chiavi organizzano i dati

    Di Redazione Recaplica · Aggiornato il 28 settembre 2026

    Cosa stampare

    Con "Margini: predefiniti" compaiono anche i numeri di pagina.

    Slide

    Scegli il taglio

    Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta14 slideTutti i capitoli e gli approfondimenti

    Tutte e due hanno le note del relatore.

    Canale Telegram
    recaplica Chiaro in 30 secondi, tuo in 10 minuti.
    In 30 secondi Punti chiave Numeri Approfondimento Presentazione Falsi miti Mappa concettuale Quiz Flashcards FAQ

    In 30 secondi lettura lampo

    Un database relazionale organizza i dati in tabelle, ciascuna dedicata a un tema, per esempio clienti o ordini. Ogni riga della tabella è un record, ogni colonna un campo con lo stesso tipo di informazione per tutte le righe. Una chiave primaria identifica in modo univoco ogni riga, mentre una chiave esterna la collega alle righe di un'altra tabella, così i dati restano coerenti senza essere ripetuti ovunque. Le tabelle si combinano secondo tre tipi di relazione, uno a uno, uno a molti, molti a molti, e si interrogano con SQL, il linguaggio standard di questi sistemi.

    Punti Chiave

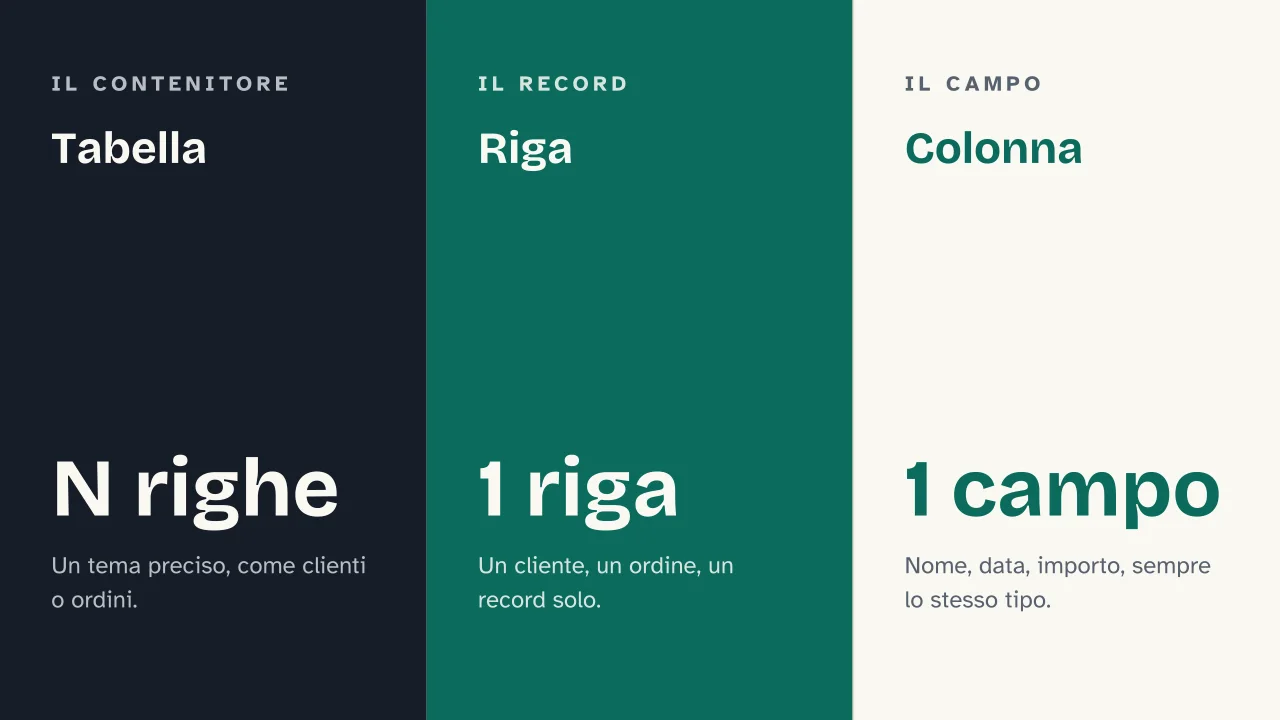
    • Una tabella raccoglie righe che condividono le stesse colonne, come un elenco strutturato di record.
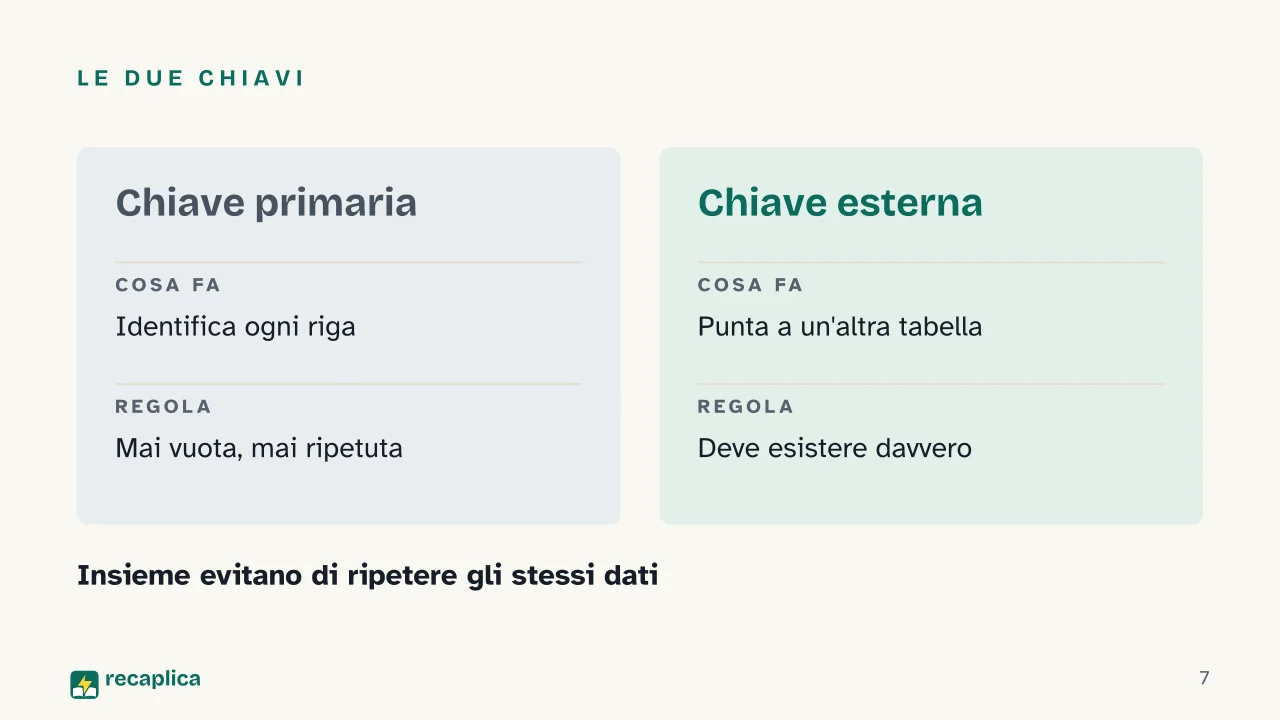
    • La chiave primaria identifica ogni riga in modo univoco e non può ripetersi né restare vuota.
    • La chiave esterna collega una tabella a un'altra, così i dati non si duplicano e restano coerenti.
    • Le relazioni tra tabelle sono di tre tipi, uno a uno, uno a molti, molti a molti.
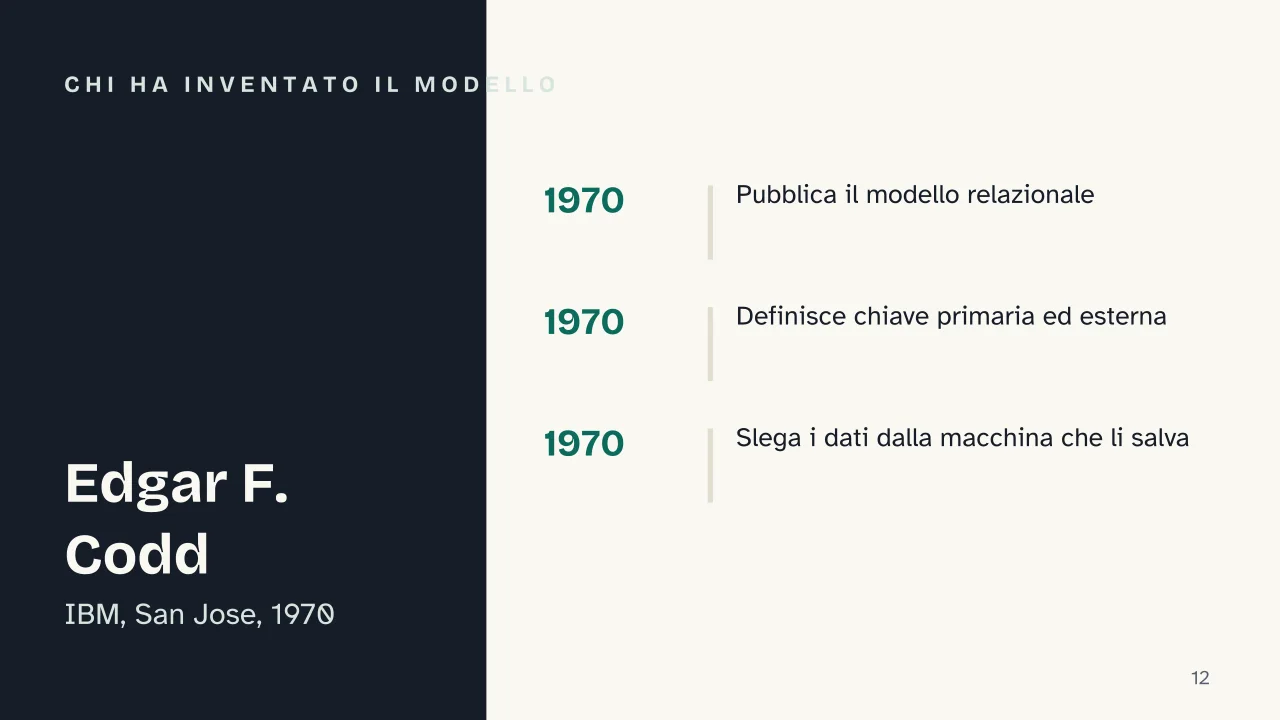
    • Il modello nasce nel 1970 dal lavoro di Edgar Codd, che voleva separare i dati dal modo in cui la macchina li archivia.
    • SQL è il linguaggio con cui si interrogano e si aggiornano i database relazionali.

    I numeri chiave

    • 1970 Anno di pubblicazione del paper di Edgar F. Codd che introduce il modello relazionale, con le definizioni di tabella, chiave primaria e chiave esterna. Fonte: E. F. Codd, Communications of the ACM

    L'Approfondimento

    Cos’è, in pratica, una tabella

    Secondo la documentazione ufficiale di PostgreSQL, una tabella è un insieme di righe identificato da un nome, e ogni riga condivide lo stesso insieme di colonne, ciascuna con un tipo di dato preciso. Una tabella clienti ha quindi una riga per ogni cliente, con colonne come nome, indirizzo e codice fiscale; una tabella ordini ha una riga per ogni ordine, con colonne come data, importo e il cliente che l’ha fatto. Le tabelle di un’applicazione si raggruppano in un database vero e proprio, gestito da un DBMS come PostgreSQL o MySQL.

    Esempio pratico: un negozio online tiene due tabelle, clienti e ordini. La tabella clienti ha una riga per ogni persona, con colonne come nome ed email. La tabella ordini ha una riga per ogni acquisto, con colonne come data, importo e una colonna che indica di chi è quell’ordine. Quella colonna contiene l’identificativo del cliente: basta quello per risalire al resto dei suoi dati.

    Le chiavi che tengono insieme i dati

    Ogni tabella ha una chiave primaria, un valore che identifica una riga e una sola. Secondo la documentazione di PostgreSQL, la chiave primaria richiede che i valori siano unici e mai nulli, e una tabella può averne al massimo una.

    La chiave esterna fa il lavoro opposto e complementare: non identifica le righe della propria tabella, ma punta alla chiave primaria di un’altra. Nella tabella ordini, la colonna che indica il cliente è una chiave esterna verso la tabella clienti, e contiene l’identificativo del cliente. Se si prova a inserire un ordine con un identificativo di cliente che non esiste, il sistema rifiuta l’operazione con un errore di violazione del vincolo: è così che il modello mantiene coerenti i dati tra tabelle diverse, senza bisogno di controlli manuali a ogni inserimento.

    Tre modi in cui le tabelle si collegano

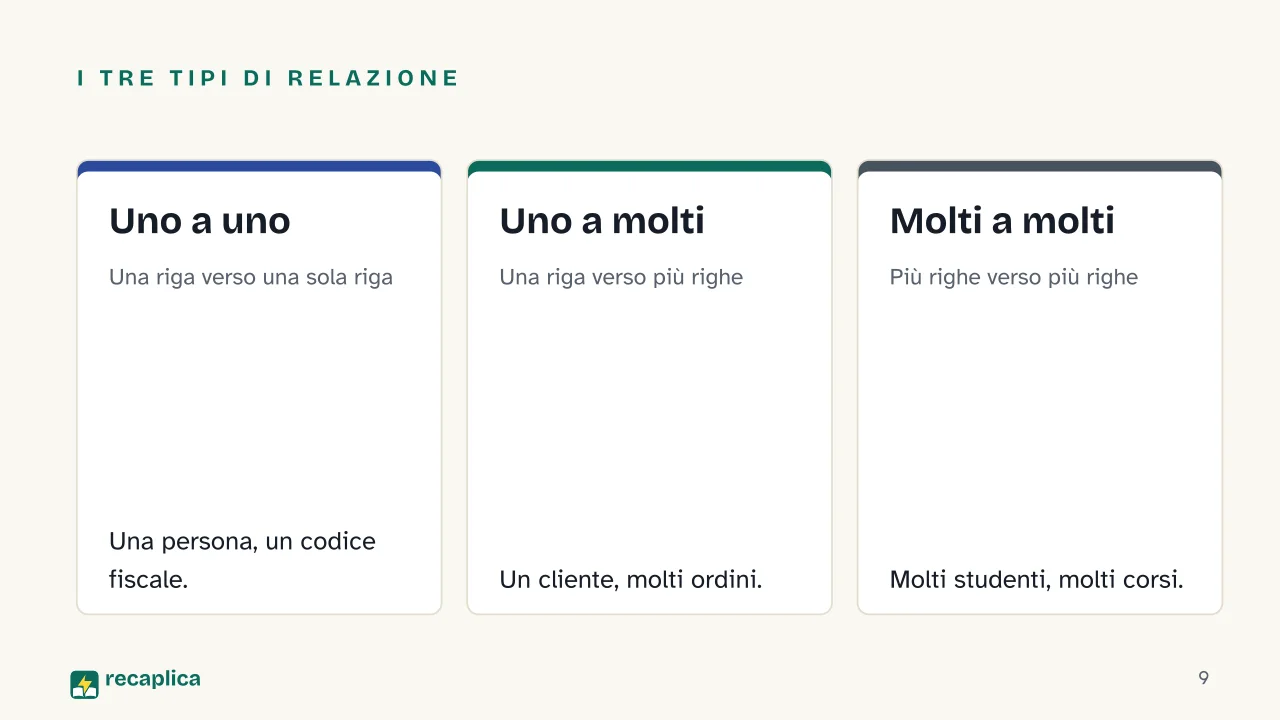
    Due tabelle possono collegarsi in tre modi diversi, a seconda di quante righe di una corrispondono a quante righe dell’altra.

    Tipo di relazioneCosa significaEsempio
    Uno a unoUna riga di una tabella corrisponde a una sola riga dell’altraUna persona e il suo codice fiscale
    Uno a moltiUna riga di una tabella si collega a più righe dell’altraUn cliente e i suoi ordini
    Molti a moltiPiù righe di una tabella si collegano a più righe dell’altraGli studenti e i corsi a cui sono iscritti

    Esempio pratico: in una tabella studenti e in una tabella corsi, uno studente può frequentare più corsi e un corso può avere più studenti iscritti. È una relazione molti a molti, diversa dal legame tra un cliente e i suoi ordini, dove ogni ordine appartiene a un solo cliente pur essendoci più ordini per lo stesso cliente.

    Da dove viene questo modello

    Il modello relazionale nasce nel 1970, quando Edgar F. Codd, ricercatore ai laboratori IBM di San Jose, pubblica su Communications of the ACM il paper che lo descrive. Nell’introduzione, Codd applica la teoria matematica delle relazioni alla gestione di grandi archivi di dati condivisi, con un obiettivo preciso: chi usa i dati non deve sapere come sono organizzati fisicamente nella macchina. È in quel testo che compaiono i termini che il modello porta dal 1970, relazione per tabella, tupla per riga, dominio per colonna, insieme alle definizioni di chiave primaria e chiave esterna. Codd sosteneva che il modello relazionale fosse superiore ai modelli gerarchico e a rete allora diffusi, perché descrive i dati secondo la loro struttura naturale, senza aggiungere strutture pensate solo per la macchina che li conserva.

    SQL, il linguaggio per interrogare i dati

    I database relazionali si interrogano con SQL, il linguaggio che DBMS come PostgreSQL implementano in gran parte per creare tabelle, inserire righe ed eseguire ricerche. Un sito scritto in PHP o in JavaScript parla con il database proprio tramite SQL, ed è quello che rende il web capace di ricordare ogni cliente, ogni ordine, ogni pagina visitata. Anche i dataset usati per il machine learning partono spesso da tabelle relazionali, prima di essere trasformati per l’addestramento.

    Lo schema fisso che regge questo modello non va bene per ogni caso d’uso: database relazionali e non relazionali a confronto spiega quando conviene invece un database NoSQL come MongoDB o Redis.

    Presentazione

    Slide pronte da scaricare e fare tue in PowerPoint o Google Slides, con le note del relatore. Scegli il taglio Lampo o quello Completo.
    Slide 1 della presentazione su Database relazionali: Database relazionaliSlide 2 della presentazione su Database relazionali: Come sa un sistema quale cliente ha fatto un ordine?Slide 3 della presentazione su Database relazionali: Il percorsoSlide 4 della presentazione su Database relazionali: Capitolo 01: Tabelle e righeSlide 5 della presentazione su Database relazionali: Tabella · Riga · ColonnaSlide 6 della presentazione su Database relazionali: Capitolo 02: Le chiaviSlide 7 della presentazione su Database relazionali: Le due chiaviSlide 8 della presentazione su Database relazionali: Capitolo 03: Le relazioni tra tabelleSlide 9 della presentazione su Database relazionali: I tre tipi di relazione: Uno a uno, Uno a molti, Molti a moltiSlide 10 della presentazione su Database relazionali: La chiave esterna non copia l'intera rigaSlide 11 della presentazione su Database relazionali: Capitolo 04: Da Codd a SQLSlide 12 della presentazione su Database relazionali: Chi ha inventato il modelloSlide 13 della presentazione su Database relazionali: Un cliente può fare più ordini, ma un ordine ha un solo cliente, che relazione è?Slide 14 della presentazione su Database relazionali: Continua a leggere
    Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta14 slideTutti i capitoli e gli approfondimenti

    Falsi miti

    • ✗ Mito Un database relazionale è solo un foglio di calcolo con più fogli.

      ✓ Realtà Un foglio di calcolo lascia libero chi lo compila di scrivere quello che vuole in ogni cella. Un database relazionale impone i vincoli delle chiavi, una chiave esterna che punta a una riga inesistente viene rifiutata dal sistema, non solo segnalata.

    • ✗ Mito Le righe di una tabella stanno in un ordine preciso, di solito quello di inserimento.

      ✓ Realtà SQL non garantisce alcun ordine delle righe in una tabella. Se serve un ordine per la visualizzazione, va chiesto esplicitamente nella query, perché il modello organizza i dati per struttura logica, non per sequenza di inserimento.

    • ✗ Mito Una chiave esterna copia i dati dell'altra tabella dentro la propria.

      ✓ Realtà La chiave esterna copia solo il valore della chiave primaria collegata, per esempio un identificativo cliente, non l'intera riga. Evitare quella duplicazione è proprio il motivo per cui il modello relazionale è nato.

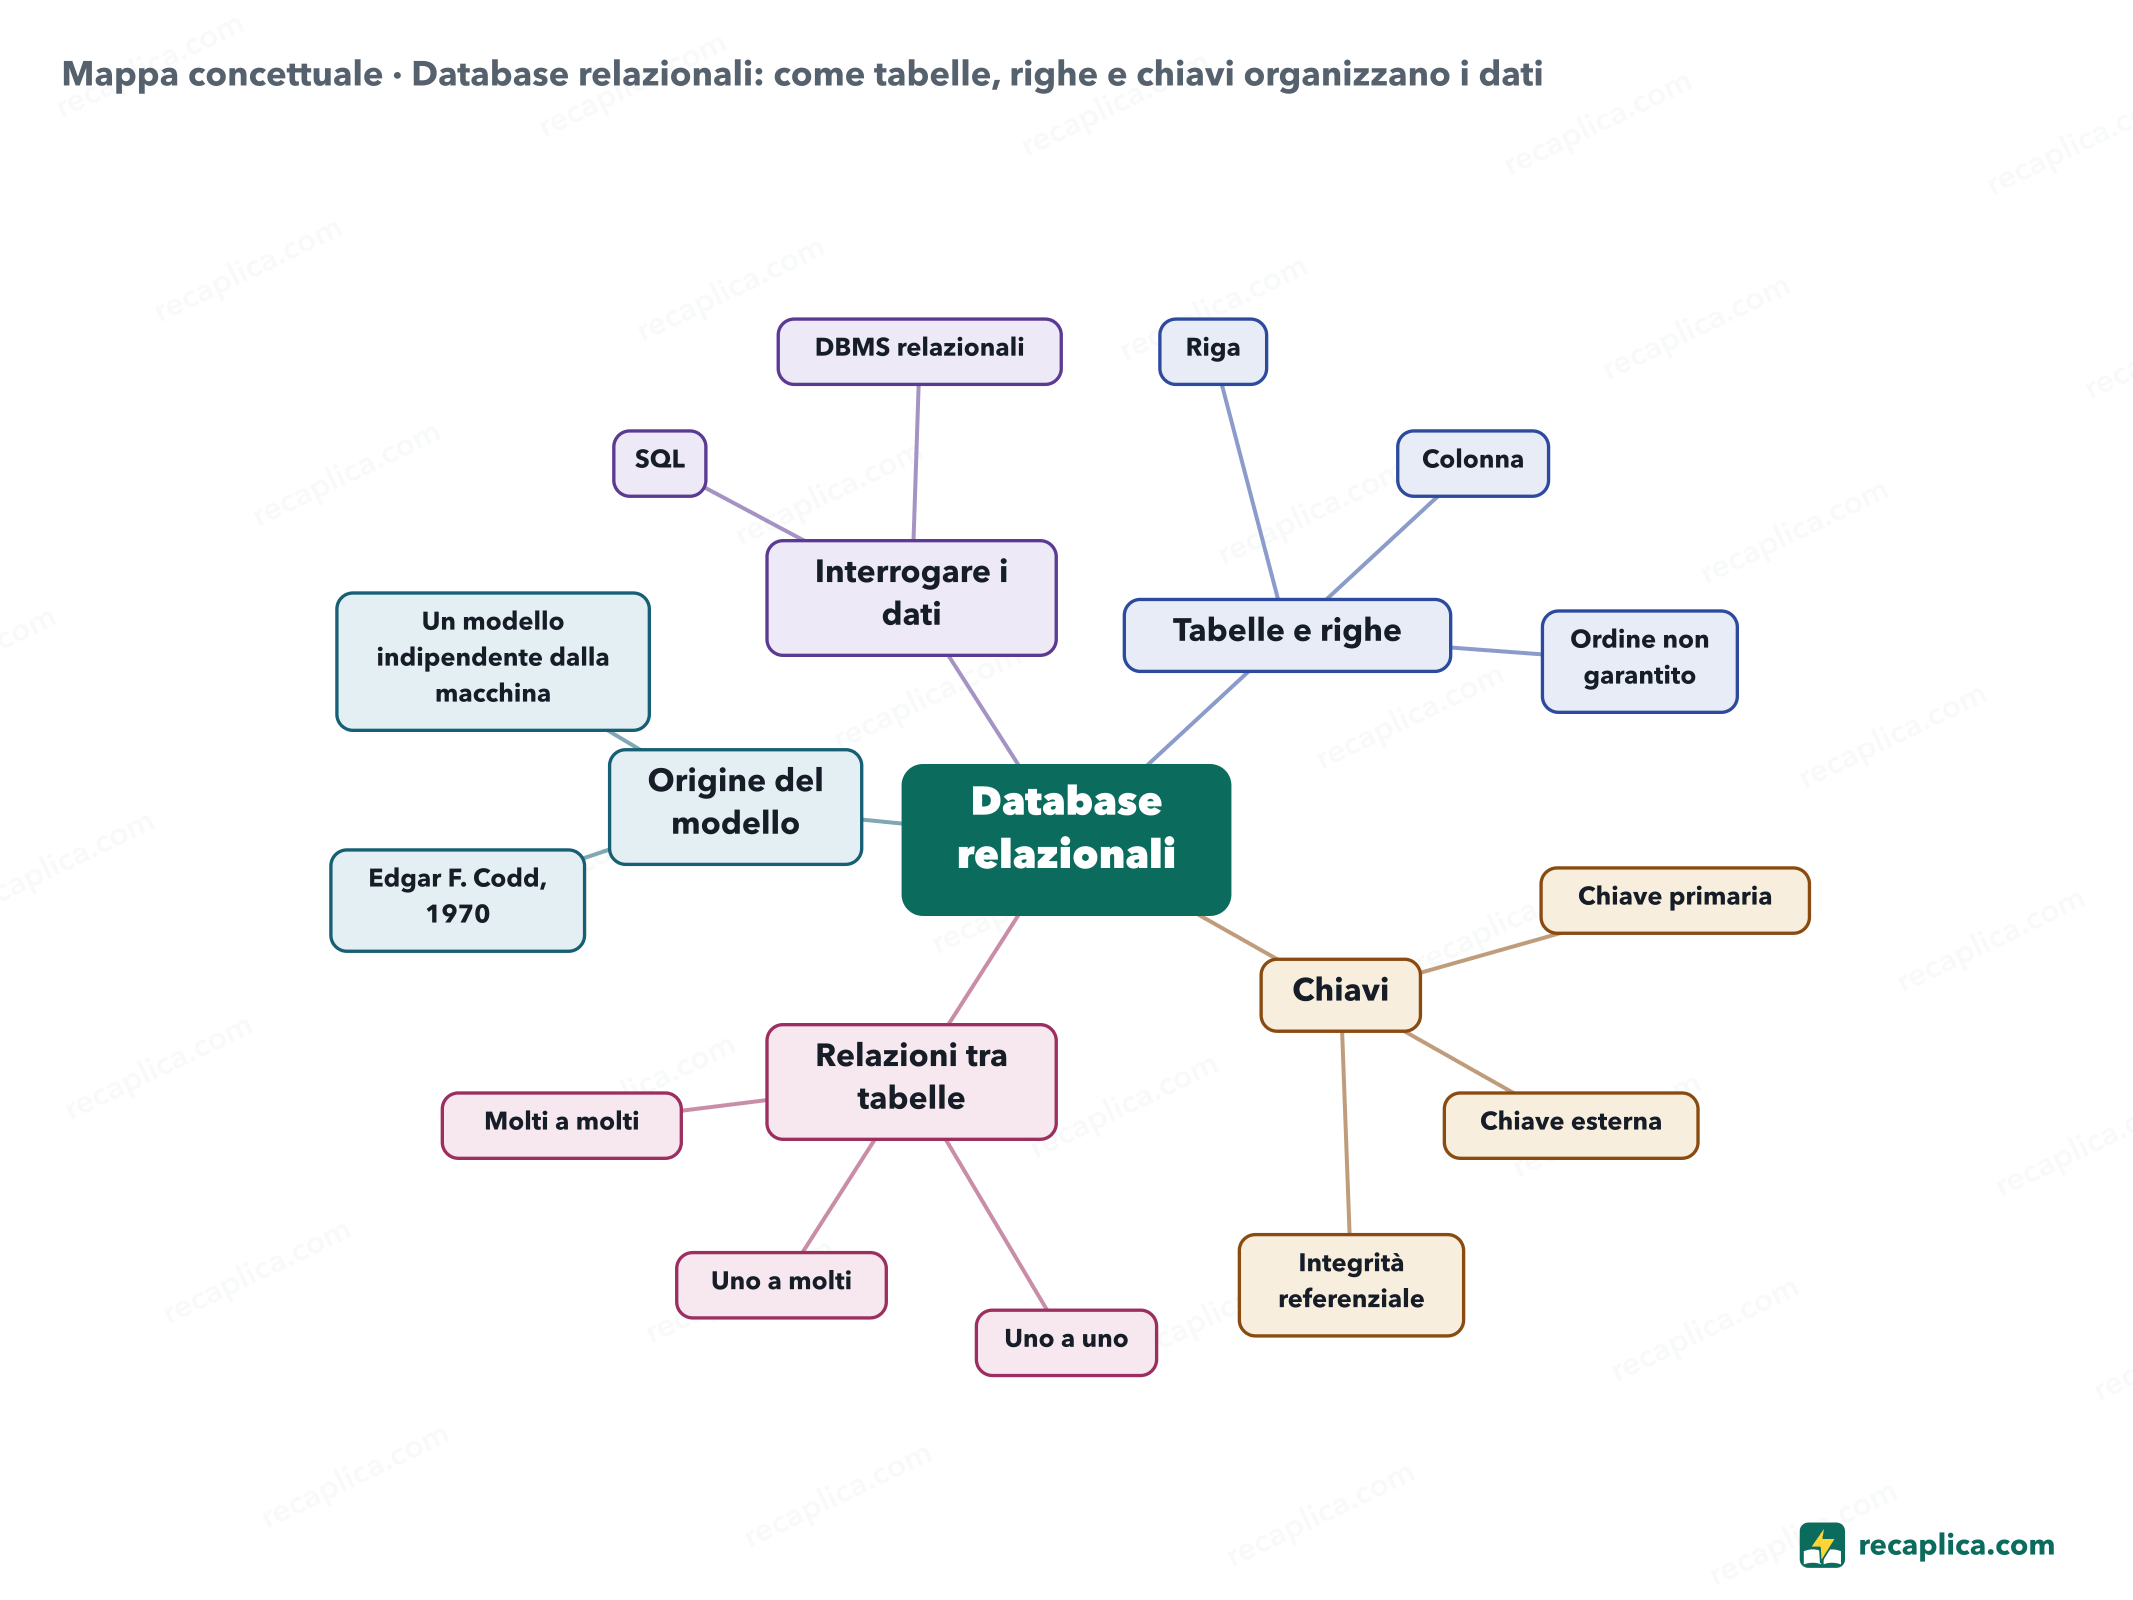
    Mappa concettuale

    Trascina lo sfondo per muoverti e i nodi per riposizionarli; usa − e + per chiudere e aprire i rami.
    Personalizza
    Mappa concettuale: Database relazionali: come tabelle, righe e chiavi organizzano i dati
    • Database relazionali
      • Tabelle e righe
        • Riga un record, un cliente o un ordine specifico
        • Colonna un campo, con lo stesso tipo di dato in ogni riga
        • Ordine non garantito SQL non promette un ordine fisso delle righe
      • Chiavi
        • Chiave primaria identifica ogni riga, unica e mai vuota
        • Chiave esterna punta alla chiave primaria di un'altra tabella
        • Integrità referenziale il sistema rifiuta i riferimenti a righe inesistenti
      • Relazioni tra tabelle
        • Uno a uno una riga corrisponde a una sola riga dell'altra
        • Uno a molti una riga si collega a più righe dell'altra
        • Molti a molti più righe si collegano a più righe dell'altra
      • Origine del modello
        • Edgar F. Codd, 1970 ricercatore IBM, autore del paper fondativo
        • Un modello indipendente dalla macchina chi usa i dati non deve sapere come sono archiviati
      • Interrogare i dati
        • SQL il linguaggio standard delle interrogazioni
        • DBMS relazionali i sistemi che gestiscono database relazionali, come PostgreSQL

    Quiz: mettiti alla prova

    Rispondi alle domande per verificare quanto hai imparato: riceverai subito la correzione e una breve spiegazione.

    Voto 0/10 0/5
    1 In un database relazionale, cos'è una "relazione" nel senso tecnico del termine?

    Nel modello descritto da Edgar Codd nel 1970, relazione è il termine matematico usato per indicare una tabella, righe e colonne organizzate secondo regole precise.

    2 Che caratteristica deve avere sempre la chiave primaria di una tabella?

    La chiave primaria identifica ogni riga in modo univoco, i suoi valori devono essere unici e non possono essere nulli, altrimenti perderebbe la sua funzione.

    3 A cosa serve una chiave esterna?

    La chiave esterna è una colonna, o un gruppo di colonne, che contiene i valori della chiave primaria di un'altra tabella: è così che le tabelle restano collegate senza duplicare i dati.

    4 Uno studente può iscriversi a più corsi e un corso può avere più studenti iscritti. Che tipo di relazione è?

    Quando entrambe le tabelle possono avere più corrispondenze reciproche, più studenti per corso e più corsi per studente, la relazione è molti a molti.

    5 Vero o falso, SQL garantisce che le righe di una tabella restino sempre nello stesso ordine in cui sono state inserite.

    È falso, SQL non garantisce alcun ordine delle righe in una tabella. Per ottenere un ordine specifico bisogna chiederlo esplicitamente nella query.

    Risposte: 1-A · 2-A · 3-A · 4-A · 5-B

    Flashcards

    Tocca la carta per girarla e verifica se ricordi la risposta, poi passa alla successiva.

    1 / 8

    Spiegalo con parole tue

    Il test definitivo: se sai spiegarlo con parole semplici, lo hai capito davvero. Scrivi la tua spiegazione, poi confrontala col Recap.

    La tua spiegazione resta salvata solo su questo dispositivo.

    Un database relazionale organizza i dati in tabelle, ciascuna dedicata a un tema, per esempio clienti o ordini. Ogni riga della tabella è un record, ogni colonna un campo con lo stesso tipo di informazione per tutte le righe. Una chiave primaria identifica in modo univoco ogni riga, mentre una chiave esterna la collega alle righe di un'altra tabella, così i dati restano coerenti senza essere ripetuti ovunque. Le tabelle si combinano secondo tre tipi di relazione, uno a uno, uno a molti, molti a molti, e si interrogano con SQL, il linguaggio standard di questi sistemi.

    Domande e risposte

    Che differenza c'è tra una tabella e una relazione, nel gergo dei database?

    Nessuna nella sostanza. Nel modello descritto da Edgar Codd nel 1970, relazione è il termine tecnico per tabella, mentre riga e colonna indicano rispettivamente ogni record e ogni campo che lo compone.

    A cosa serve la chiave primaria di una tabella?

    Identifica in modo univoco ogni riga della tabella, non può essere vuota e non può ripetersi, così ogni record si distingue da tutti gli altri anche quando due righe hanno valori simili.

    Cosa succede se provo a inserire una riga con una chiave esterna che non esiste nell'altra tabella?

    Il sistema rifiuta l'inserimento con un errore di violazione del vincolo, perché la chiave esterna deve sempre puntare a un valore realmente presente nella tabella collegata: è il meccanismo che mantiene coerenti i dati tra tabelle diverse.

    Con quale linguaggio si interrogano i database relazionali?

    Con SQL, il linguaggio standard che i sistemi di gestione relazionali, come PostgreSQL, implementano in gran parte per creare tabelle, inserire righe ed eseguire ricerche.

    Qual è il modo più semplice per farsi uno schema di un database relazionale?

    Partire dalle tabelle dell'argomento, per esempio clienti e ordini, scrivere sotto ciascuna le colonne principali e poi segnare quale colonna di chiave esterna punta alla chiave primaria dell'altra tabella: è lo schema alla base della mappa concettuale di questo Recap.

    Fonti consultate

    • Codd, E. F. — A Relational Model of Data for Large Shared Data Banks (Communications of the ACM, 1970)
    • PostgreSQL Documentation — 3.1. Introduction (Concepts)
    • PostgreSQL Documentation — 3.3. Foreign Keys
    • PostgreSQL Documentation — 5.5. Constraints
    • MIT 11.521 — Relational Database Design
    • PostgreSQL Documentation — 1.1. What is PostgreSQL?

    Ogni Recap passa da una revisione indipendente prima della pubblicazione.

    Ogni sera, i nuovi Recap del giorno sul canale Telegram. Iscriviti al canale →

    Continua a imparare

    • Tecnologia Database relazionali e non relazionali: differenze ed esempi pratici Un database relazionale organizza i dati in tabelle con uno schema fisso, deciso prima di scrivere la prima riga. Un database non relazionale, o NoSQL, usa invece schemi flessibili pensati per un modello di dati specifico: documenti come in MongoDB, coppie chiave-valore come in Redis, colonne partizionate come in Apache Cassandra, nodi collegati da relazioni come in Neo4j. I database NoSQL nascono verso la fine degli anni 2000, quando il costo dello storage cala e cresce il bisogno di sistemi distribuiti su più macchine. La scelta tra i due modelli dipende dal tipo di dato e dal caso d'uso, non da quale sia genericamente più veloce o più scalabile: entrambi possono crescere, in modi diversi, e il teorema CAP spiega il compromesso che ogni sistema distribuito affronta quando la rete tra i suoi nodi si interrompe. Leggi il Recap →
    • Tecnologia DBMS: cos'è, i tipi principali e alcuni esempi Un DBMS, sigla di database management system, è il software che permette di creare, interrogare e aggiornare i dati di un database, senza che chi lo usa debba sapere come sono salvati fisicamente. Rispetto a fogli di calcolo o archivi di file, centralizza i dati e li rende più coerenti, riducendo duplicazioni e problemi di sicurezza. Il tipo più diffuso è il modello relazionale, che organizza i dati in tabelle collegate da chiavi e si interroga con SQL. Esistono anche DBMS non relazionali, o NoSQL, pensati per dati più flessibili, e due modelli più antichi, quello gerarchico e quello a rete, oltre al modello orientato a oggetti. Leggi il Recap →
    • Tecnologia Diagramma entità relazione: cos'è e come si costruisce Un diagramma entità-relazione (o diagramma ER) è la mappa che si disegna prima di costruire un database: mostra quali oggetti servono tracciare (le entità), quali informazioni li descrivono (gli attributi) e come sono collegati tra loro (le relazioni). Serve a capire la struttura dei dati prima ancora di scrivere le tabelle, ed è un passaggio di progettazione concettuale, non lo schema finale del database. Le due notazioni più diffuse per disegnarlo sono quella di Chen, con rettangoli e ovali, e quella Crow's Foot, con linee e piedi di corvo che indicano quante istanze si collegano tra loro. Una relazione può essere uno a uno, uno a molti o molti a molti, e ogni tipo ha un modo proprio di essere disegnato. Leggi il Recap →

    recaplica

    Chiaro in 30 secondi, tuo in 10 minuti.

    I Recap Mappe concettuali Chiedi un Recap Canale Telegram Crea una mappa concettuale Il metodo Chi siamo Privacy e cookie Note legali e condizioni d'uso

    © 2026 Recaplica · Un progetto di Curi S.r.l. — P. IVA 05472000750

    Statistiche, solo se vuoi

    Per capire quali Recap aiutano di più useremmo Google Analytics, con dati aggregati e anonimi. Parte solo col tuo ok, e puoi cambiare idea quando vuoi. Informativa privacy