Salta al contenuto
recaplica

    Un attimo: controllo di sicurezza

    Cloudflare vuole assicurarsi che tu non sia un robot. Spunta la casella qui sotto e la ricerca riparte da sola.

    EN
    recaplica Database relazionali e non relazionali: differenze ed esempi pratici
    © 2026 Recaplica · recaplica.com — Tutti i diritti riservati
    Home › Tecnologia

    Database relazionali e non relazionali: differenze ed esempi pratici

    Di Redazione Recaplica · Aggiornato il 28 settembre 2026

    Cosa stampare

    Con "Margini: predefiniti" compaiono anche i numeri di pagina.

    Slide

    Scegli il taglio

    Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta14 slideTutti i capitoli e gli approfondimenti

    Tutte e due hanno le note del relatore.

    Canale Telegram
    recaplica Chiaro in 30 secondi, tuo in 10 minuti.
    In 30 secondi Punti chiave Numeri Approfondimento Presentazione Falsi miti Mappa concettuale Quiz Flashcards FAQ

    In 30 secondi lettura lampo

    Un database relazionale organizza i dati in tabelle con uno schema fisso, deciso prima di scrivere la prima riga. Un database non relazionale, o NoSQL, usa invece schemi flessibili pensati per un modello di dati specifico: documenti come in MongoDB, coppie chiave-valore come in Redis, colonne partizionate come in Apache Cassandra, nodi collegati da relazioni come in Neo4j. I database NoSQL nascono verso la fine degli anni 2000, quando il costo dello storage cala e cresce il bisogno di sistemi distribuiti su più macchine. La scelta tra i due modelli dipende dal tipo di dato e dal caso d'uso, non da quale sia genericamente più veloce o più scalabile: entrambi possono crescere, in modi diversi, e il teorema CAP spiega il compromesso che ogni sistema distribuito affronta quando la rete tra i suoi nodi si interrompe.

    Punti Chiave

    • Un database relazionale ha uno schema fisso, uguale per ogni riga di una tabella; un database NoSQL ha uno schema flessibile, pensato per un modello di dati specifico.
    • I quattro modelli NoSQL principali sono documentale, chiave-valore, a colonne larghe e a grafo, ciascuno adatto a un tipo di problema diverso.
    • I database NoSQL emergono verso la fine degli anni 2000; MongoDB e CouchDB, due database documentali, arrivano nel 2009, secondo MongoDB.
    • Secondo MongoDB, i database NoSQL sono progettati per scalare sia verticalmente sia orizzontalmente, mentre i database relazionali sono pensati per la scalabilità verticale con una capacità limitata di estendersi anche in orizzontale.
    • Il teorema CAP descrive il compromesso tra consistenza e disponibilità che un sistema distribuito affronta quando la comunicazione tra i nodi si interrompe; alcuni sistemi, come MongoDB, sono configurabili tra i due comportamenti.
    • In un database documentale, due voci della stessa raccolta non devono avere per forza gli stessi campi: la struttura resta, cambia soltanto da un caso all'altro.

    I numeri chiave

    • 2009 Anno in cui, secondo MongoDB, i database NoSQL documentali MongoDB e CouchDB si affermano tra i primi a diffondersi. Fonte: MongoDB — NoSQL Explained
    • fine anni 2000 Periodo in cui i database NoSQL emergono, quando il costo dello storage cala in modo netto. Fonte: MongoDB — NoSQL Explained

    L'Approfondimento

    Due modi di organizzare i dati

    Un database relazionale parte da uno schema deciso in anticipo: tabelle con colonne fisse, uguali per ogni riga, collegate da chiavi primarie ed esterne. Un database non relazionale, o NoSQL, parte invece dal problema da risolvere: sceglie un modello di dati specifico, documenti, coppie chiave-valore, colonne partizionate o grafi, e adatta lo schema a quel modello. Secondo AWS, i database NoSQL sono spesso descritti come database “purpose-built”, pensati cioè per uno scopo preciso, con schemi flessibili che si adattano più facilmente delle tabelle relazionali alle applicazioni moderne.

    Non è un confronto tra un modello superato e uno nuovo: nessuno dei due sostituisce l’altro in ogni caso. È piuttosto una scelta che dipende dalla forma dei dati, da quanto serve scalare e da quanta rigidità di struttura conviene avere fin dall’inizio.

    I quattro modelli principali del mondo NoSQL

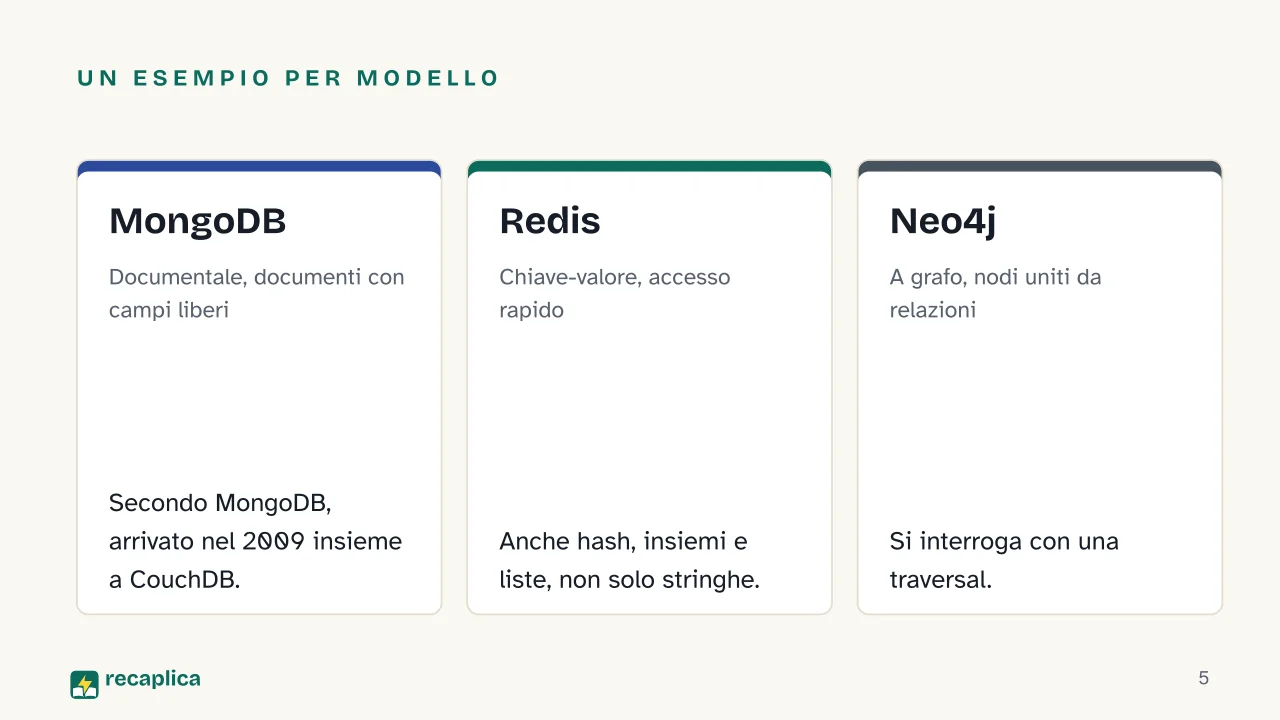
    AWS descrive tre di questi modelli con un prodotto reale a testa. Il database documentale archivia i dati come documenti simili a oggetti JSON, flessibili e semi-strutturati; MongoDB è un esempio noto di questo modello. Il database chiave-valore associa ogni valore a una chiave ed è, secondo AWS, altamente partizionabile, capace di scalare orizzontalmente a un livello che altri tipi di NoSQL non raggiungono facilmente: Amazon DynamoDB, per esempio, punta a offrire prestazioni costanti con latenze di pochi millisecondi a qualunque scala di traffico. Il database a grafo, come Neo4j, è pensato per applicazioni che lavorano con dati fortemente connessi tra loro. Un quarto modello molto diffuso è quello a colonne larghe, che partiziona le tabelle secondo una chiave di partizione: ne è un esempio Apache Cassandra.

    Esempio pratico: in un database a grafo, una domanda come “che musica ascoltano i miei amici che io non ho ancora?” si risolve con una traversal, la query che attraversa nodi e relazioni per trovare la risposta. In una tabella relazionale la stessa domanda richiederebbe più join tra tabelle diverse; nel grafo, amici, ascolti e brani sono già nodi collegati da relazioni dirette.

    Uno schema flessibile, non un’assenza di schema

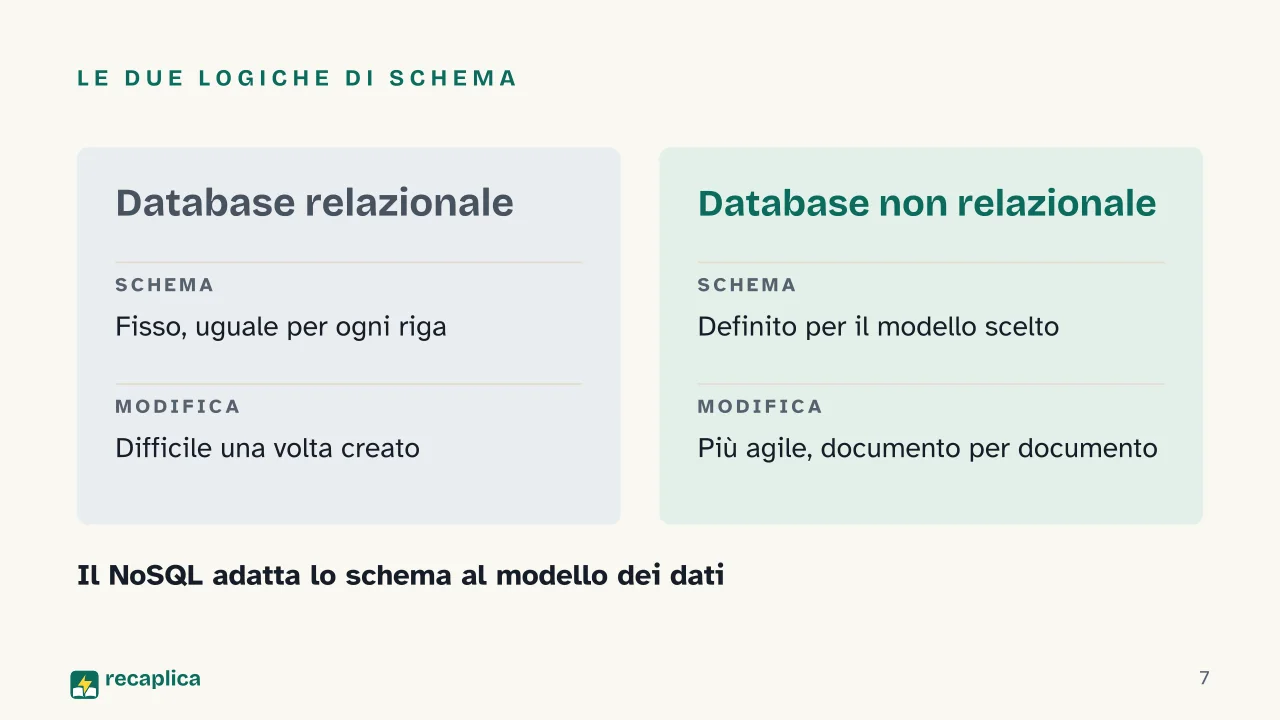
    Nel modello documentale, ogni documento contiene coppie di campo e valore, e i valori possono essere stringhe, numeri, valori booleani, array o anche altri documenti annidati. Documenti diversi nella stessa raccolta possono avere campi diversi tra loro: è più facile cambiare lo schema, se serve, proprio per questa flessibilità. Nel modello relazionale, al contrario, lo schema è fisso: ogni riga di una tabella deve contenere gli stessi tipi di colonna predefiniti, e cambiare lo schema dopo che i dati sono già stati inseriti è più complicato.

    Redis, un database chiave-valore, mostra bene che “chiave-valore” non vuol dire solo stringhe semplici: oltre alle stringhe, implementa hash, che funzionano come dizionari a coppie campo-valore, insiemi non ordinati di stringhe uniche, e liste ordinate per inserimento. Un insieme in Redis permette di aggiungere, rimuovere e verificare l’esistenza di un elemento in tempo costante, indipendentemente da quanti elementi contiene.

    Scalabilità, verticale e orizzontale

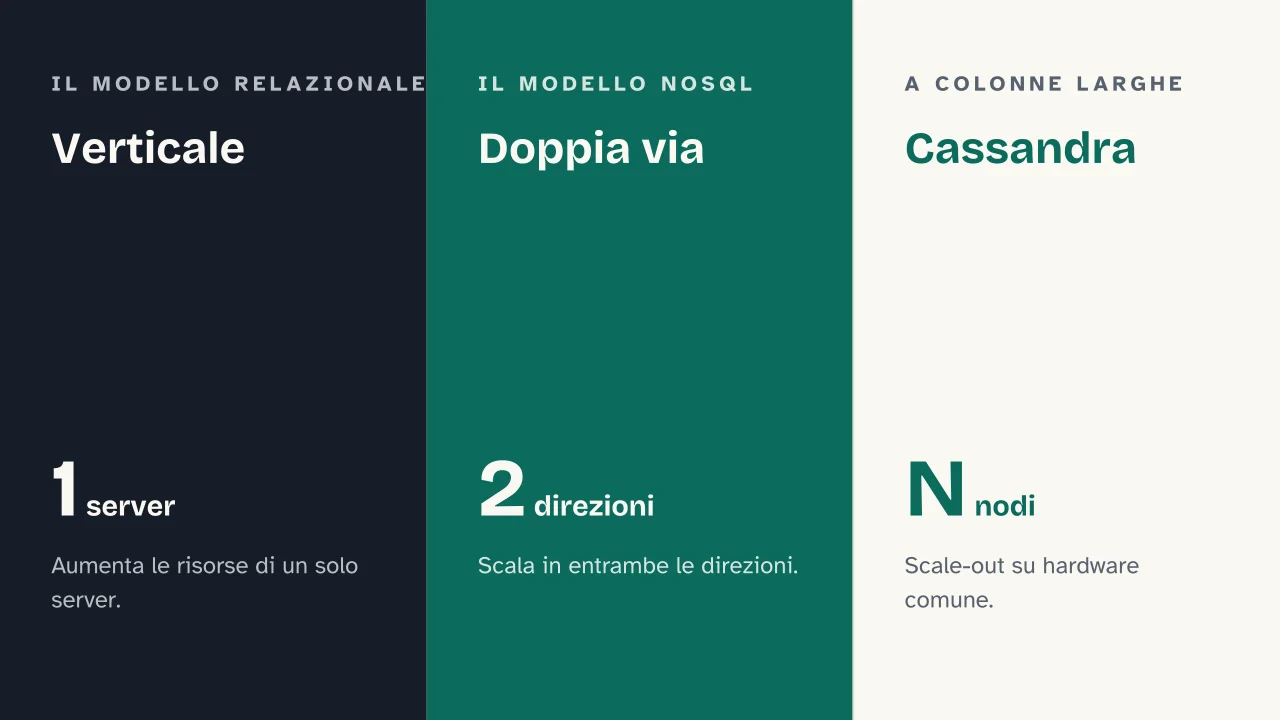
    La scalabilità verticale cresce aumentando le risorse di una singola macchina, più memoria, più processore. La scalabilità orizzontale cresce aggiungendo altre macchine, spesso raggruppate in cluster distribuiti su più server, che possono anche trovarsi in luoghi diversi e comunicare attraverso Internet. Secondo MongoDB, i database relazionali sono progettati soprattutto per la scalabilità verticale, con una capacità limitata di estendersi anche in orizzontale; i database NoSQL, invece, sono pensati per scalare sia verticalmente sia orizzontalmente, spesso tramite sharding, replica e clustering.

    AspettoDatabase relazionaleDatabase non relazionale
    SchemaFisso, definito in anticipoFlessibile, adattato al modello scelto
    Scalabilità principaleVerticaleVerticale e orizzontale
    Modello dati tipicoTabellare, righe e colonneDocumento, chiave-valore, grafo o colonna larga
    Adatto aDati strutturati, relazioni definiteDati semi-strutturati, grandi volumi, alto traffico

    Apache Cassandra, un database a colonne larghe, è un esempio concreto di questa filosofia: i suoi obiettivi di progettazione includono lo scaling su hardware comune, con un throughput che cresce in modo lineare a ogni processore aggiunto, e il bilanciamento del carico durante la crescita del cluster.

    Il teorema CAP, un compromesso non un’etichetta fissa

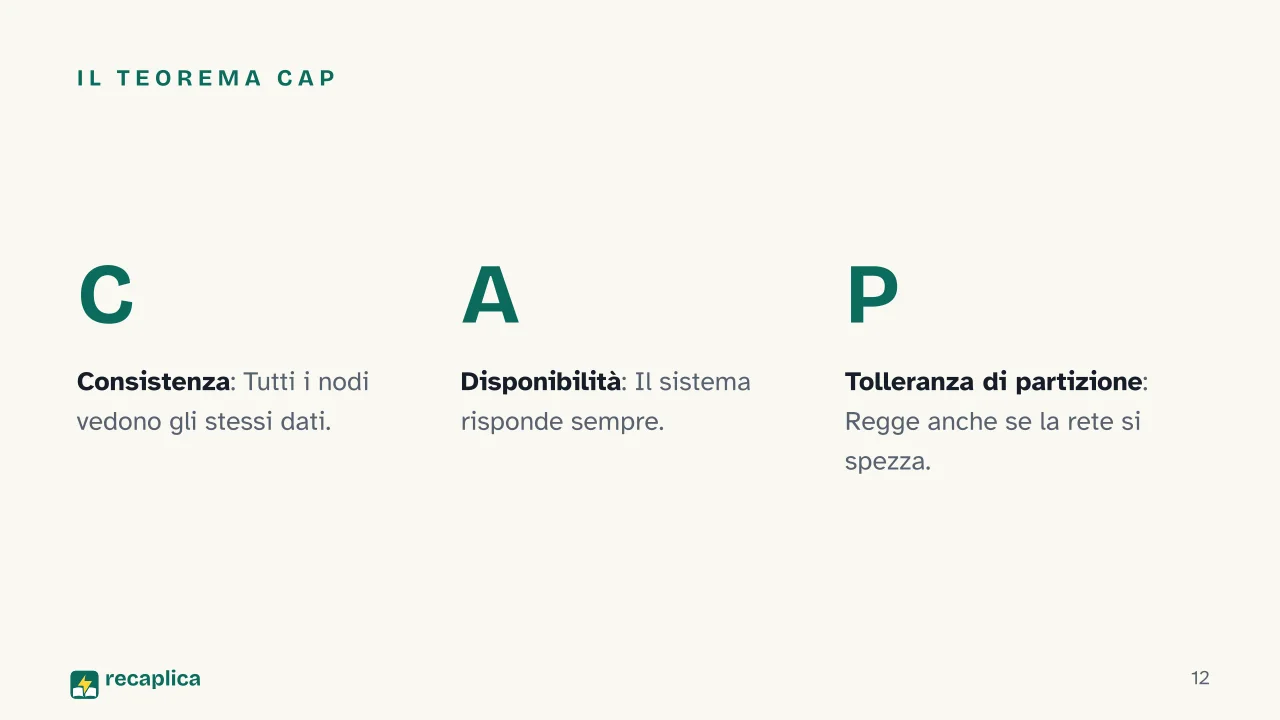
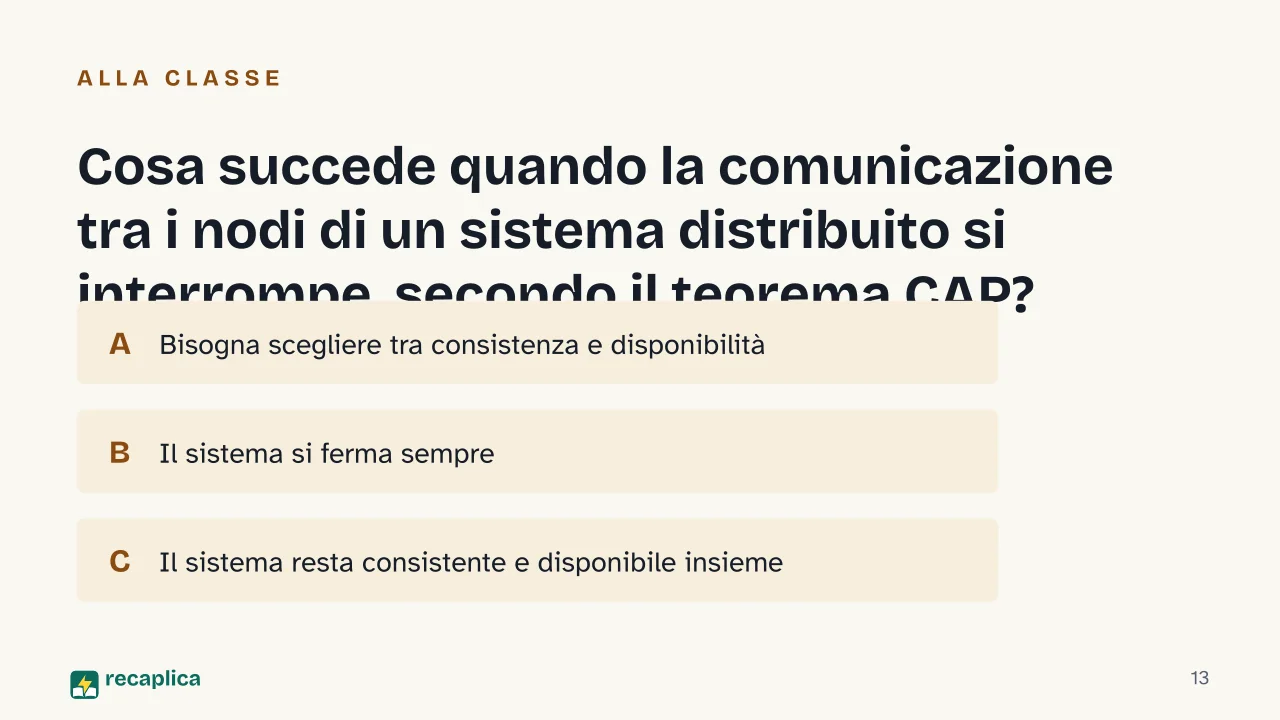
    Il teorema CAP descrive i compromessi che un database distribuito affronta tra consistenza, disponibilità e tolleranza di partizione, quando i dati sono replicati su più nodi. Poiché la tolleranza di partizione è un requisito in un ambiente distribuito, secondo MongoDB la vera scelta ricade tra mantenere la consistenza o la disponibilità nel momento in cui la comunicazione tra i nodi si interrompe.

    Non è una scelta permanente stampata addosso a un sistema, ma un compromesso che si attiva quando serve. MongoDB, per esempio, offre impostazioni regolabili, come writeConcern e readPreference, che permettono di bilanciare accuratezza, velocità e resilienza: può comportarsi come sistema più orientato alla consistenza o come sistema più orientato alla disponibilità, a seconda della configurazione. Apache Cassandra, dal canto suo, implementa quella che la sua documentazione chiama “consistenza eventuale”: i nodi del cluster si allineano sugli stessi dati nel tempo, non necessariamente subito dopo ogni scrittura.

    Quando conviene un modello o l’altro

    Secondo MongoDB, chi deve scegliere tra un database relazionale e uno NoSQL guarda in genere a fattori come lo sviluppo Agile a ritmo veloce, la necessità di archiviare dati strutturati insieme a dati semi-strutturati, grandi volumi di dati, requisiti di architettura scale-out, o paradigmi applicativi moderni come i microservizi e lo streaming in tempo reale. Un catalogo prodotti con relazioni ben definite tra clienti, ordini e fatture resta un caso naturale per un database relazionale. Un sistema di raccomandazioni che lavora su reti di connessioni, o un servizio che deve incassare picchi di traffico imprevedibili con un algoritmo di lettura rapidissimo, si sposta più facilmente verso un modello NoSQL, documentale, a grafo o chiave-valore a seconda del problema.

    La scelta resta legata al problema da risolvere: come sono fatti i dati, quanto la loro struttura può cambiare nel tempo, e come deve crescere il sistema che li ospita.

    Presentazione

    Slide pronte da scaricare e fare tue in PowerPoint o Google Slides, con le note del relatore. Scegli il taglio Lampo o quello Completo.
    Slide 1 della presentazione su Database relazionali e non relazionali: Database relazionali e non relazionaliSlide 2 della presentazione su Database relazionali e non relazionali: Le tabelle non sono l'unico modo di organizzare i datiSlide 3 della presentazione su Database relazionali e non relazionali: Il percorsoSlide 4 della presentazione su Database relazionali e non relazionali: Capitolo 01: I modelli non relazionaliSlide 5 della presentazione su Database relazionali e non relazionali: Un esempio per modello: MongoDB, Redis, Neo4jSlide 6 della presentazione su Database relazionali e non relazionali: Capitolo 02: Schema fisso o flessibileSlide 7 della presentazione su Database relazionali e non relazionali: Le due logiche di schemaSlide 8 della presentazione su Database relazionali e non relazionali: I documenti restano organizzati, anche con campi diversiSlide 9 della presentazione su Database relazionali e non relazionali: Capitolo 03: Scalabilità, verticale e orizzontaleSlide 10 della presentazione su Database relazionali e non relazionali: Verticale · Doppia via · CassandraSlide 11 della presentazione su Database relazionali e non relazionali: Capitolo 04: Il teorema CAPSlide 12 della presentazione su Database relazionali e non relazionali: Il teorema CAPSlide 13 della presentazione su Database relazionali e non relazionali: Cosa succede quando la comunicazione tra i nodi di un sistema distribuito si interrompe, secondo il teorema CAP?Slide 14 della presentazione su Database relazionali e non relazionali: Continua a leggere
    Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta14 slideTutti i capitoli e gli approfondimenti

    Falsi miti

    • ✗ Mito Un database NoSQL non ha alcuno schema.

      ✓ Realtà Secondo MongoDB, i database NoSQL offrono schemi flessibili: documenti diversi nella stessa raccolta possono avere campi diversi tra loro, il che è ben diverso dalla rigidità di una tabella relazionale, ma non significa che i dati siano privi di struttura.

    • ✗ Mito Un database chiave-valore come Redis gestisce solo semplici coppie chiave-valore.

      ✓ Realtà Redis implementa diversi tipi di dato oltre alla stringa semplice, tra cui hash, insiemi e liste ordinate, secondo la sua documentazione; un insieme, per esempio, permette di verificare l'esistenza di un elemento in tempo costante, indipendentemente da quanti elementi contiene.

    • ✗ Mito I database non relazionali sono sempre più veloci o più scalabili di quelli relazionali.

      ✓ Realtà Secondo MongoDB, i database relazionali possono estendere in parte capacità di scalabilità orizzontale, e i sistemi NoSQL distribuiti pagano un compromesso descritto dal teorema CAP: la disponibilità si guadagna a scapito della consistenza solo quando la rete tra i nodi si interrompe, non sempre.

    Mappa concettuale

    Trascina lo sfondo per muoverti e i nodi per riposizionarli; usa − e + per chiudere e aprire i rami.
    Personalizza
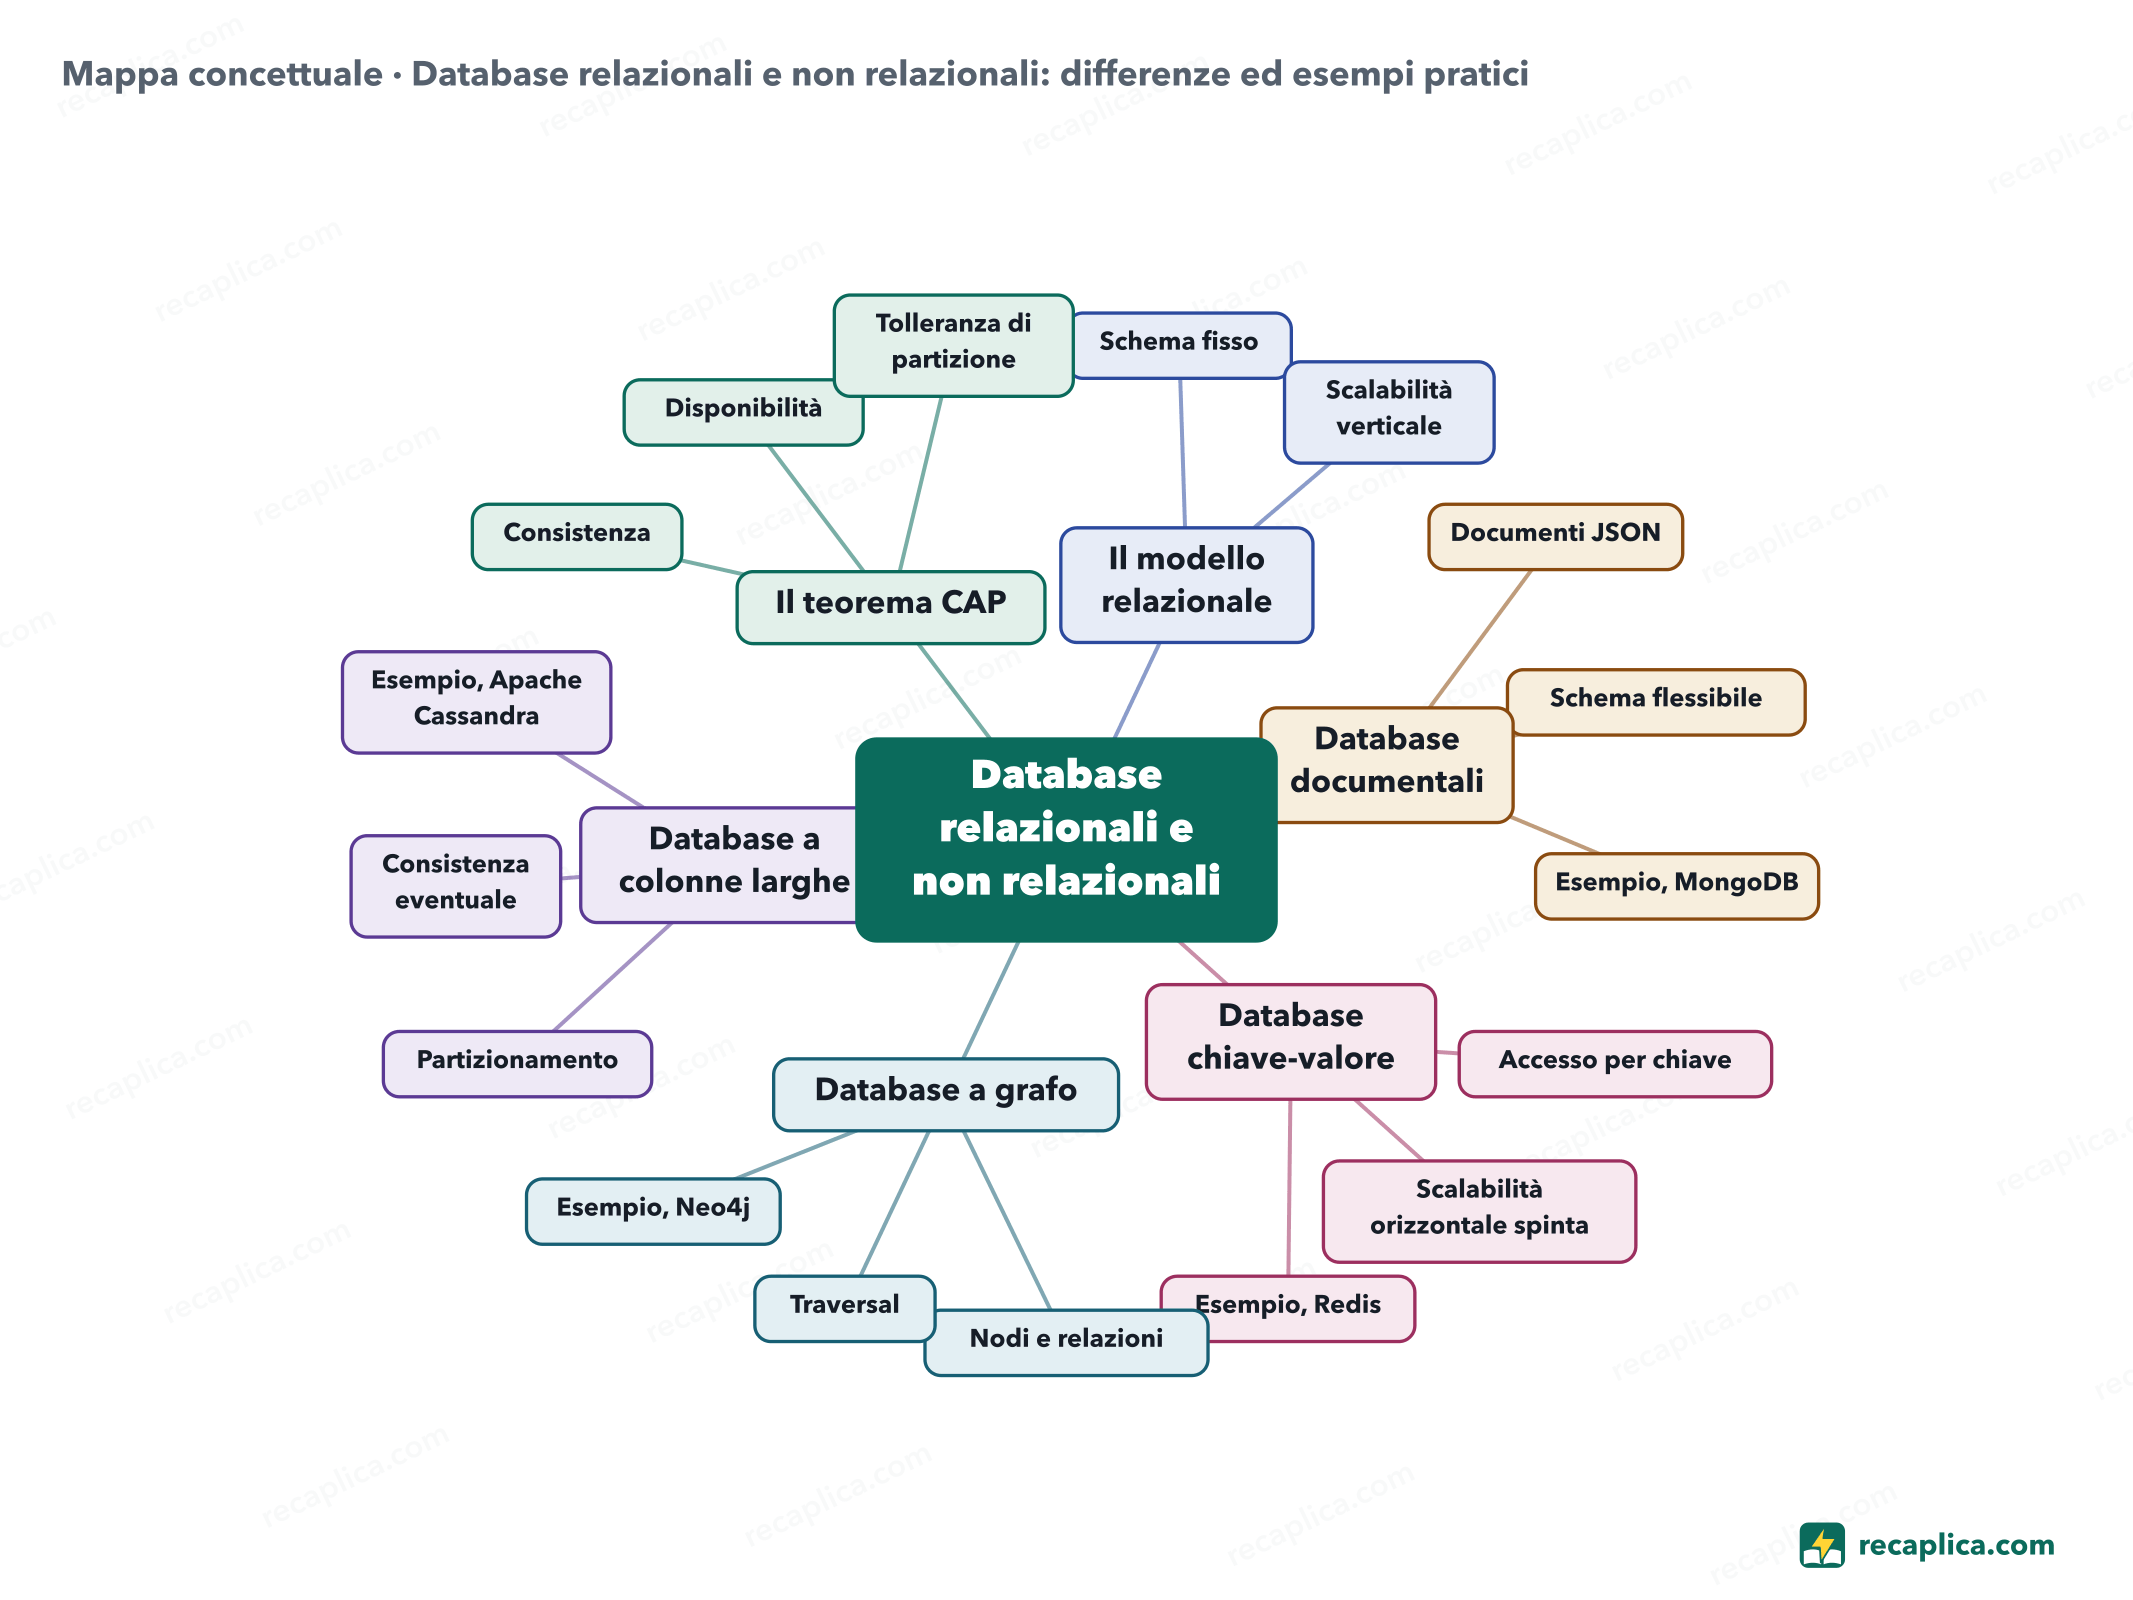
    Mappa concettuale: Database relazionali e non relazionali: differenze ed esempi pratici
    • Database relazionali e non relazionali
      • Il modello relazionale
        • Schema fisso tabelle definite in anticipo, stesso insieme di colonne per ogni riga
        • Scalabilità verticale pensato per crescere aumentando le risorse di una macchina
      • Database documentali
        • Documenti JSON campi e valori, anche annidati, come nel codice applicativo
        • Schema flessibile documenti diversi nella stessa raccolta possono avere campi diversi
        • Esempio, MongoDB secondo MongoDB, arrivato nel 2009 insieme a CouchDB
      • Database chiave-valore
        • Accesso per chiave non solo stringhe semplici, anche hash, insiemi e liste
        • Scalabilità orizzontale spinta altamente partizionabile, secondo AWS
        • Esempio, Redis server di strutture dati per caching e code
      • Database a grafo
        • Nodi e relazioni le relazioni hanno sempre una direzione e un tipo
        • Traversal la query che attraversa il grafo per trovare connessioni
        • Esempio, Neo4j spesso descritto come a schema opzionale
      • Database a colonne larghe
        • Partizionamento le tabelle si dividono in base alla chiave di partizione
        • Consistenza eventuale i nodi si allineano nel tempo, non nell'istante della scrittura
        • Esempio, Apache Cassandra pensato per lo scale-out su hardware comune
      • Il teorema CAP
        • Consistenza tutti i nodi vedono gli stessi dati nello stesso momento
        • Disponibilità il sistema risponde sempre alle richieste
        • Tolleranza di partizione il sistema continua a funzionare anche se la rete si spezza

    Quiz: mettiti alla prova

    Rispondi alle domande per verificare quanto hai imparato: riceverai subito la correzione e una breve spiegazione.

    Voto 0/10 0/5
    1 Qual è la differenza principale di schema tra un database relazionale e uno NoSQL?

    Secondo MongoDB, un database relazionale ha uno schema fisso, con lo stesso insieme di colonne per ogni riga, mentre un database NoSQL ha uno schema flessibile, adattabile al modello di dati scelto.

    2 A quale dei quattro modelli NoSQL appartiene MongoDB, secondo la classificazione di AWS?

    AWS cita Amazon DocumentDB, compatibile con MongoDB, tra gli esempi di database documentali: i dati sono documenti simili a oggetti JSON, con campi e valori.

    3 Cosa descrive il teorema CAP?

    Secondo MongoDB, il teorema CAP descrive i compromessi che i database distribuiti affrontano tra consistenza, disponibilità e tolleranza di partizione quando i dati sono replicati su più nodi; dato che un sistema distribuito deve comunque reggere le partizioni di rete, la vera scelta è tra consistenza e disponibilità.

    4 Vero o falso, i database non relazionali possono scalare solo orizzontalmente, mai verticalmente.

    È falso. Secondo MongoDB, i database NoSQL sono progettati per scalare sia verticalmente sia orizzontalmente, mentre i database relazionali sono pensati principalmente per la scalabilità verticale.

    5 In un database a grafo come Neo4j, cos'è una traversal?

    Secondo Neo4j, una traversal è il modo in cui si interroga un grafo per rispondere a domande come quale musica ascoltano i propri amici che non si possiede ancora, o quali servizi sono coinvolti se un componente si guasta.

    Risposte: 1-A · 2-A · 3-A · 4-B · 5-A

    Flashcards

    Tocca la carta per girarla e verifica se ricordi la risposta, poi passa alla successiva.

    1 / 8

    Spiegalo con parole tue

    Il test definitivo: se sai spiegarlo con parole semplici, lo hai capito davvero. Scrivi la tua spiegazione, poi confrontala col Recap.

    La tua spiegazione resta salvata solo su questo dispositivo.

    Un database relazionale organizza i dati in tabelle con uno schema fisso, deciso prima di scrivere la prima riga. Un database non relazionale, o NoSQL, usa invece schemi flessibili pensati per un modello di dati specifico: documenti come in MongoDB, coppie chiave-valore come in Redis, colonne partizionate come in Apache Cassandra, nodi collegati da relazioni come in Neo4j. I database NoSQL nascono verso la fine degli anni 2000, quando il costo dello storage cala e cresce il bisogno di sistemi distribuiti su più macchine. La scelta tra i due modelli dipende dal tipo di dato e dal caso d'uso, non da quale sia genericamente più veloce o più scalabile: entrambi possono crescere, in modi diversi, e il teorema CAP spiega il compromesso che ogni sistema distribuito affronta quando la rete tra i suoi nodi si interrompe.

    Domande e risposte

    Qual è la differenza tra database relazionali e non relazionali?

    Un database relazionale organizza i dati in tabelle con uno schema fisso, uguale per ogni riga; un database non relazionale usa uno schema flessibile pensato per un modello di dati specifico, come documenti, coppie chiave-valore, colonne partizionate o grafi.

    Quali sono alcuni esempi di database non relazionali?

    MongoDB per il modello documentale, Redis per il modello chiave-valore, Apache Cassandra per il modello a colonne larghe e Neo4j per il modello a grafo sono tra gli esempi più citati di database NoSQL, ciascuno con un caso d'uso diverso.

    Cosa si intende con database SQL e NoSQL?

    SQL indica i database relazionali, interrogati con il linguaggio SQL e organizzati in tabelle a schema fisso. NoSQL indica invece i database che archiviano i dati in modo diverso dalle tabelle relazionali, con schemi flessibili; secondo MongoDB, la sigla è letta da alcuni come "not only SQL" e da altri semplicemente come "non-SQL".

    I database non relazionali sono sempre più veloci di quelli relazionali?

    No. I database relazionali possono comunque estendere in parte le proprie capacità di scalabilità orizzontale; quanto ai sistemi NoSQL distribuiti, il vantaggio in disponibilità previsto dal teorema CAP si attiva solo quando la comunicazione tra i nodi si interrompe, non come regola costante.

    Che cos'è un database NoSQL a grafo?

    Un database in cui i dati sono nodi collegati da relazioni con una direzione e un tipo preciso, come descrive Neo4j; si interroga con una traversal, ed è la scelta naturale per dati fortemente connessi, come reti sociali o sistemi di raccomandazione.

    Fonti consultate

    • AWS — NoSQL Database
    • MongoDB — NoSQL Explained
    • Redis — Redis data types
    • Neo4j — Graph database concepts
    • Apache Cassandra — Architecture overview
    • MongoDB — Mastering the CAP Theorem

    Ogni Recap passa da una revisione indipendente prima della pubblicazione.

    Ogni sera, i nuovi Recap del giorno sul canale Telegram. Iscriviti al canale →

    Continua a imparare

    • Tecnologia Database relazionali: come tabelle, righe e chiavi organizzano i dati Un database relazionale organizza i dati in tabelle, ciascuna dedicata a un tema, per esempio clienti o ordini. Ogni riga della tabella è un record, ogni colonna un campo con lo stesso tipo di informazione per tutte le righe. Una chiave primaria identifica in modo univoco ogni riga, mentre una chiave esterna la collega alle righe di un'altra tabella, così i dati restano coerenti senza essere ripetuti ovunque. Le tabelle si combinano secondo tre tipi di relazione, uno a uno, uno a molti, molti a molti, e si interrogano con SQL, il linguaggio standard di questi sistemi. Leggi il Recap →
    • Tecnologia DBMS: cos'è, i tipi principali e alcuni esempi Un DBMS, sigla di database management system, è il software che permette di creare, interrogare e aggiornare i dati di un database, senza che chi lo usa debba sapere come sono salvati fisicamente. Rispetto a fogli di calcolo o archivi di file, centralizza i dati e li rende più coerenti, riducendo duplicazioni e problemi di sicurezza. Il tipo più diffuso è il modello relazionale, che organizza i dati in tabelle collegate da chiavi e si interroga con SQL. Esistono anche DBMS non relazionali, o NoSQL, pensati per dati più flessibili, e due modelli più antichi, quello gerarchico e quello a rete, oltre al modello orientato a oggetti. Leggi il Recap →
    • Tecnologia Diagramma entità relazione: cos'è e come si costruisce Un diagramma entità-relazione (o diagramma ER) è la mappa che si disegna prima di costruire un database: mostra quali oggetti servono tracciare (le entità), quali informazioni li descrivono (gli attributi) e come sono collegati tra loro (le relazioni). Serve a capire la struttura dei dati prima ancora di scrivere le tabelle, ed è un passaggio di progettazione concettuale, non lo schema finale del database. Le due notazioni più diffuse per disegnarlo sono quella di Chen, con rettangoli e ovali, e quella Crow's Foot, con linee e piedi di corvo che indicano quante istanze si collegano tra loro. Una relazione può essere uno a uno, uno a molti o molti a molti, e ogni tipo ha un modo proprio di essere disegnato. Leggi il Recap →

    recaplica

    Chiaro in 30 secondi, tuo in 10 minuti.

    I Recap Mappe concettuali Chiedi un Recap Canale Telegram Crea una mappa concettuale Il metodo Chi siamo Privacy e cookie Note legali e condizioni d'uso

    © 2026 Recaplica · Un progetto di Curi S.r.l. — P. IVA 05472000750

    Statistiche, solo se vuoi

    Per capire quali Recap aiutano di più useremmo Google Analytics, con dati aggregati e anonimi. Parte solo col tuo ok, e puoi cambiare idea quando vuoi. Informativa privacy