Salta al contenuto
recaplica

    Un attimo: controllo di sicurezza

    Cloudflare vuole assicurarsi che tu non sia un robot. Spunta la casella qui sotto e la ricerca riparte da sola.

    EN
    recaplica Il machine learning: cos'è e come impara una macchina
    © 2026 Recaplica · recaplica.com — Tutti i diritti riservati
    Home › Tecnologia

    Il machine learning: cos'è e come impara una macchina

    Di Redazione Recaplica · Aggiornato il 31 agosto 2026

    Cosa stampare

    Con "Margini: predefiniti" compaiono anche i numeri di pagina.

    Slide

    Scegli il taglio

    Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta16 slideTutti i capitoli e gli approfondimenti

    Tutte e due hanno le note del relatore.

    Canale Telegram
    recaplica Chiaro in 30 secondi, tuo in 10 minuti.
    In 30 secondi Punti chiave Numeri Approfondimento Presentazione Falsi miti Mappa concettuale Quiz Flashcards FAQ

    In 30 secondi lettura lampo

    Il machine learning è il ramo dell'intelligenza artificiale in cui un software, chiamato modello, impara dai dati invece di seguire regole scritte a mano. Gli mostri migliaia di esempi e lui trova da solo gli schemi che collegano domanda e risposta: così riconosce lo spam, consiglia film, stima i prezzi. È la tecnologia dietro quasi tutta l'IA che usi ogni giorno.

    Punti Chiave

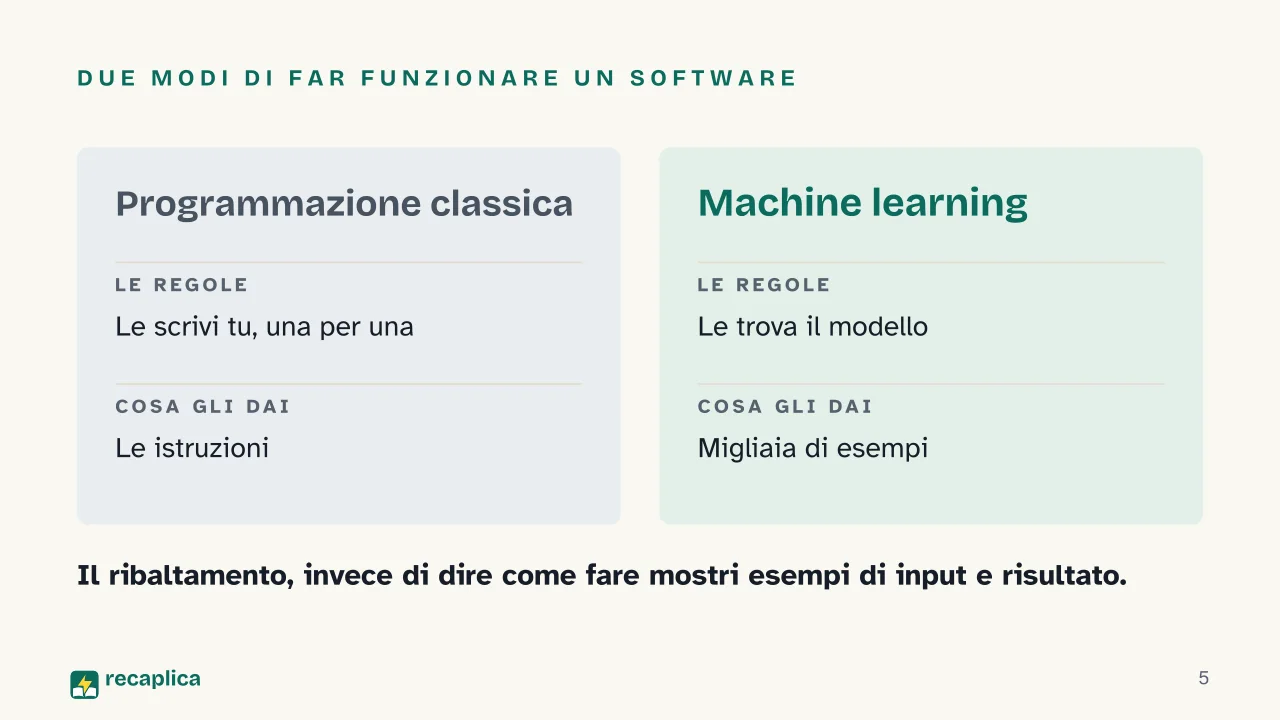
    • Programmazione classica: scrivi le regole. Machine learning: mostri esempi e le regole le trova il modello.
    • Il modello è il software addestrato; i dati di addestramento sono i suoi esempi di studio.
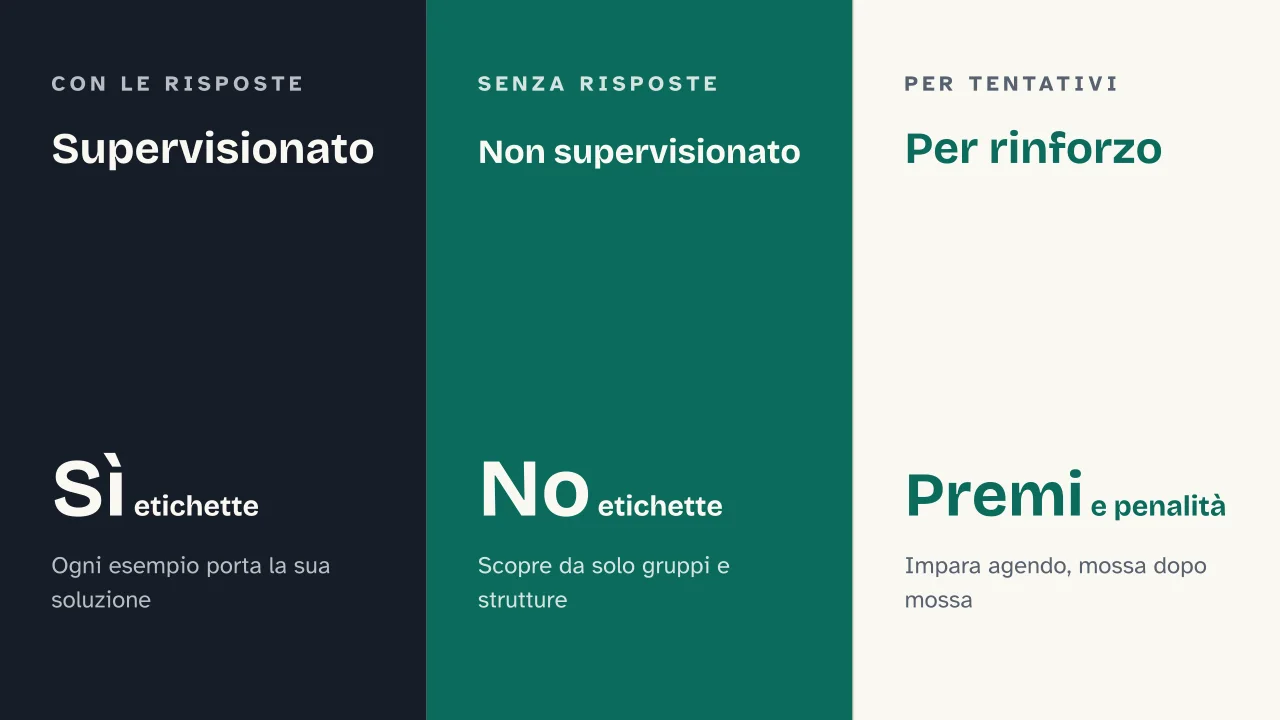
    • Apprendimento supervisionato: esempi con la risposta giusta allegata (come studiare da vecchi compiti svolti).
    • Apprendimento non supervisionato: il modello scopre da solo gruppi e strutture in dati senza etichette.
    • Apprendimento per rinforzo: si impara per tentativi, con premi e penalità.
    • Il termine nasce nel 1959 con Arthur Samuel e il suo programma che imparava a giocare a dama.

    I numeri chiave

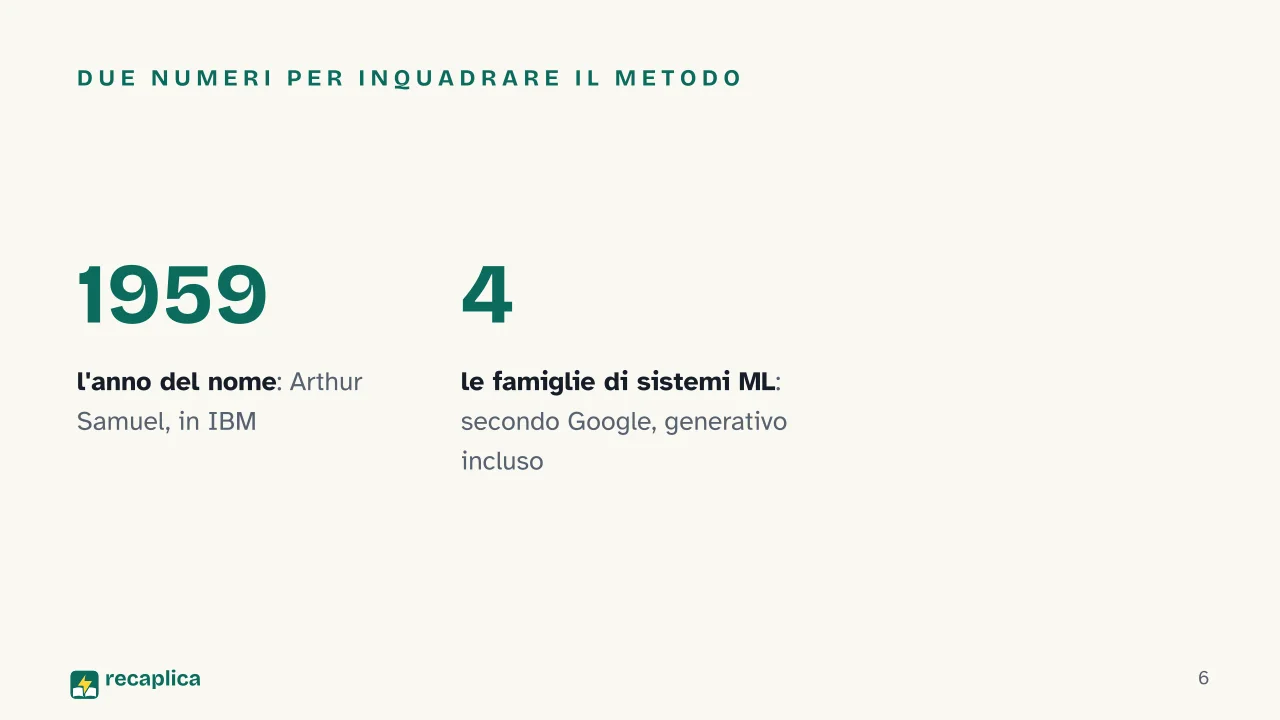
    • 1959 l'anno in cui Arthur Samuel conia il termine 'machine learning' sulla rivista di ricerca IBM Fonte: IBM Journal of Research and Development
    • 4 le famiglie di sistemi ML secondo Google: supervisionato, non supervisionato, per rinforzo, generativo Fonte: Google, Machine Learning Crash Course

    L'Approfondimento

    Il ribaltamento: esempi al posto di regole

    Per decenni programmare ha significato una cosa sola: scrivere regole. Se l’email contiene questa parola, segnala spam; se il cliente spende più di tanto, applica lo sconto. Funziona finché le regole si possono scrivere. Ma prova a scrivere le regole per riconoscere un gatto in una foto: orecchie a punta? Anche le volpi. Pelo? Non i gatti sphynx. Ci si arrende in fretta.

    Il machine learning ribalta il tavolo: invece di scrivere le regole, mostri al software migliaia di esempi (foto con l’etichetta “gatto” o “non gatto”) e lasci che sia lui a scovare gli schemi. Il risultato di questo studio si chiama modello. Come sintetizza Google, è “addestrare un software a fare previsioni utili o generare contenuti a partire dai dati”.

    L’idea ha una data di nascita precisa: nel 1959 Arthur Samuel, in IBM, coniò il termine descrivendo il suo programma che migliorava a dama partita dopo partita, fino a battere giocatori esperti.

    I tre modi di imparare (più uno)

    Supervisionato: studiare dai compiti svolti

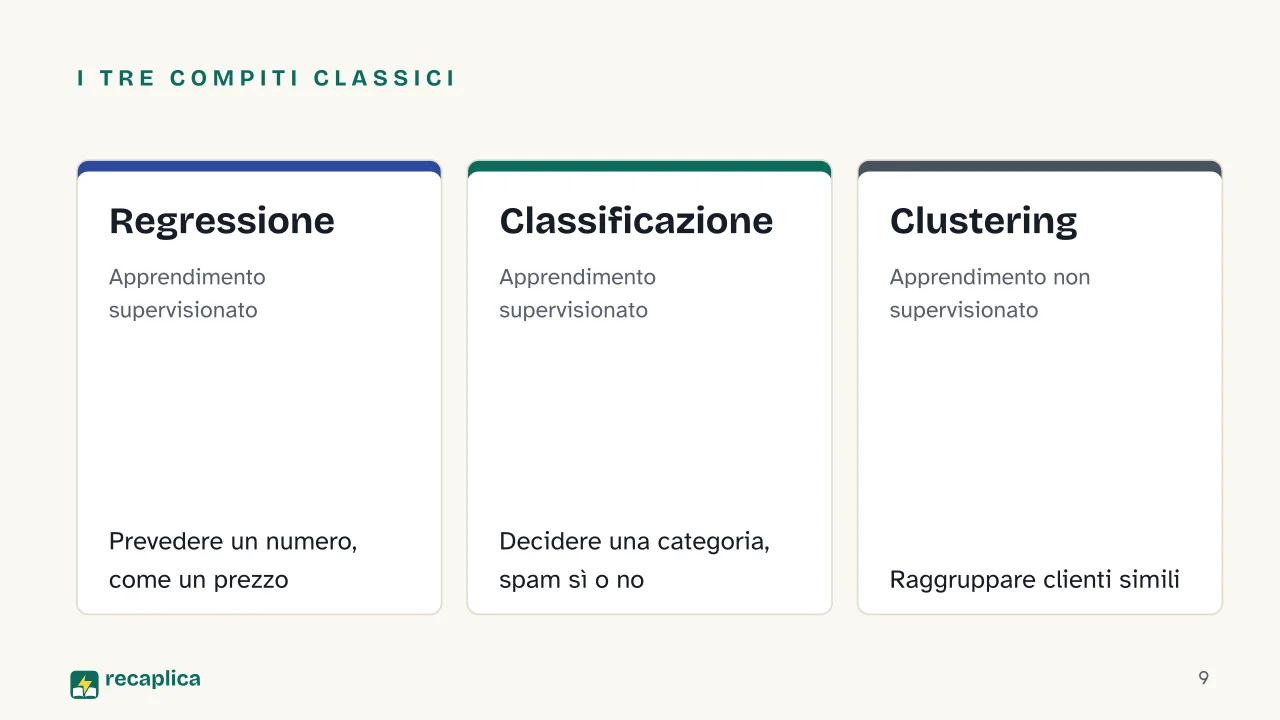
    È il metodo più diffuso: ogni esempio arriva con la risposta giusta allegata. Mille email etichettate “spam” o “non spam”, diecimila case con il loro prezzo di vendita. Il modello impara la relazione tra input e risposta, come uno studente che si prepara sui compiti svolti degli anni precedenti. Le due applicazioni classiche: la regressione (prevedere un numero, tipo il prezzo di una casa) e la classificazione (decidere una categoria, tipo spam sì o no).

    Non supervisionato: trovare ordine senza istruzioni

    Qui gli esempi non hanno etichette. Il modello riceve i dati grezzi e cerca da solo strutture e somiglianze: il clustering raggruppa i clienti con abitudini simili senza che nessuno abbia definito i gruppi in anticipo. Sta poi agli umani dare un senso a ciò che emerge.

    Per rinforzo: imparare sbagliando

    Il sistema agisce in un ambiente e incassa premi o penalità: mossa vincente, punto; mossa persa, punizione. Tentativo dopo tentativo affina la strategia. È così che AlphaGo ha imparato a battere i campioni umani di Go, ed è il metodo con cui si addestrano i robot.

    E il generativo?

    I sistemi che creano contenuti — testo, immagini, codice — sono la famiglia più recente: ne abbiamo parlato nell’articolo sull’IA generativa. Sotto il cofano c’è sempre machine learning, in versione gigante.

    Esempio pratico: il tuo servizio di streaming usa l’apprendimento supervisionato per stimare quanto ti piacerà un film (ha milioni di voti come esempi), il non supervisionato per scoprire “tipi” di spettatori simili a te, e mescola i risultati nella riga “consigliati per te”.

    Dove il metodo mostra i muscoli, e dove i limiti

    Il machine learning eccelle dove le regole sono impossibili da scrivere: riconoscere volti e voci, tradurre, stimare rischi. La sua materia prima però è tutto: il modello vale quanto i suoi dati. Esempi sbilanciati o sporchi producono previsioni sbilanciate e sporche, e un pregiudizio presente nei dati viene imparato con la stessa diligenza di qualsiasi altro schema.

    C’è poi un limite di natura: il modello riconosce correlazioni, non capisce cause. Se il mondo cambia (nuove abitudini, nuovi trucchi degli spammer), gli schemi imparati invecchiano e le previsioni peggiorano, finché qualcuno non lo riaddestra su dati freschi.

    Come faccia, in concreto, una macchina ad “aggiustare i propri parametri” mentre studia è la storia delle reti neurali — il motore matematico dietro il deep learning. E tutto questo, alla base, resta ciò che è sempre stata l’informatica: un algoritmo che macina passi ben definiti, solo che stavolta i passi li ha scritti l’addestramento.

    Presentazione

    Slide pronte da scaricare e fare tue in PowerPoint o Google Slides, con le note del relatore. Scegli il taglio Lampo o quello Completo.
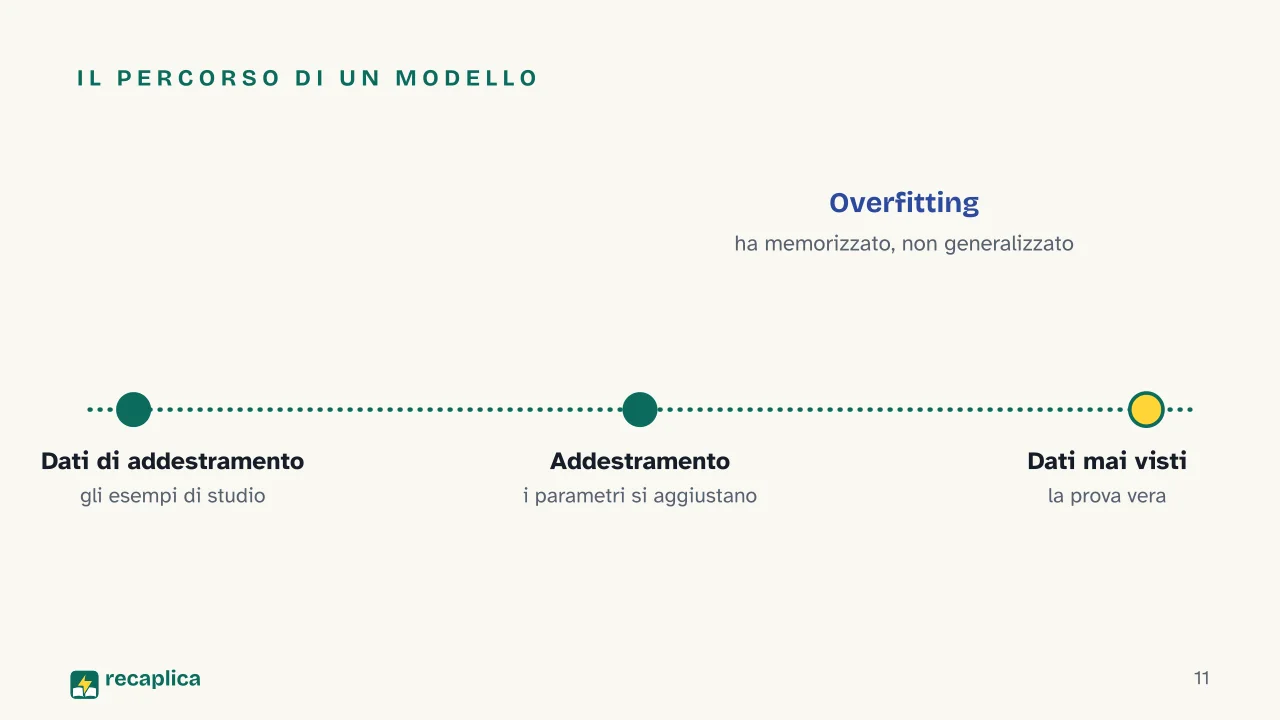
    Slide 1 della presentazione su Il machine learning: Il machine learningSlide 2 della presentazione su Il machine learning: Che regole scrivi per riconoscere un gatto?Slide 3 della presentazione su Il machine learning: Di cosa parliamoSlide 4 della presentazione su Il machine learning: Capitolo 01: Il ribaltamentoSlide 5 della presentazione su Il machine learning: Due modi di far funzionare un softwareSlide 6 della presentazione su Il machine learning: Due numeri per inquadrare il metodoSlide 7 della presentazione su Il machine learning: Capitolo 02: I tre modi di imparareSlide 8 della presentazione su Il machine learning: Supervisionato · Non supervisionato · Per rinforzoSlide 9 della presentazione su Il machine learning: I tre compiti classici: Regressione, Classificazione, ClusteringSlide 10 della presentazione su Il machine learning: Capitolo 03: Come si addestra un modelloSlide 11 della presentazione su Il machine learning: Il percorso di un modelloSlide 12 della presentazione su Il machine learning: Capitolo 04: Dove il metodo si rompeSlide 13 della presentazione su Il machine learning: Perché un modello che funzionava bene comincia a sbagliare?Slide 14 della presentazione su Il machine learning: Più dati non vuol dire modello migliore.Slide 15 della presentazione su Il machine learning: Un modello che raggruppa clienti simili senza etichette sta facendo...Slide 16 della presentazione su Il machine learning: E adesso, il ripasso
    Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta16 slideTutti i capitoli e gli approfondimenti

    Falsi miti

    • ✗ Mito Il machine learning è un cervello elettronico che ragiona.

      ✓ Realtà È statistica applicata su larga scala: il modello trova correlazioni nei dati e le usa per fare previsioni. Non capisce il mondo, riconosce schemi — e quando gli schemi cambiano, sbaglia.

    • ✗ Mito Più dati ci sono, meglio funziona, sempre.

      ✓ Realtà Contano qualità e rappresentatività, non solo la quantità: dati sbilanciati o pieni di errori producono modelli sbilanciati e pieni di errori. Se gli esempi contengono un pregiudizio, il modello lo impara con diligenza.

    • ✗ Mito Machine learning e intelligenza artificiale sono la stessa cosa.

      ✓ Realtà Il machine learning è un sottoinsieme dell'IA: il metodo dell'imparare dai dati. L'IA include anche approcci diversi, e a sua volta il deep learning (reti neurali profonde) è un sottoinsieme del machine learning.

    Mappa concettuale

    Trascina lo sfondo per muoverti e i nodi per riposizionarli; usa − e + per chiudere e aprire i rami.
    Personalizza
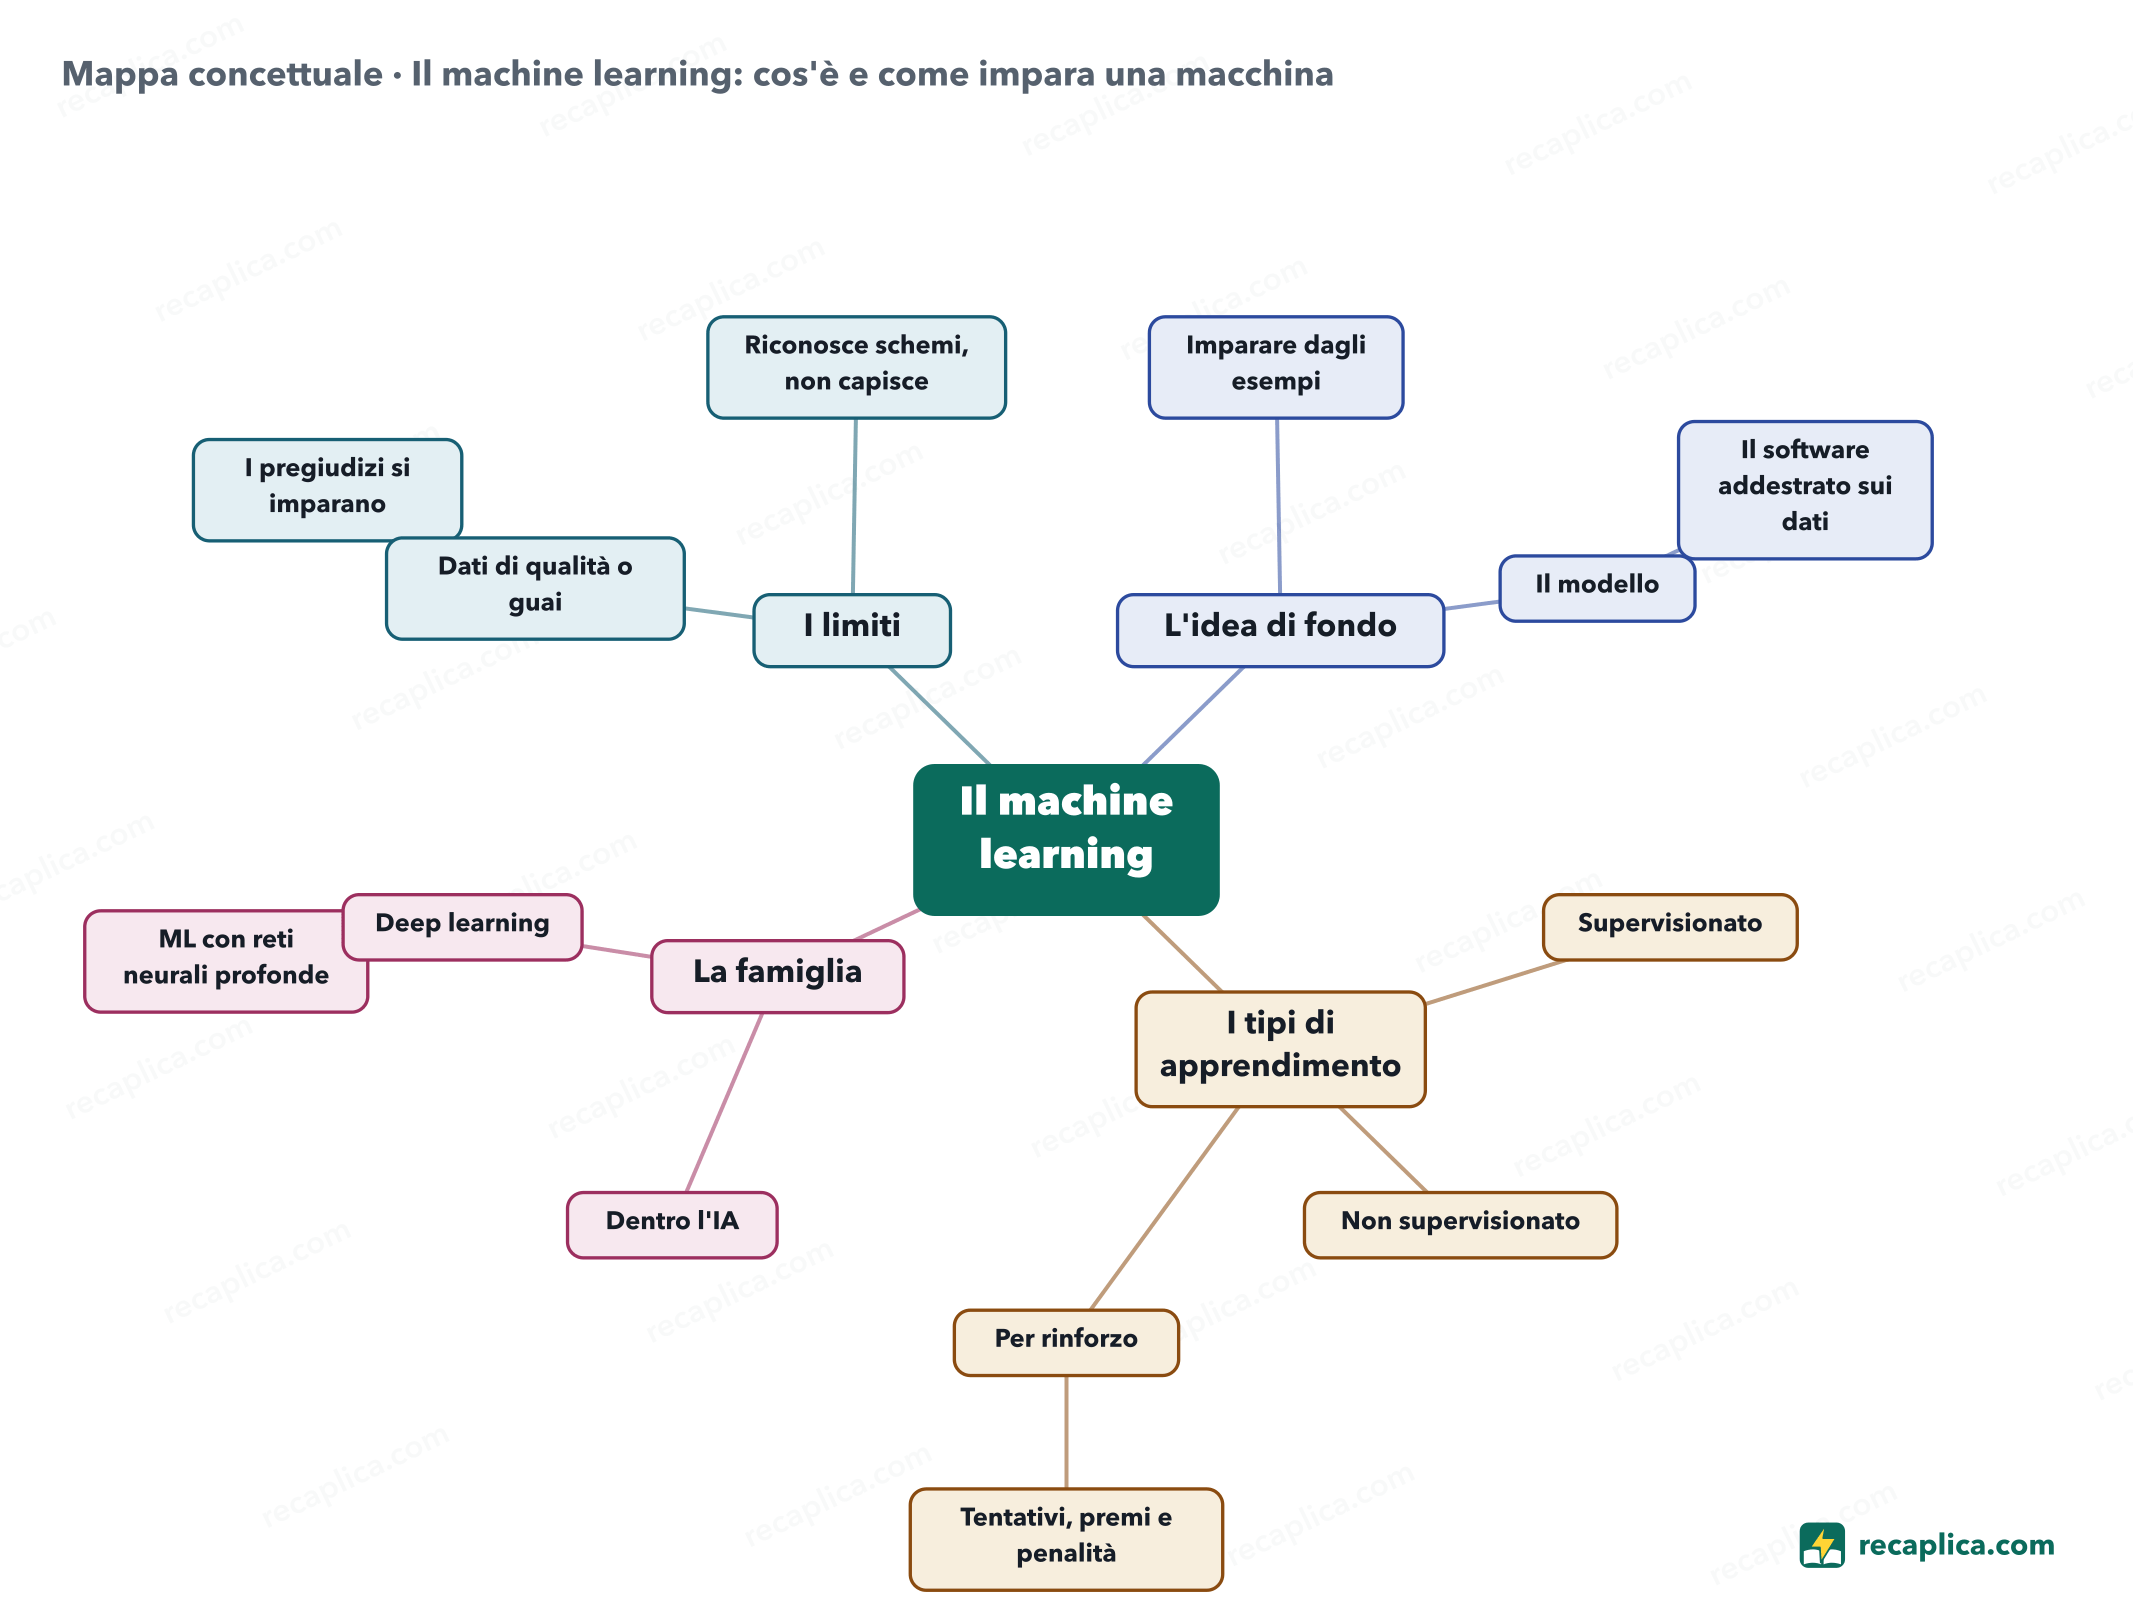
    Mappa concettuale: Il machine learning: cos'è e come impara una macchina
    • Il machine learning
      • L'idea di fondo
        • Imparare dagli esempi Le regole le trova il modello, non il programmatore.
        • Il modello
          • Il software addestrato sui dati
      • I tipi di apprendimento
        • Supervisionato Esempi con la risposta giusta allegata.
        • Non supervisionato Scopre gruppi in dati senza etichette.
        • Per rinforzo
          • Tentativi, premi e penalità
      • La famiglia
        • Dentro l'IA Il ML è un sottoinsieme dell'intelligenza artificiale.
        • Deep learning
          • ML con reti neurali profonde
      • I limiti
        • Dati di qualità o guai
          • I pregiudizi si imparano
        • Riconosce schemi, non capisce

    Quiz: mettiti alla prova

    Rispondi alle domande per verificare quanto hai imparato: riceverai subito la correzione e una breve spiegazione.

    Voto 0/10 0/5
    1 Qual è la differenza tra programmazione classica e machine learning?

    È il ribaltamento fondante: invece di dire alla macchina COME fare, le mostri migliaia di esempi di input e risultato, e lei trova da sola le relazioni. Di dati, anzi, ne servono parecchi.

    2 Cos'è l'apprendimento supervisionato?

    Ogni esempio porta la sua soluzione (questa email È spam, questa no): il modello impara la relazione tra input e risposta, come uno studente sui compiti svolti degli anni prima.

    3 Un modello che raggruppa i clienti simili senza etichette predefinite sta facendo...

    Nessuno gli ha detto quali gruppi esistono: il clustering scopre da solo le somiglianze nei dati. Sta poi agli umani interpretare i gruppi trovati.

    4 Come impara un sistema per rinforzo?

    Agisce in un ambiente, incassa ricompense o punizioni e aggiusta la strategia: è il metodo con cui i sistemi hanno imparato a battere i campioni di Go.

    5 Vero o falso: se i dati di addestramento contengono un pregiudizio, il modello tende a impararlo.

    Il modello impara dagli esempi tutto quello che c'è, distorsioni comprese. La qualità dei dati è il vero collo di bottiglia del machine learning.

    Risposte: 1-A · 2-A · 3-A · 4-A · 5-A

    Flashcards

    Tocca la carta per girarla e verifica se ricordi la risposta, poi passa alla successiva.

    1 / 7

    Spiegalo con parole tue

    Il test definitivo: se sai spiegarlo con parole semplici, lo hai capito davvero. Scrivi la tua spiegazione, poi confrontala col Recap.

    La tua spiegazione resta salvata solo su questo dispositivo.

    Il machine learning è il ramo dell'intelligenza artificiale in cui un software, chiamato modello, impara dai dati invece di seguire regole scritte a mano. Gli mostri migliaia di esempi e lui trova da solo gli schemi che collegano domanda e risposta: così riconosce lo spam, consiglia film, stima i prezzi. È la tecnologia dietro quasi tutta l'IA che usi ogni giorno.

    Domande e risposte

    Dove incontro il machine learning ogni giorno?

    Il filtro antispam, i suggerimenti di film e musica, il riconoscimento facciale del telefono, il traduttore automatico, le previsioni di traffico del navigatore, i prezzi dinamici dei voli. Quasi tutta l'IA quotidiana è machine learning al lavoro.

    Che differenza c'è tra machine learning e deep learning?

    Il deep learning è machine learning fatto con reti neurali profonde, cioè a molti strati: la sottofamiglia che ha reso possibili riconoscimento di immagini, voce e i grandi modelli linguistici. Ogni deep learning è ML, non viceversa.

    Cosa significa 'addestrare' un modello?

    Fargli elaborare gli esempi aggiustando gradualmente i suoi parametri interni finché le sue previsioni si avvicinano alle risposte corrette. Finito l'addestramento, il modello si usa su dati mai visti: è lì che si scopre se ha imparato davvero.

    Un modello può sbagliare dopo l'addestramento?

    Certo, e succede in due modi tipici: se ha memorizzato gli esempi invece di generalizzare (overfitting), o se il mondo reale è cambiato rispetto ai dati su cui ha studiato. Per questo i modelli si valutano su dati di test e si riaddestrano nel tempo.

    Fonti consultate

    • Google — What is Machine Learning? (Machine Learning Crash Course)
    • Sutton & Barto — Samuel's Checkers Player (il programma del 1959)

    Ogni Recap passa da una revisione indipendente prima della pubblicazione.

    Ogni sera, i nuovi Recap del giorno sul canale Telegram. Iscriviti al canale →

    Continua a imparare

    • Tecnologia Intelligenza artificiale e cultura pop: quando i contenuti sintetici riscrivono la storia Secondo Lead Stories, una foto della Seconda guerra mondiale conservata dagli Imperial War Museums è circolata nel 2026 in una versione colorizzata dall'intelligenza artificiale che un rilevatore ha giudicato falsa al 99%, pur partendo da uno scatto autentico. Casi come questo riguardano anche la cultura pop e la cronaca recente: modelli di testo, immagini e video producono contenuti che sembrano storici o iconici senza esserlo, oppure alterano quelli veri in dettagli difficili da notare a occhio nudo. Alcuni strumenti lasciano indizi tecnici, come le filigrane digitali o i limiti di durata dei video, ma nessuno copre tutti i generatori in circolazione. Il Reuters Institute segnala che nel 2026 la fiducia nelle risposte dei chatbot IA sulle notizie resta bassa, al 20% contro il 37% riposto nelle notizie in generale. Per capire se un'immagine o un video sono autentici serve il confronto con l'archivio originale in cui sono conservati. Leggi il Recap →
    • Tecnologia Filter bubble: come funzionano gli algoritmi di raccomandazione Un filter bubble è la bolla di contenuti simili che un algoritmo di raccomandazione costruisce intorno a un utente, filtrando in modo implicito cosa mostrargli in base ai suoi comportamenti passati. Il termine, coniato da Eli Pariser nel 2011, viene spesso confuso con l'echo chamber, un fenomeno sociale più vecchio e non necessariamente legato agli algoritmi. La ricerca più solida disponibile racconta un quadro con più sfumature di quanto si creda: gli algoritmi hanno un effetto misurabile ma modesto, e le scelte delle persone pesano di più. Il nesso diretto tra algoritmi e polarizzazione politica non è stabilito con certezza dagli esperimenti più rigorosi condotti finora. Leggi il Recap →
    • Tecnologia Influencer virtuali: chi sono i creator generati dall'IA Gli influencer virtuali sono personaggi digitali costruiti da un'agenzia o da uno studio, con un volto, una voce e una biografia, che pubblicano contenuti sui social come farebbe una persona reale. Il fenomeno non è recente: l'account di Lil Miquela è attivo dal 23 aprile 2016 e Shudu Gram è comparsa il 22 aprile 2017, anni prima del boom pubblico dell'IA generativa. Alcuni di questi profili lavorano con marchi noti: Miquela ha collaborato con Calvin Klein e Prada, mentre l'agenzia spagnola The Clueless ha creato Aitana López al posto di modelle e influencer umane giudicate poco affidabili. Negli Stati Uniti la Federal Trade Commission ha aggiornato nel 2023 le regole sulla pubblicità includendo esplicitamente gli influencer virtuali tra i contenuti da segnalare come sponsorizzati. Leggi il Recap →

    recaplica

    Chiaro in 30 secondi, tuo in 10 minuti.

    I Recap Mappe concettuali Chiedi un Recap Canale Telegram Crea una mappa concettuale Il metodo Chi siamo Privacy e cookie Note legali e condizioni d'uso

    © 2026 Recaplica · Un progetto di Curi S.r.l. — P. IVA 05472000750

    Statistiche, solo se vuoi

    Per capire quali Recap aiutano di più useremmo Google Analytics, con dati aggregati e anonimi. Parte solo col tuo ok, e puoi cambiare idea quando vuoi. Informativa privacy