Salta al contenuto
recaplica

    Un attimo: controllo di sicurezza

    Cloudflare vuole assicurarsi che tu non sia un robot. Spunta la casella qui sotto e la ricerca riparte da sola.

    EN
    recaplica Probabilità e statistica: cosa sono e come si usano insieme
    © 2026 Recaplica · recaplica.com — Tutti i diritti riservati
    Home › Scienza

    Probabilità e statistica: cosa sono e come si usano insieme

    Di Redazione Recaplica · Aggiornato il 18 settembre 2026

    Cosa stampare

    Con "Margini: predefiniti" compaiono anche i numeri di pagina.

    Slide

    Scegli il taglio

    Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta15 slideTutti i capitoli e gli approfondimenti

    Tutte e due hanno le note del relatore.

    Canale Telegram
    recaplica Chiaro in 30 secondi, tuo in 10 minuti.
    In 30 secondi Punti chiave Numeri Approfondimento Presentazione Falsi miti Mappa concettuale Quiz Flashcards FAQ

    In 30 secondi lettura lampo

    Probabilità e statistica sono due rami della matematica che studiano l'incertezza da direzioni opposte: la probabilità calcola in anticipo quanto è possibile che un evento accada, la statistica analizza dati già raccolti per descriverli o per trarre conclusioni su un gruppo più ampio. Nei programmi di matematica del biennio si studiano insieme perché condividono gli stessi strumenti di base, dall'idea di evento a quella di campione. La statistica si divide a sua volta in descrittiva, che riassume i dati con numeri come media e deviazione standard, e inferenziale, che usa un campione per stimare una popolazione intera. La probabilità, dal canto suo, si calcola in modo diverso a seconda che gli eventi siano equiprobabili (probabilità classica, come un dado) oppure osservati nel tempo (probabilità frequentista, come i guasti di un macchinario).

    Punti Chiave

    • Probabilità e statistica sono due rami della matematica che studiano l'incertezza: uno si occupa di eventi futuri e del loro grado di possibilità, l'altro di dati già in mano, da riassumere o da cui trarre conclusioni.
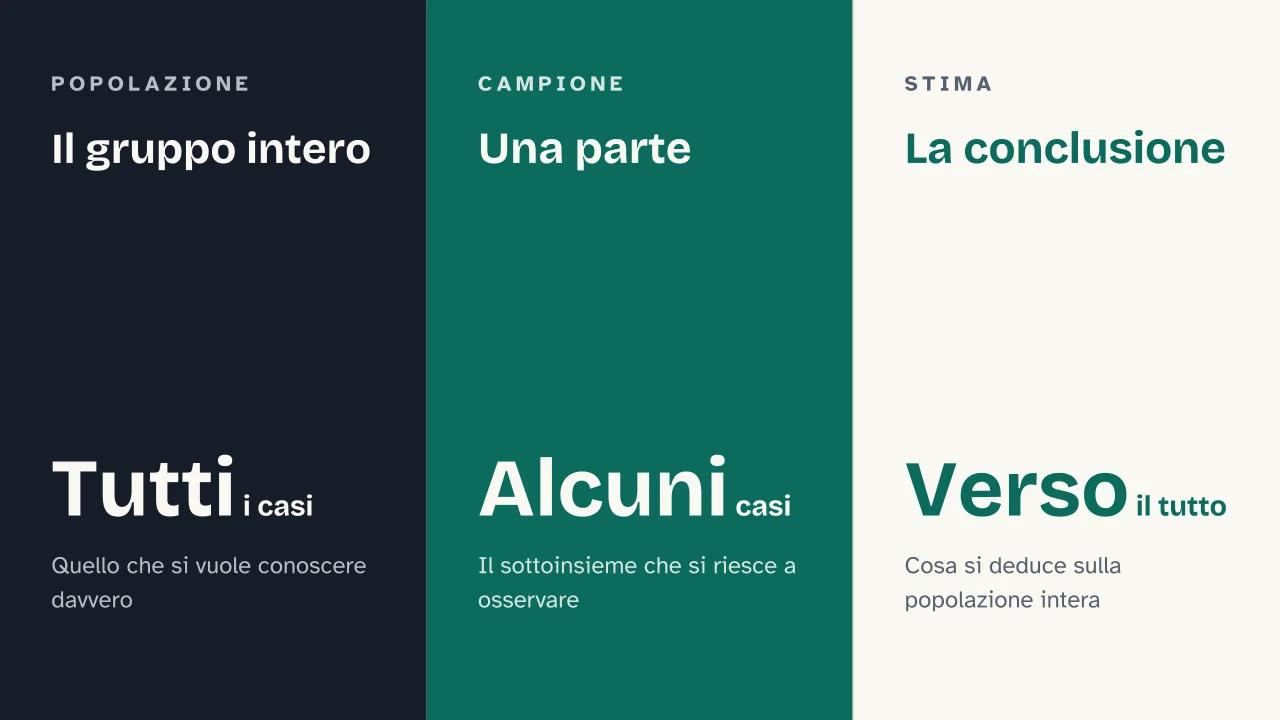
    • La statistica descrittiva riassume i dati con numeri come media, mediana e moda; la statistica inferenziale usa un campione per trarre conclusioni su una popolazione più ampia.
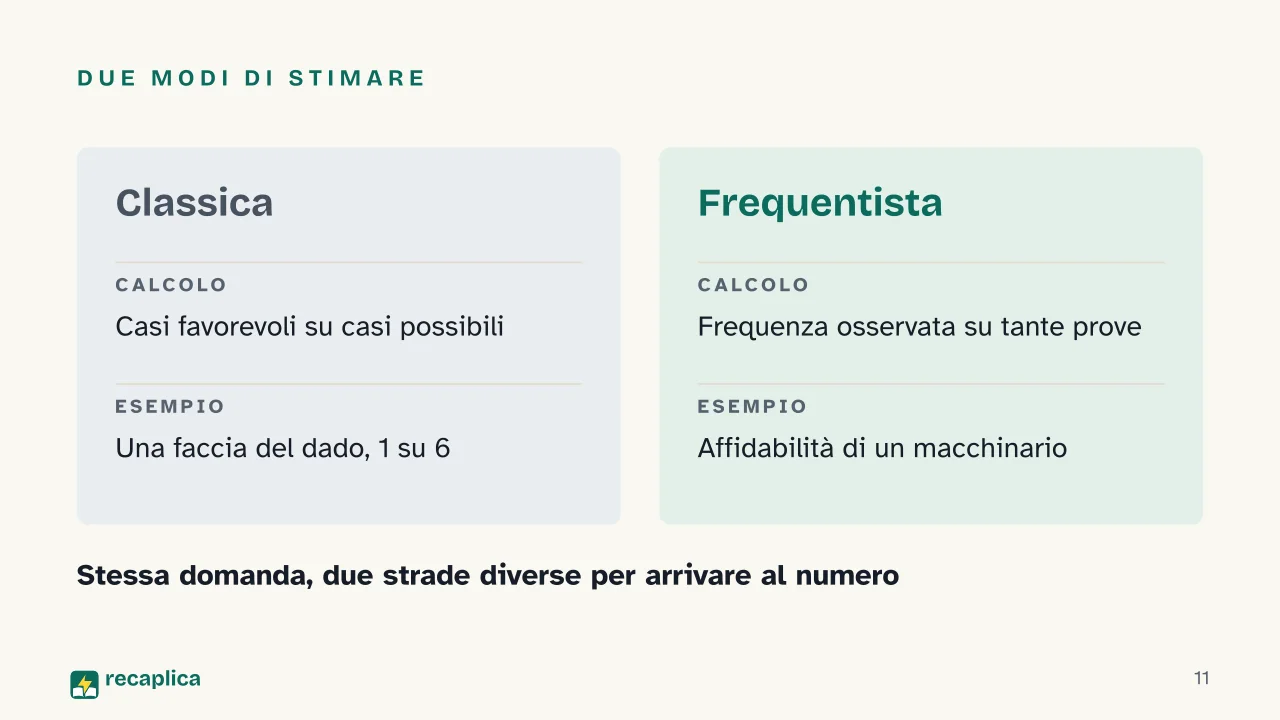
    • La probabilità classica si calcola dividendo i casi favorevoli per i casi possibili, come nel lancio di un dado; la probabilità frequentista si stima osservando quante volte un evento si ripete su tante prove.
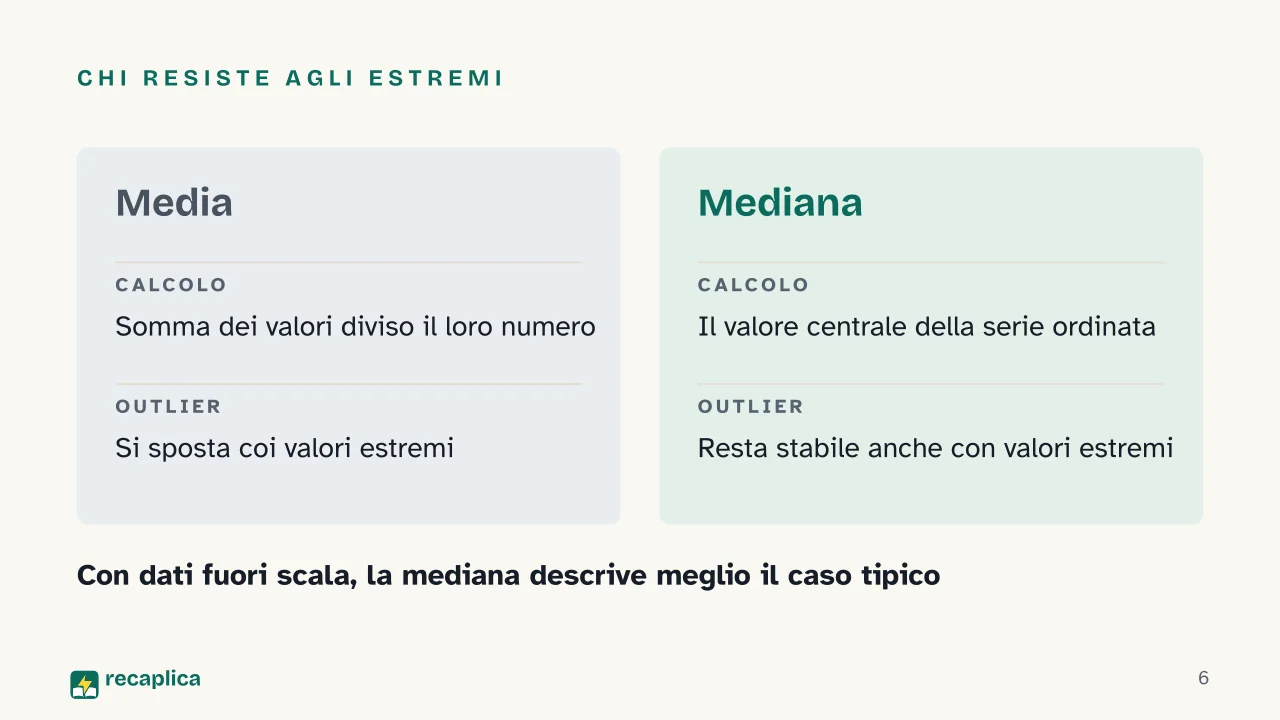
    • La media è la somma dei valori diviso il loro numero ed è sensibile ai valori estremi, mentre la mediana, il valore centrale della serie ordinata, resta stabile anche con dati fuori scala.
    • La deviazione standard misura quanto i dati si allontanano dalla media: piccola se i valori sono vicini, grande se sono sparsi.
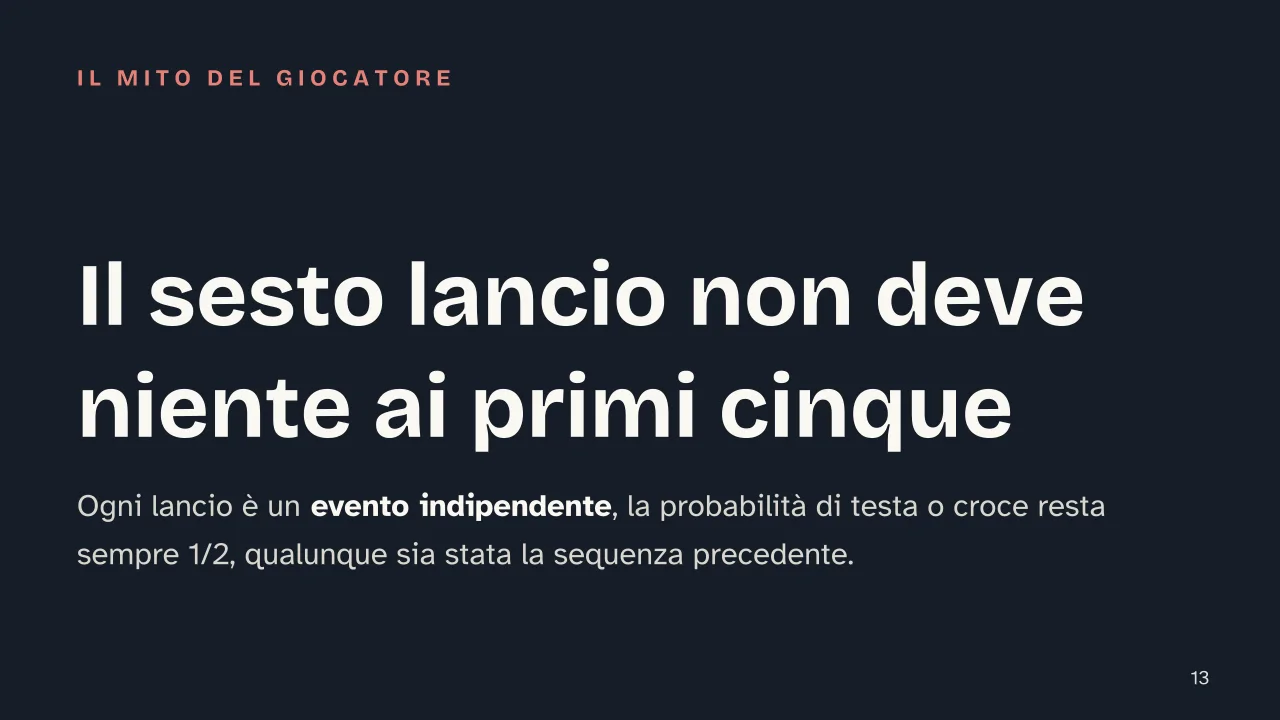
    • I lanci di una moneta sono eventi indipendenti: ogni lancio ha probabilità 1/2, qualunque sia stato il risultato dei lanci precedenti.

    I numeri chiave

    • 58.943.673 Residenti in Italia, un conteggio periodico che è di per sé un esempio di statistica descrittiva applicata a un caso reale. Fonte: ISTAT, Popolazione residente, al 30 giugno 2026

    L'Approfondimento

    Probabilità e statistica sono due materie che, nei programmi di matematica del biennio delle superiori, viaggiano quasi sempre insieme, anche se guardano l’incertezza da direzioni opposte. Come la definisce OpenStax, la statistica si occupa della raccolta, dell’analisi, dell’interpretazione e della presentazione dei dati; la probabilità, invece, è lo strumento matematico che studia la casualità, cioè quanto è possibile che un evento si verifichi. Chi lancia un dado usa la probabilità per prevedere; chi ha già registrato mille lanci usa la statistica per descrivere cosa è successo davvero.

    Statistica descrittiva e statistica inferenziale

    La statistica si divide in due rami. La statistica descrittiva organizza e riassume i dati già raccolti: conta, ordina, calcola medie. La statistica inferenziale, secondo OpenStax, è l’insieme dei metodi formali per trarre conclusioni da dati “buoni” (raccolti con criterio), e serve quando non è possibile osservare un intero gruppo. Per farlo servono due concetti chiave: la popolazione, cioè l’insieme di persone, cose o oggetti sotto studio, e il campione, cioè una porzione di quella popolazione selezionata per ricavarne informazioni. Un valore calcolato su tutta la popolazione si chiama parametro; lo stesso tipo di valore calcolato su un campione si chiama statistica campionaria, e viene usato per stimare il parametro corrispondente.

    AspettoStatistica descrittivaStatistica inferenziale
    Cosa faRiassume i dati disponibiliStima caratteristiche di una popolazione
    Su cosa lavoraL’intero insieme di dati raccoltiUn campione, una parte della popolazione
    Strumenti tipiciMedia, mediana, moda, deviazione standardStime, intervalli, test su un campione
    EsempioL’ISTAT conta i residenti in ItaliaUn sondaggio su mille persone stima un’opinione nazionale

    Un esempio concreto di statistica descrittiva pura è il censimento della popolazione: secondo l’ISTAT, al 30 giugno 2026 la popolazione residente in Italia ammontava a 58.943.673 unità. Non è una stima ricavata da un campione: è un conteggio, aggiornato periodicamente, dell’intera popolazione — il caso più semplice di statistica descrittiva applicata a un dato reale.

    Le misure che riassumono un gruppo di dati

    Per riassumere un insieme di numeri la statistica descrittiva usa tre misure di tendenza centrale. La media è la somma di tutti i valori divisa per il loro numero, la stessa operazione di somma e divisione che si incontra in Aritmetica applicata a un gruppo di dati invece che a due soli numeri. La mediana è il valore che sta al centro di una serie ordinata: almeno metà dei dati è minore o uguale a lei, almeno metà è maggiore o uguale. La moda, più semplicemente, è il valore che compare più spesso nella serie.

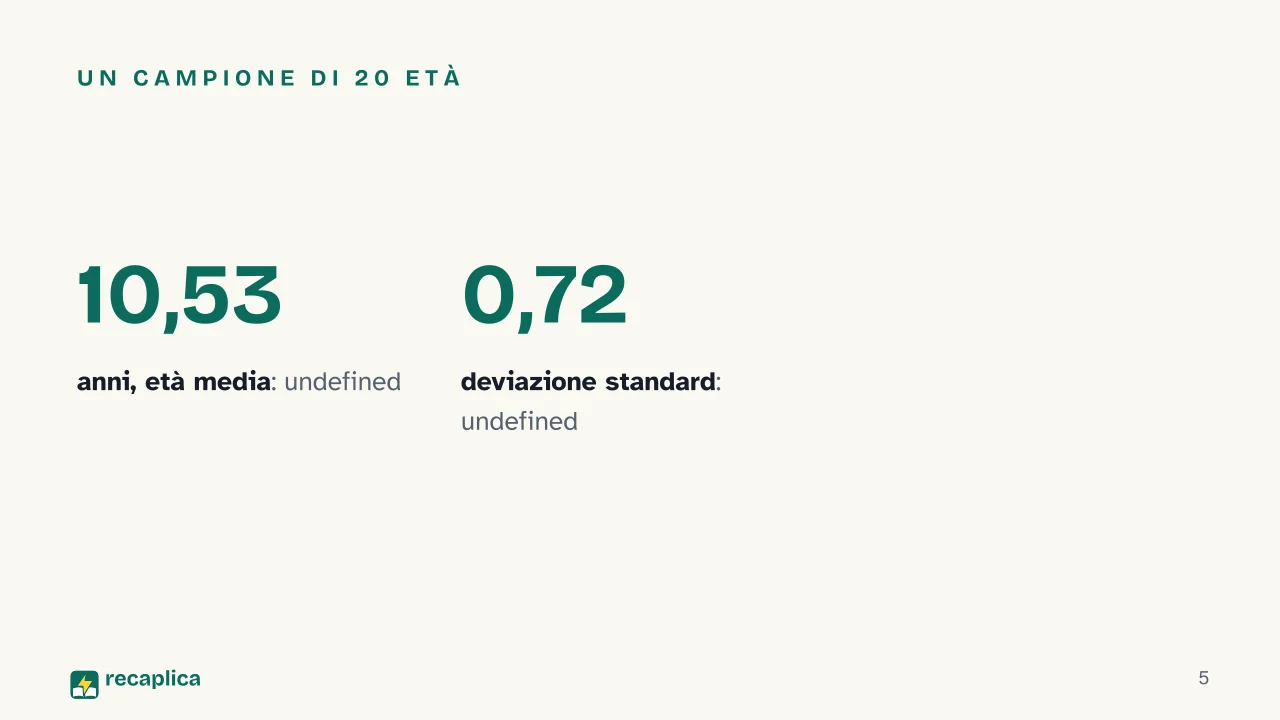
    Esempio pratico: OpenStax riporta le età di 20 studenti di una classe di quinta elementare: 9, 9,5, 9,5, 10, 10, 10, 10, 10,5, 10,5, 10,5, 10,5, 11, 11, 11, 11, 11, 11, 11,5, 11,5, 11,5. Sommando tutte le età e dividendo per 20 si ottiene una media di 10,53 anni. Ordinando la serie, il valore centrale (la mediana) cade proprio dentro il gruppo dei “10,5”, vicinissimo alla media: un segno che in questo caso i dati sono abbastanza simmetrici, senza valori fuori scala che tirino la media da una parte.

    Quando invece nella serie compaiono valori molto più alti o molto più bassi degli altri, media e mediana si allontanano. OpenStax lo mette in relazione diretta con la forma della distribuzione: la media risente degli outlier che non influenzano la mediana, per cui in una distribuzione asimmetrica verso sinistra la media è spesso minore della mediana, e in una asimmetrica verso destra la media è spesso maggiore. Per questo, quando si presenta un solo numero per descrivere un gruppo molto eterogeneo, la mediana è spesso la scelta più onesta.

    Quanto sono sparsi i dati: la deviazione standard

    Sapere solo la media di un gruppo di dati non basta: due classi possono avere la stessa età media e composizioni molto diverse, una con età tutte vicinissime tra loro, l’altra con bambini molto più piccoli e molto più grandi mescolati insieme. La deviazione standard è il numero che misura proprio questo: quanto, in media, i valori di una serie si allontanano dalla loro media. È piccola quando i dati sono concentrati vicino alla media, più grande quando i valori sono sparsi.

    Nell’esempio delle 20 età, la deviazione standard campionaria calcolata da OpenStax è 0,72: un valore basso, coerente con un gruppo di bambini quasi tutti coetanei. La formula usa le stesse lettere e gli stessi simboli con cui si scrivono le espressioni in Algebra: s = √[Σ(x − x̄)² / (n−1)], dove x̄ è la media e n il numero di valori. Un dettaglio tecnico spiega perché si elevano al quadrato le differenze dalla media invece di sommarle così come sono: se si sommano le deviazioni dalla media senza elevarle al quadrato, il risultato è sempre zero, perché gli scostamenti positivi e negativi si annullano a vicenda.

    Probabilità classica e probabilità frequentista

    Anche la probabilità ha più di un modo per essere calcolata. Secondo la Stanford Encyclopedia of Philosophy, l’interpretazione classica definisce la probabilità di un evento come la frazione tra il numero di casi in cui l’evento si verifica e il numero totale di casi possibili — una formulazione che risale al matematico Abraham de Moivre, che la descriveva come la frazione con al numeratore il numero di modi in cui un evento può accadere e al denominatore il numero totale di modi in cui può accadere o fallire.

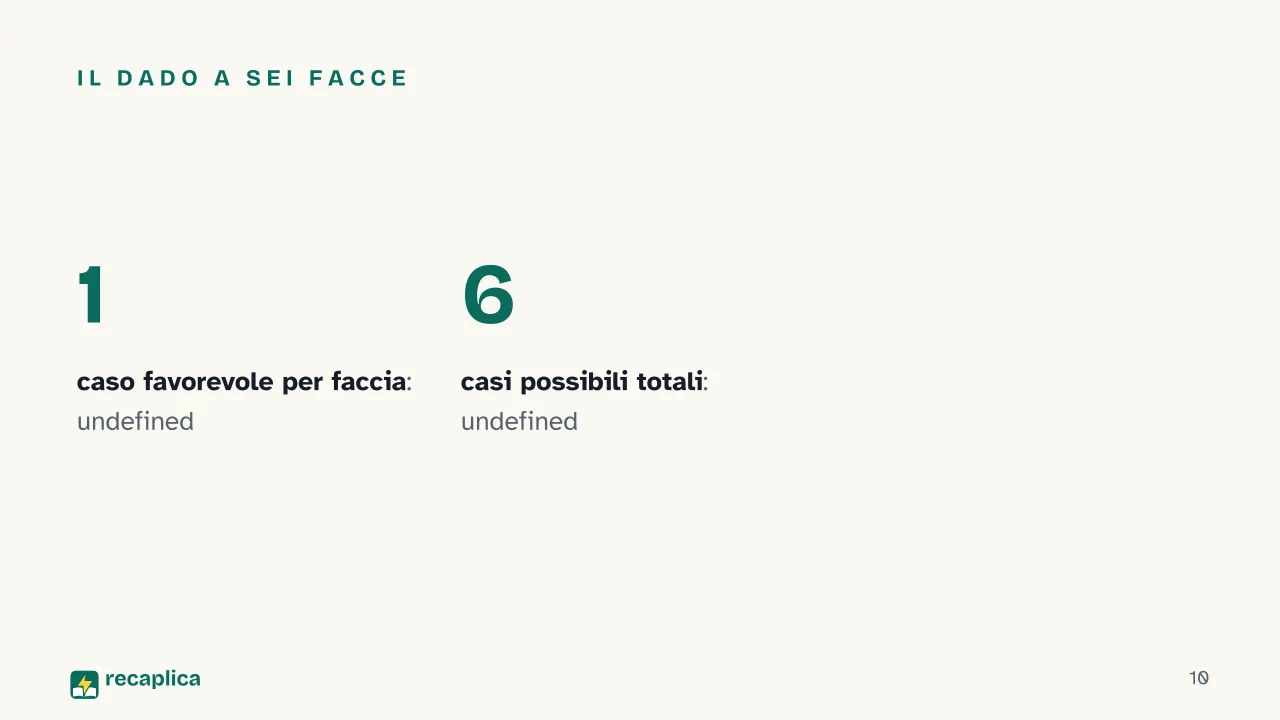
    Esempio pratico: un dado a sei facce ha sei esiti possibili, tutti ugualmente probabili per simmetria dell’oggetto: l’insieme di questi esiti si chiama spazio campionario. La probabilità classica di ottenere un 4 è quindi 1 caso favorevole su 6 casi possibili, cioè 1/6. Lo stesso ragionamento vale per una moneta: due esiti possibili, testa o croce, ciascuno con probabilità 1/2.

    La probabilità classica funziona bene quando gli eventi sono equiprobabili per costruzione, come le facce di un dado non truccato. Ma molti fenomeni reali non hanno questa simmetria nota in partenza: quante volte si guasta un macchinario in un anno non si può calcolare dividendo casi favorevoli per casi possibili. Qui entra la probabilità frequentista, definita dalla Stanford Encyclopedia of Philosophy come la frequenza relativa con cui un attributo si presenta effettivamente in una classe di riferimento: si osserva l’evento molte volte e si calcola quante volte, in proporzione, si è verificato. Più avanti nel percorso di matematica, quando queste frequenze osservate diventano distribuzioni continue da studiare con funzioni e limiti, ci si sposta già nel territorio dell’Analisi matematica.

    Eventi indipendenti e la gambler’s fallacy

    Due eventi si dicono indipendenti quando il verificarsi dell’uno non cambia la probabilità che si verifichi l’altro. Statistics LibreTexts definisce così l’indipendenza, ed è proprio questa proprietà a smontare uno degli errori più comuni legati al gioco d’azzardo.

    Esempio pratico: dopo cinque lanci di moneta consecutivi usciti tutti testa, molti pensano che al sesto lancio sia “più probabile” che esca croce, come se la moneta dovesse riequilibrare la sequenza. Statistics LibreTexts chiama questo ragionamento gambler’s fallacy: chi ci crede immagina un aggiustamento naturale che compensi una serie di teste con più croci in seguito. Ma la moneta non ha memoria dei lanci precedenti: al sesto lancio la probabilità di testa resta 1/2, esattamente come al primo.

    C’è un’osservazione che genera confusione ma va tenuta distinta da questo errore: su un numero molto grande di lanci, la proporzione di teste tende effettivamente ad avvicinarsi al 50%. Questo però non significa che i lanci passati influenzino quelli futuri: significa solo che, spalmato su moltissime prove indipendenti, ogni singolo lancio “raro” (tante teste di fila) pesa sempre meno sulla proporzione finale. La differenza è sottile ma precisa: nessun singolo lancio “si aggiusta”, è la media su tantissimi lanci a stabilizzarsi da sola.

    Presentazione

    Slide pronte da scaricare e fare tue in PowerPoint o Google Slides, con le note del relatore. Scegli il taglio Lampo o quello Completo.
    Slide 1 della presentazione su Probabilità e statistica: Probabilità e statisticaSlide 2 della presentazione su Probabilità e statistica: Cinque teste di fila, la sesta è più probabile croce?Slide 3 della presentazione su Probabilità e statistica: In quattro tappeSlide 4 della presentazione su Probabilità e statistica: Capitolo 01: Riassumere i datiSlide 5 della presentazione su Probabilità e statistica: Un campione di 20 etàSlide 6 della presentazione su Probabilità e statistica: Chi resiste agli estremiSlide 7 della presentazione su Probabilità e statistica: Capitolo 02: Stimare da un campioneSlide 8 della presentazione su Probabilità e statistica: Il gruppo intero · Una parte · La conclusioneSlide 9 della presentazione su Probabilità e statistica: Capitolo 03: Calcolare la probabilitàSlide 10 della presentazione su Probabilità e statistica: Il dado a sei facceSlide 11 della presentazione su Probabilità e statistica: Due modi di stimareSlide 12 della presentazione su Probabilità e statistica: Capitolo 04: Eventi che non si influenzanoSlide 13 della presentazione su Probabilità e statistica: Il sesto lancio non deve niente ai primi cinqueSlide 14 della presentazione su Probabilità e statistica: Perché la mediana resiste meglio della media ai valori estremi?Slide 15 della presentazione su Probabilità e statistica: Fine
    Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta15 slideTutti i capitoli e gli approfondimenti

    Falsi miti

    • ✗ Mito Molti credono che dopo tante teste di fila una coda sia ormai dovuta, per riequilibrare la sequenza.

      ✓ Realtà In realtà i lanci di una moneta sono eventi indipendenti: il risultato precedente non cambia la probabilità del successivo, che resta sempre 1/2, perché non esiste alcun meccanismo di compensazione tra un lancio e l'altro.

    • ✗ Mito Molti credono che la media sia sempre il numero che descrive meglio un gruppo di dati.

      ✓ Realtà In realtà pochi valori molto alti o molto bassi possono spostare parecchio la media, perché la somma di tutti i numeri ne risente; la mediana, che guarda solo la posizione di mezzo nella serie ordinata, non si muove per questi casi estremi.

    Mappa concettuale

    Trascina lo sfondo per muoverti e i nodi per riposizionarli; usa − e + per chiudere e aprire i rami.
    Personalizza
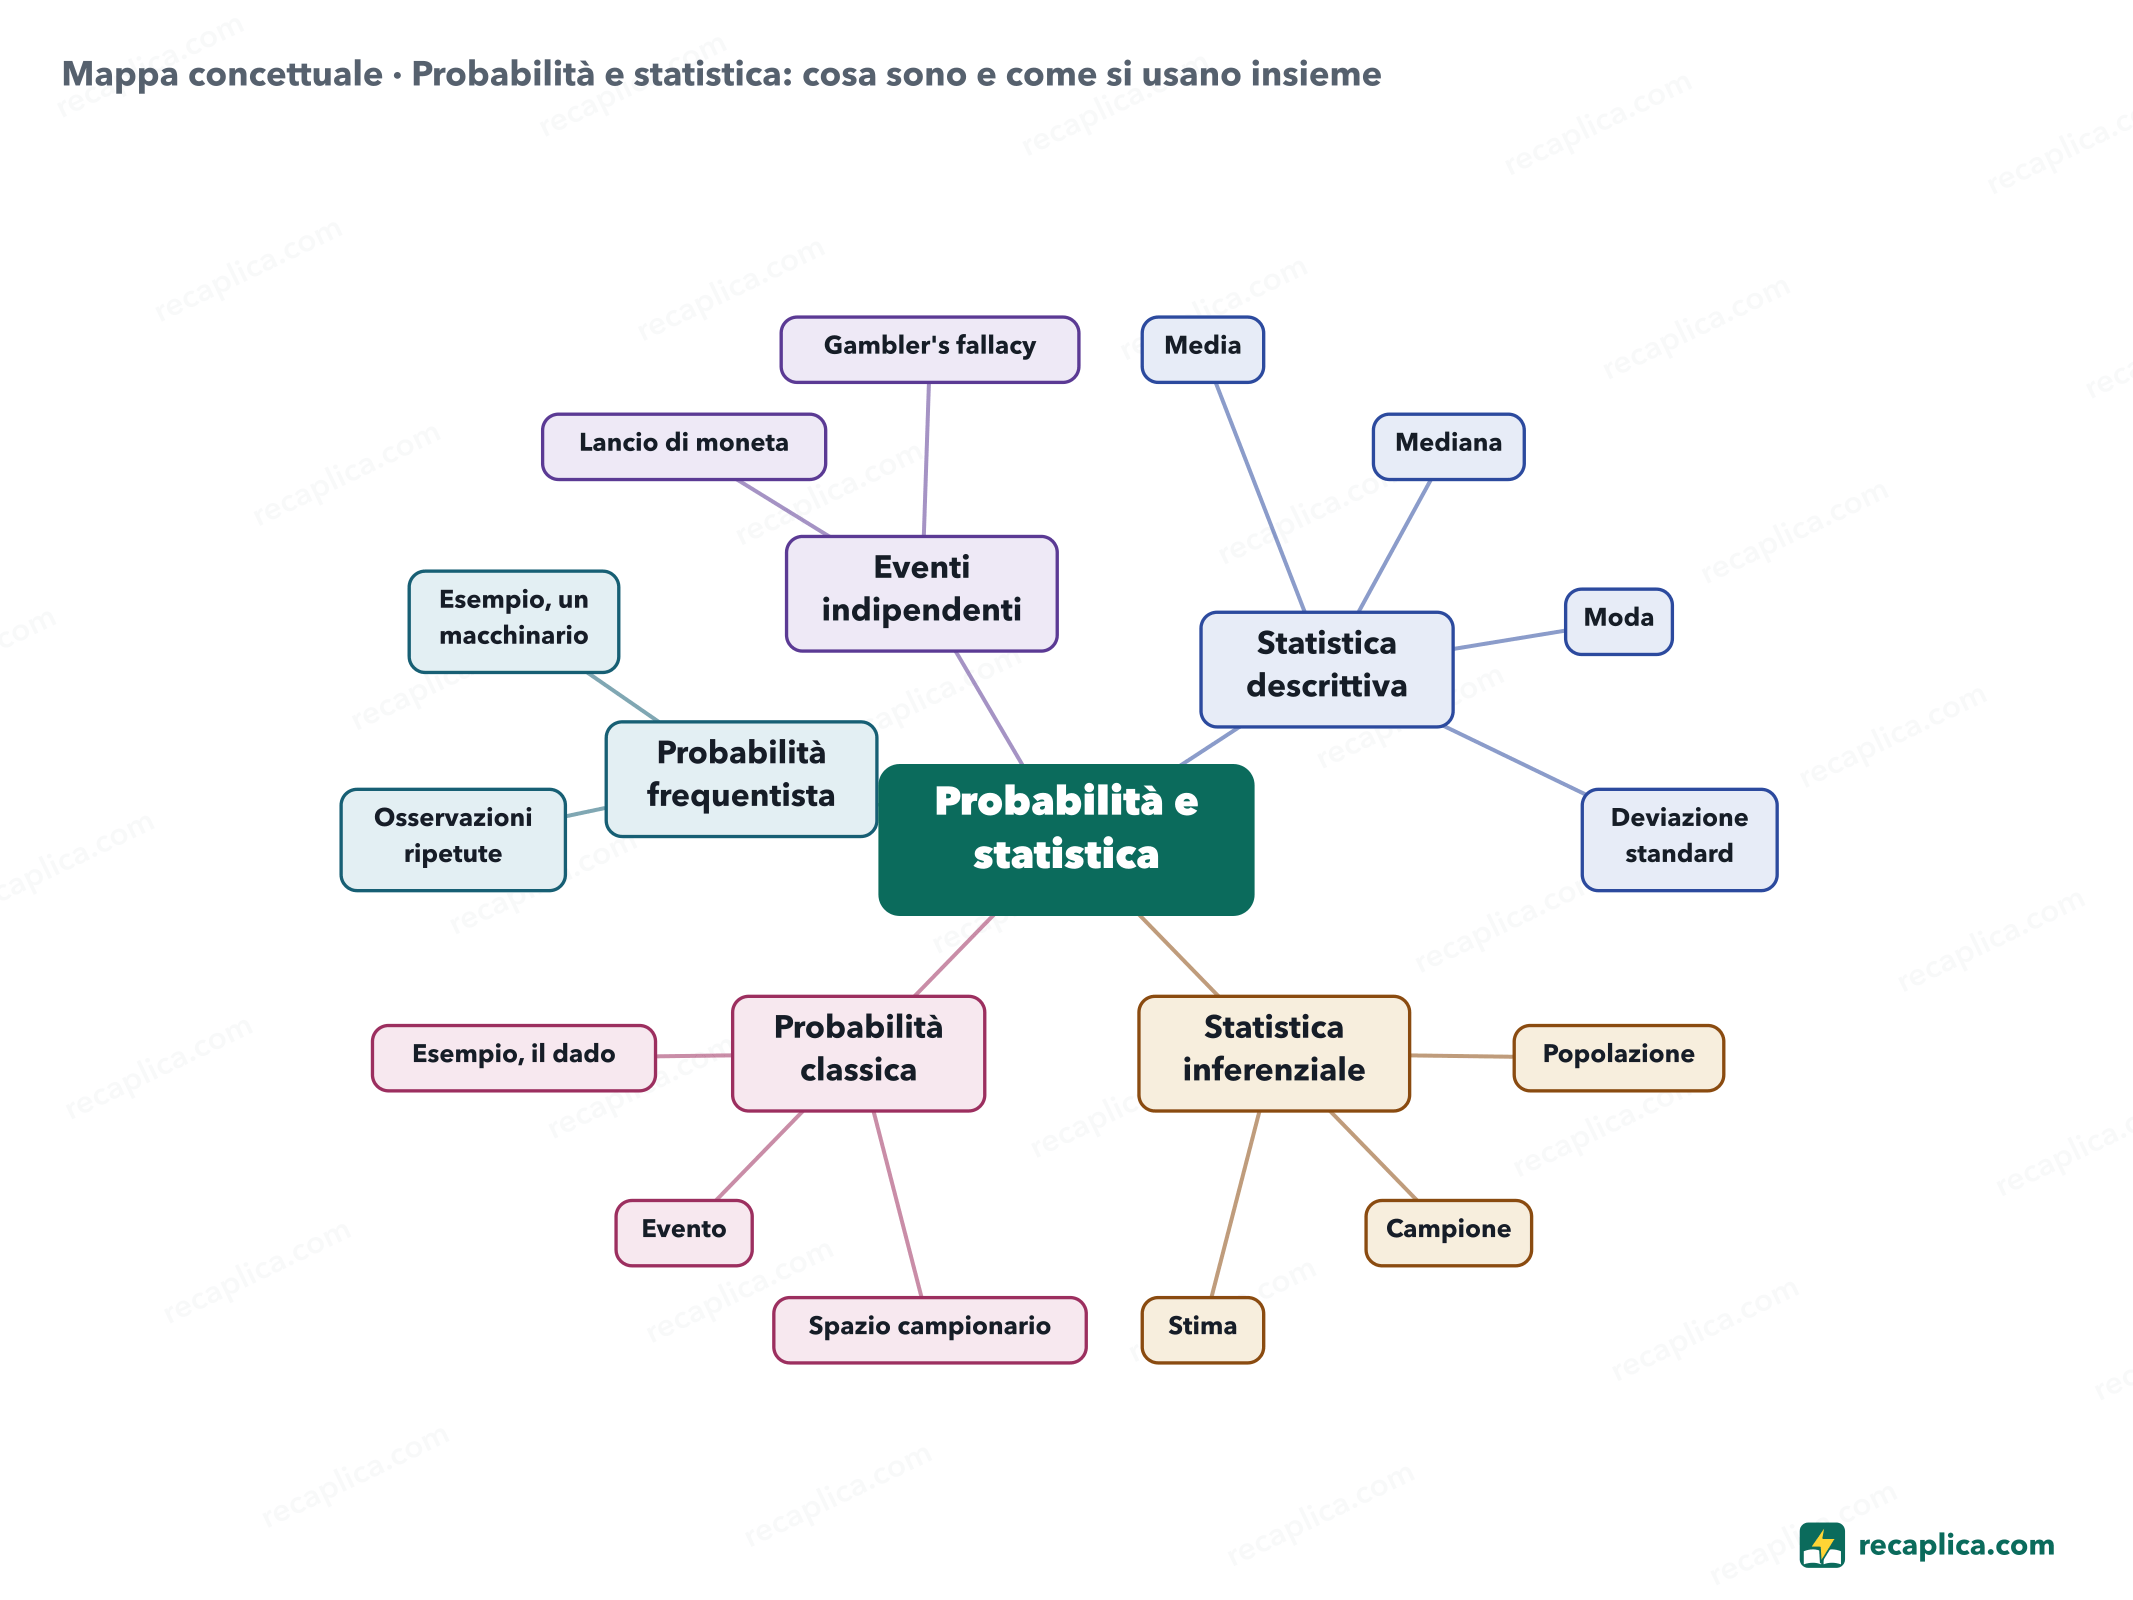
    Mappa concettuale: Probabilità e statistica: cosa sono e come si usano insieme
    • Probabilità e statistica
      • Statistica descrittiva Riassume i dati già raccolti
        • Media
        • Mediana
        • Moda
        • Deviazione standard
      • Statistica inferenziale Usa un campione per stimare una popolazione
        • Popolazione
        • Campione
        • Stima
      • Probabilità classica Casi favorevoli su casi possibili
        • Spazio campionario
        • Evento
        • Esempio, il dado
      • Probabilità frequentista Frequenza osservata su tante prove
        • Osservazioni ripetute
        • Esempio, un macchinario
      • Eventi indipendenti Un evento non cambia la probabilità dell'altro
        • Lancio di moneta
        • Gambler's fallacy

    Quiz: mettiti alla prova

    Rispondi alle domande per verificare quanto hai imparato: riceverai subito la correzione e una breve spiegazione.

    Voto 0/10 0/5
    1 Qual è la differenza principale tra statistica descrittiva e statistica inferenziale?

    La statistica descrittiva organizza e riassume i dati a disposizione; quella inferenziale usa un campione per stimare caratteristiche di una popolazione più grande.

    2 Come si calcola la probabilità classica di un evento?

    La probabilità classica è il rapporto tra i casi favorevoli e tutti i casi possibili, valido quando gli eventi sono equiprobabili, come nel lancio di un dado.

    3 Dopo cinque teste consecutive in un lancio di moneta, la probabilità che esca coda al lancio successivo aumenta.

    Falso: i lanci di moneta sono eventi indipendenti, quindi la probabilità di testa o croce resta sempre 1/2, indipendentemente dai lanci precedenti. Credere il contrario è la gambler's fallacy.

    4 Perché la mediana resiste meglio della media ai valori estremi (outlier)?

    La media somma tutti i valori e li divide per il loro numero, quindi un valore molto alto o molto basso la sposta; la mediana guarda solo la posizione centrale della serie ordinata, che resta stabile.

    5 Cosa misura la deviazione standard di un insieme di dati?

    La deviazione standard è piccola quando i dati sono concentrati vicino alla media e grande quando sono più sparsi: misura la dispersione dei valori intorno alla media.

    Risposte: 1-A · 2-A · 3-B · 4-A · 5-A

    Flashcards

    Tocca la carta per girarla e verifica se ricordi la risposta, poi passa alla successiva.

    1 / 8

    Spiegalo con parole tue

    Il test definitivo: se sai spiegarlo con parole semplici, lo hai capito davvero. Scrivi la tua spiegazione, poi confrontala col Recap.

    La tua spiegazione resta salvata solo su questo dispositivo.

    Probabilità e statistica sono due rami della matematica che studiano l'incertezza da direzioni opposte: la probabilità calcola in anticipo quanto è possibile che un evento accada, la statistica analizza dati già raccolti per descriverli o per trarre conclusioni su un gruppo più ampio. Nei programmi di matematica del biennio si studiano insieme perché condividono gli stessi strumenti di base, dall'idea di evento a quella di campione. La statistica si divide a sua volta in descrittiva, che riassume i dati con numeri come media e deviazione standard, e inferenziale, che usa un campione per stimare una popolazione intera. La probabilità, dal canto suo, si calcola in modo diverso a seconda che gli eventi siano equiprobabili (probabilità classica, come un dado) oppure osservati nel tempo (probabilità frequentista, come i guasti di un macchinario).

    Domande e risposte

    Che differenza c'è tra probabilità e statistica?

    Sta nel momento in cui si applicano: la probabilità entra in gioco prima che un evento accada, per calcolare quanto è plausibile; la statistica entra in gioco dopo, quando i dati sono già stati raccolti, per riassumerli o per stimare un gruppo più ampio a partire da un campione. Nei programmi di matematica del biennio si studiano insieme perché condividono gli stessi strumenti di base, come il concetto di evento e di campione.

    Cos'è la statistica descrittiva e inferenziale insieme?

    È l'insieme dei due approcci della statistica: quello descrittivo riassume i dati con numeri come media e deviazione standard, quello inferenziale usa un campione per stimare i valori di una popolazione più grande, quando non è possibile osservarla tutta.

    Come si calcola la media di un gruppo di numeri?

    Si sommano tutti i valori e si divide il risultato per il numero di valori; sommando per esempio le età di un gruppo di studenti e dividendo per il numero di studenti si ottiene l'età media del gruppo.

    Cos'è la gambler's fallacy?

    È l'errore di pensare che, dopo una serie di risultati uguali (per esempio cinque teste di fila in un lancio di moneta), il risultato opposto sia più probabile al lancio successivo. In realtà i lanci sono eventi indipendenti e la probabilità resta sempre la stessa.

    A cosa serve la deviazione standard?

    Serve a capire quanto i dati di una serie sono concentrati vicino alla media o sparsi lontano da essa: un valore piccolo indica dati vicini alla media, un valore grande indica dati più dispersi.

    Fonti consultate

    • OpenStax, Introductory Statistics 2e
    • Stanford Encyclopedia of Philosophy, Interpretations of Probability
    • Statistics LibreTexts, Gambler's Fallacy
    • ISTAT, Popolazione residente

    Ogni Recap passa da una revisione indipendente prima della pubblicazione.

    Ogni sera, i nuovi Recap del giorno sul canale Telegram. Iscriviti al canale →

    Continua a imparare

    • Scienza Carico cognitivo, cos'è secondo la teoria di Sweller Il carico cognitivo è la quantità di risorse della memoria di lavoro che un compito impegna mentre si impara qualcosa di nuovo. Lo psicologo John Sweller lo descrive per la prima volta nel 1988, partendo dallo studio della risoluzione di problemi: una strategia troppo articolata lascia poco spazio per costruire schemi mentali stabili. La letteratura successiva distingue tre tipi di carico, intrinseco, estraneo e pertinente, anche se una parte dei ricercatori considera il terzo indistinguibile dal primo. Ridurre il carico estraneo, con esempi svolti o materiali meno ridondanti, lascia più margine mentale per imparare davvero. Leggi il Recap →
    • Scienza Cognitivismo: la mente come elaboratore di informazioni Il cognitivismo è il paradigma della psicologia che descrive la mente come un sistema che elabora informazioni, tra percezione, memoria, ragionamento e linguaggio. Nasce intorno al 1956, quando il comportamentismo di Watson e Skinner dominava ancora la scena accademica e riduceva la psicologia allo studio di stimoli e risposte osservabili. Nello stesso anno George Miller mostra i limiti della memoria a breve termine, mentre Chomsky, McCarthy, Minsky, Newell e Simon pongono le basi della scienza cognitiva. Donald Broadbent nel 1958 e Ulric Neisser nel 1967, il cui libro mette in uso comune l'espressione psicologia cognitiva, completano il quadro dei suoi protagonisti. Leggi il Recap →
    • Scienza Comportamentismo: cosa sostiene e da dove nasce Il comportamentismo è la corrente della psicologia che studia solo il comportamento osservabile, non i pensieri o le emozioni che restano nascosti dentro la mente. Nasce nel 1913, quando lo psicologo statunitense John B. Watson pubblica un saggio che chiede alla psicologia di diventare una scienza sperimentale, senza affidarsi all'introspezione. Dopo di lui, Ivan Pavlov studia i riflessi condizionati e Edward Thorndike l'apprendimento per prove ed errori; Burrhus Skinner porta le idee al punto più estremo con il comportamentismo radicale. Il filo comune è lo schema stimolo-risposta: un comportamento si spiega guardando cosa lo precede e cosa lo segue, non indovinando cosa succede nella testa di chi lo compie. Leggi il Recap →

    recaplica

    Chiaro in 30 secondi, tuo in 10 minuti.

    I Recap Mappe concettuali Chiedi un Recap Canale Telegram Crea una mappa concettuale Il metodo Chi siamo Privacy e cookie Note legali e condizioni d'uso

    © 2026 Recaplica · Un progetto di Curi S.r.l. — P. IVA 05472000750

    Statistiche, solo se vuoi

    Per capire quali Recap aiutano di più useremmo Google Analytics, con dati aggregati e anonimi. Parte solo col tuo ok, e puoi cambiare idea quando vuoi. Informativa privacy