|
recaplica
Filter bubble: come funzionano gli algoritmi di raccomandazione | |||||||||||||||
| © 2026 Recaplica · recaplica.com — Tutti i diritti riservati | |||||||||||||||
Filter bubble: come funzionano gli algoritmi di raccomandazioneCosa stampare Con "Margini: predefiniti" compaiono anche i numeri di pagina. SlideScegli il taglio Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta15 slideTutti i capitoli e gli approfondimentiTutte e due hanno le note del relatore. In 30 secondi lettura lampoUn filter bubble è la bolla di contenuti simili che un algoritmo di raccomandazione costruisce intorno a un utente, filtrando in modo implicito cosa mostrargli in base ai suoi comportamenti passati. Il termine, coniato da Eli Pariser nel 2011, viene spesso confuso con l'echo chamber, un fenomeno sociale più vecchio e non necessariamente legato agli algoritmi. La ricerca più solida disponibile racconta un quadro con più sfumature di quanto si creda: gli algoritmi hanno un effetto misurabile ma modesto, e le scelte delle persone pesano di più. Il nesso diretto tra algoritmi e polarizzazione politica non è stabilito con certezza dagli esperimenti più rigorosi condotti finora. Punti Chiave
I numeri chiave
L'ApprofondimentoUn filter bubble non è un muro: è un filtro che si stringe un poco alla volta, senza che nessuno lo decida esplicitamente. L’espressione è stata resa pubblica da Eli Pariser nel libro The Filter Bubble, uscito nel 2011, per descrivere il rischio che gli algoritmi di personalizzazione costruiscano attorno a ogni persona un universo di informazioni su misura, fatto soprattutto di ciò che quella persona ha già dimostrato di gradire. Filter bubble ed echo chamber non sono la stessa cosaI due termini vengono usati come sinonimi, ma descrivono meccanismi diversi. Il filter bubble nasce da un algoritmo: è il sistema che, in modo implicito e senza che l’utente lo chieda, decide cosa mostrargli sulla base del suo comportamento passato. L’echo chamber, invece, è un fenomeno sociale descritto in letteratura accademica già nel 2008, quando i ricercatori Kathleen Hall Jamieson e Joseph Cappella la definirono come uno spazio mediatico chiuso, capace di amplificare i messaggi al suo interno e di isolarli dalle repliche esterne. La differenza pratica è questa: un’echo chamber può formarsi anche senza alcun algoritmo, semplicemente perché una persona sceglie di frequentare solo fonti e persone che condividono le sue idee. Un filter bubble, per definizione, ha sempre un sistema automatico di mezzo. Come funziona davvero un algoritmo di raccomandazioneGli algoritmi che popolano i feed dei social network e i suggerimenti delle piattaforme di streaming si basano tipicamente su due tecniche, spesso combinate: il collaborative filtering, che impara dai comportamenti di altri utenti con gusti simili, e il content-based filtering, che impara dalle caratteristiche di ciò che una persona ha già visto o apprezzato. Sono tecniche di machine learning: il sistema non segue regole scritte a mano, ma trova pattern nei dati. Un paper di Google Research del 2016 descrive nel dettaglio l’architettura usata per le raccomandazioni di YouTube, uno dei sistemi di questo tipo più grandi al mondo per scala e sofisticazione. Il sistema lavora in due fasi separate: un primo modello di “candidate generation” restringe un catalogo enorme di video a un sottoinsieme ristretto di candidati plausibili, usando come segnali lo storico di visione e alcuni dati demografici tramite una rete neurale; un secondo modello, distinto, si occupa solo del ranking, cioè dell’ordine in cui quei candidati vengono proposti. È un paper del 2016: l’architettura reale di YouTube è verosimilmente cambiata da allora, ma lo schema a due stadi resta il modo standard di spiegare come funzionano questi sistemi, incluse le reti neurali che li fanno funzionare.
Cosa dice davvero la ricerca sulla polarizzazioneLa sintesi più diffusa — “gli algoritmi ci polarizzano” — non trova conferma netta negli studi più rigorosi disponibili. Secondo lo studio pubblicato su Science nel 2015 da Bakshy, Messing e Adamic, su un campione di 10,1 milioni di utenti Facebook che avevano dichiarato il proprio orientamento politico, l’algoritmo del News Feed ha ridotto la probabilità di vedere contenuti che sfidavano le idee di ciascun utente, rispetto a quanto condiviso dai suoi contatti: del 5% per i conservatori e dell’8% per i progressisti. Ma lo stesso studio ha misurato un effetto in parte diverso sull’altro lato: quando quei contenuti comparivano comunque, i conservatori hanno cliccato il 17% in meno e i progressisti il 6% in meno. La conclusione degli autori è che, nel complesso, le scelte individuali pesano di più dell’ordinamento algoritmico nel limitare l’esposizione a idee diverse — anche se, scomponendo il dato, per i progressisti l’effetto dell’algoritmo (8%) risulta leggermente superiore a quello delle proprie scelte di clic (6%). Otto anni dopo, un pacchetto di quattro studi indipendenti — condotti da ricercatori di università come Princeton, Dartmouth e la University of Texas in collaborazione con Meta, e pubblicati nel 2023 su Science e Nature — ha messo alla prova la stessa domanda con un esperimento vero, durante le elezioni presidenziali statunitensi del 2020. A 23.377 utenti Facebook è stata ridotta artificialmente, per tre mesi, l’esposizione a contenuti da fonti simili alle proprie: dal 53,7% al 36,2%, una riduzione di circa un terzo. Il risultato non ha mostrato alcun effetto misurabile su otto diverse misure di atteggiamento pre-registrate, tra cui la polarizzazione affettiva, l’estremismo ideologico e la fiducia in affermazioni false. Un esperimento collegato, che ha rimosso i contenuti ricondivisi dal feed per lo stesso periodo, ha fatto calare la conoscenza delle notizie tra i partecipanti senza incidere in modo significativo sulla polarizzazione o su altri atteggiamenti politici. Va detto con onestà che questi studi sono stati condotti in collaborazione con Meta, proprietaria della piattaforma studiata: un potenziale conflitto di interesse sollevato anche da alcuni ricercatori accademici, che invita a leggere i risultati come un tassello importante e non come la parola definitiva sul tema. Il quadro si allarga con i dati del Digital News Report, analizzati dal Reuters Institute su un confronto tra sette paesi. Nel Regno Unito, nel 2020, solo circa il 2% delle persone viveva in un’echo chamber di sinistra e circa il 5% in una di destra: quote piccole, in un paese dove la maggior parte delle persone continua a informarsi da un mix di fonti diverse. Gli Stati Uniti restano l’eccezione, con una quota complessiva sopra il 10%. La stessa rassegna segnala un altro dato che smentisce l’idea di un isolamento crescente: chi usa i social media per informarsi, soprattutto su piattaforme come YouTube e Twitter, tende a imbattersi per caso in notizie che non stava cercando, un effetto di esposizione incidentale che in alcuni casi amplia la dieta informativa invece di restringerla. Perché la cautela non è un dettaglioTrattare come certo un legame che gli studi non confermano con chiarezza porta a due errori opposti: sottovalutare il ruolo reale, per quanto modesto, che l’algoritmo ha nel modellare cosa vediamo, oppure caricare sugli algoritmi una responsabilità che i dati non sostengono, distogliendo l’attenzione dalle scelte delle persone e dal contesto sociale in cui si formano le opinioni. Riconoscere cosa la intelligenza artificiale fa davvero — selezionare e ordinare, non decidere al posto di qualcuno — aiuta anche a leggere con più occhio critico i contenuti che compaiono nel proprio feed, la stessa competenza richiesta per riconoscere le fake news che circolano online. PresentazioneSlide pronte da scaricare e fare tue in PowerPoint o Google Slides, con le note del relatore. Scegli il taglio Lampo o quello Completo.     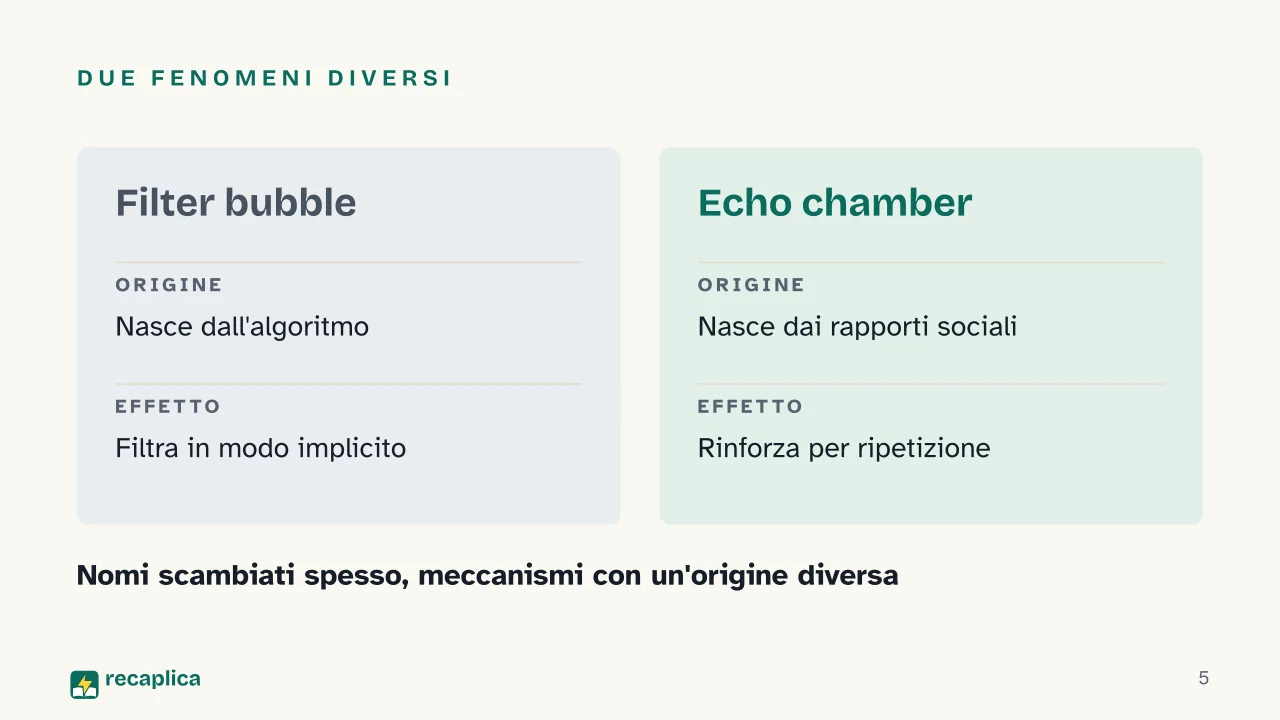  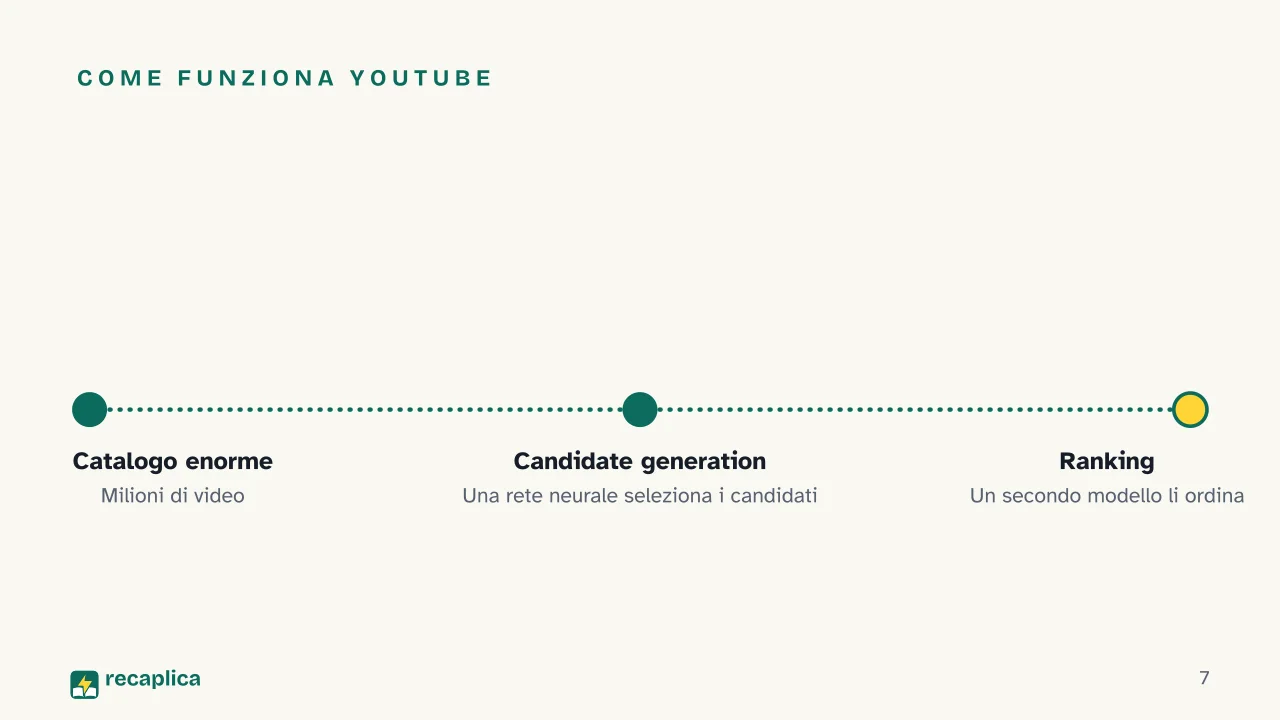 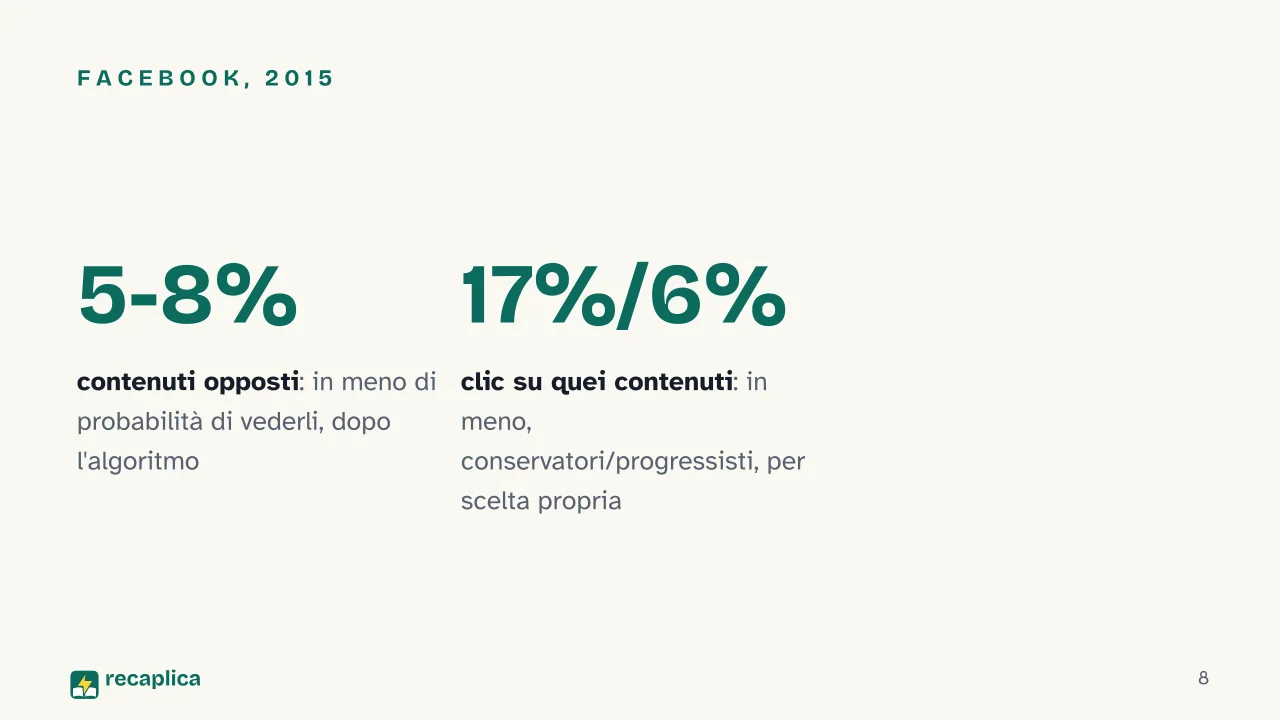  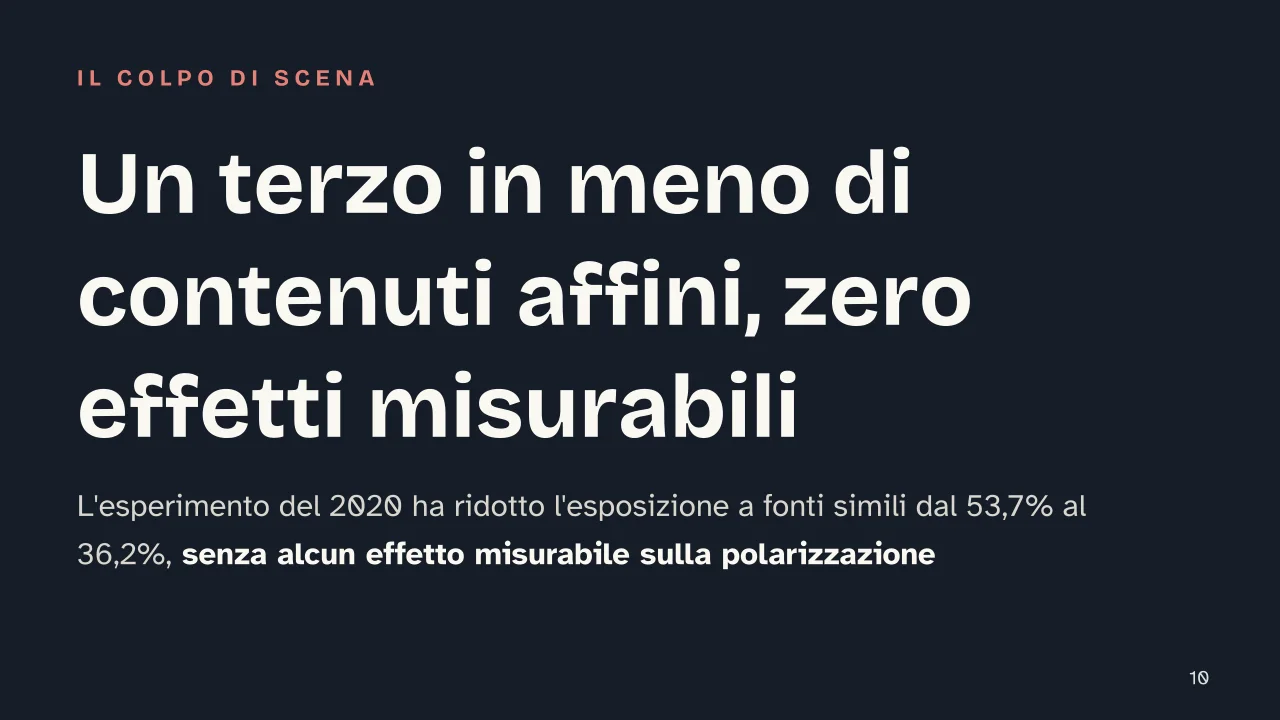 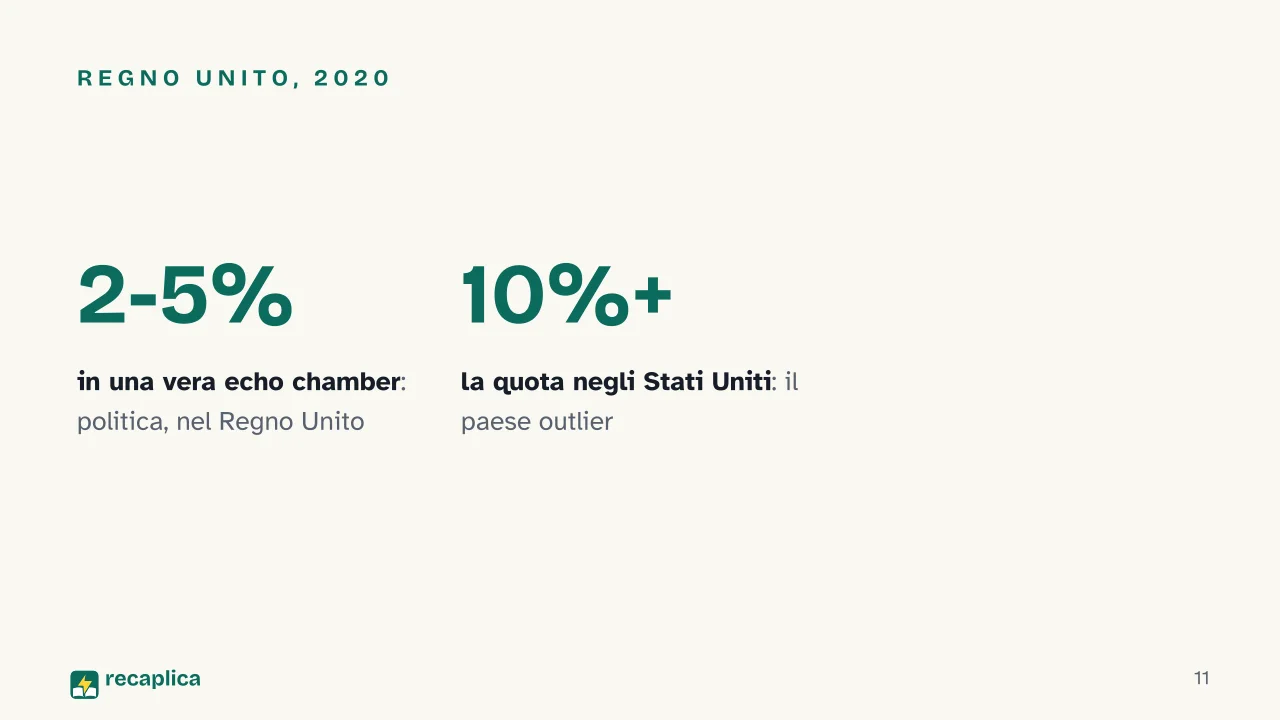  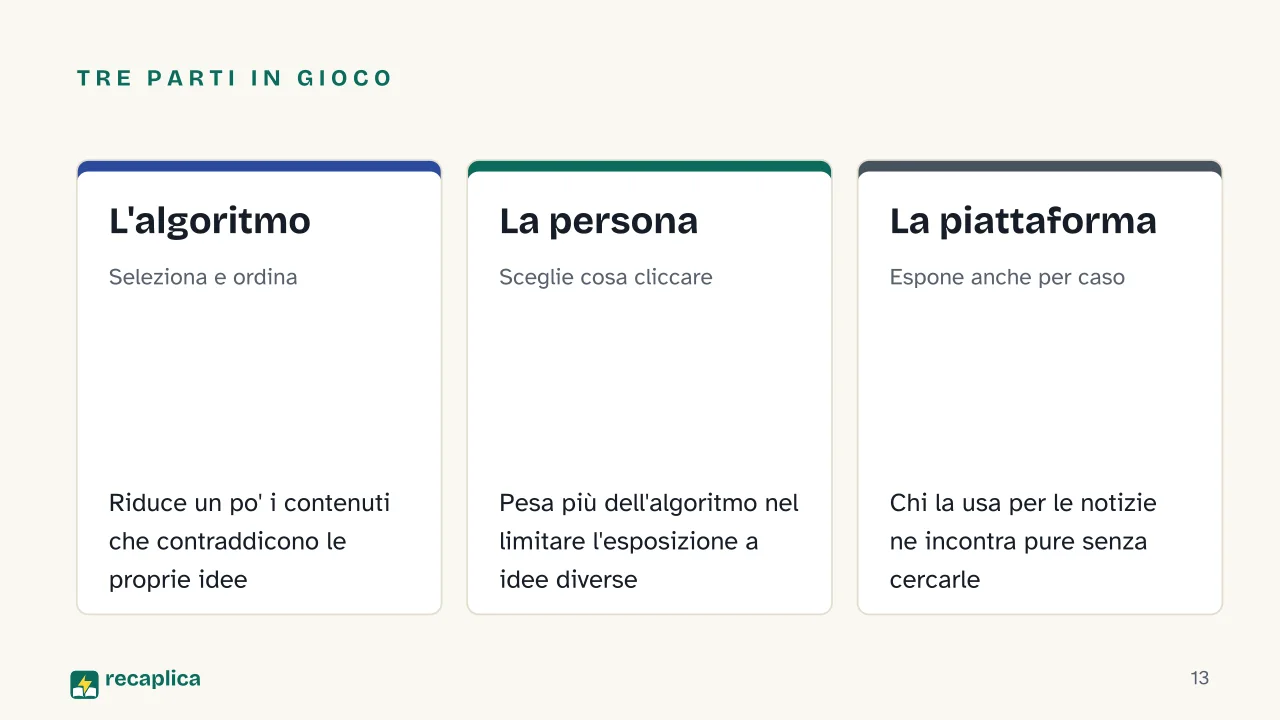   Falsi miti
Mappa concettualeTrascina lo sfondo per muoverti e i nodi per riposizionarli; usa − e + per chiudere e aprire i rami. 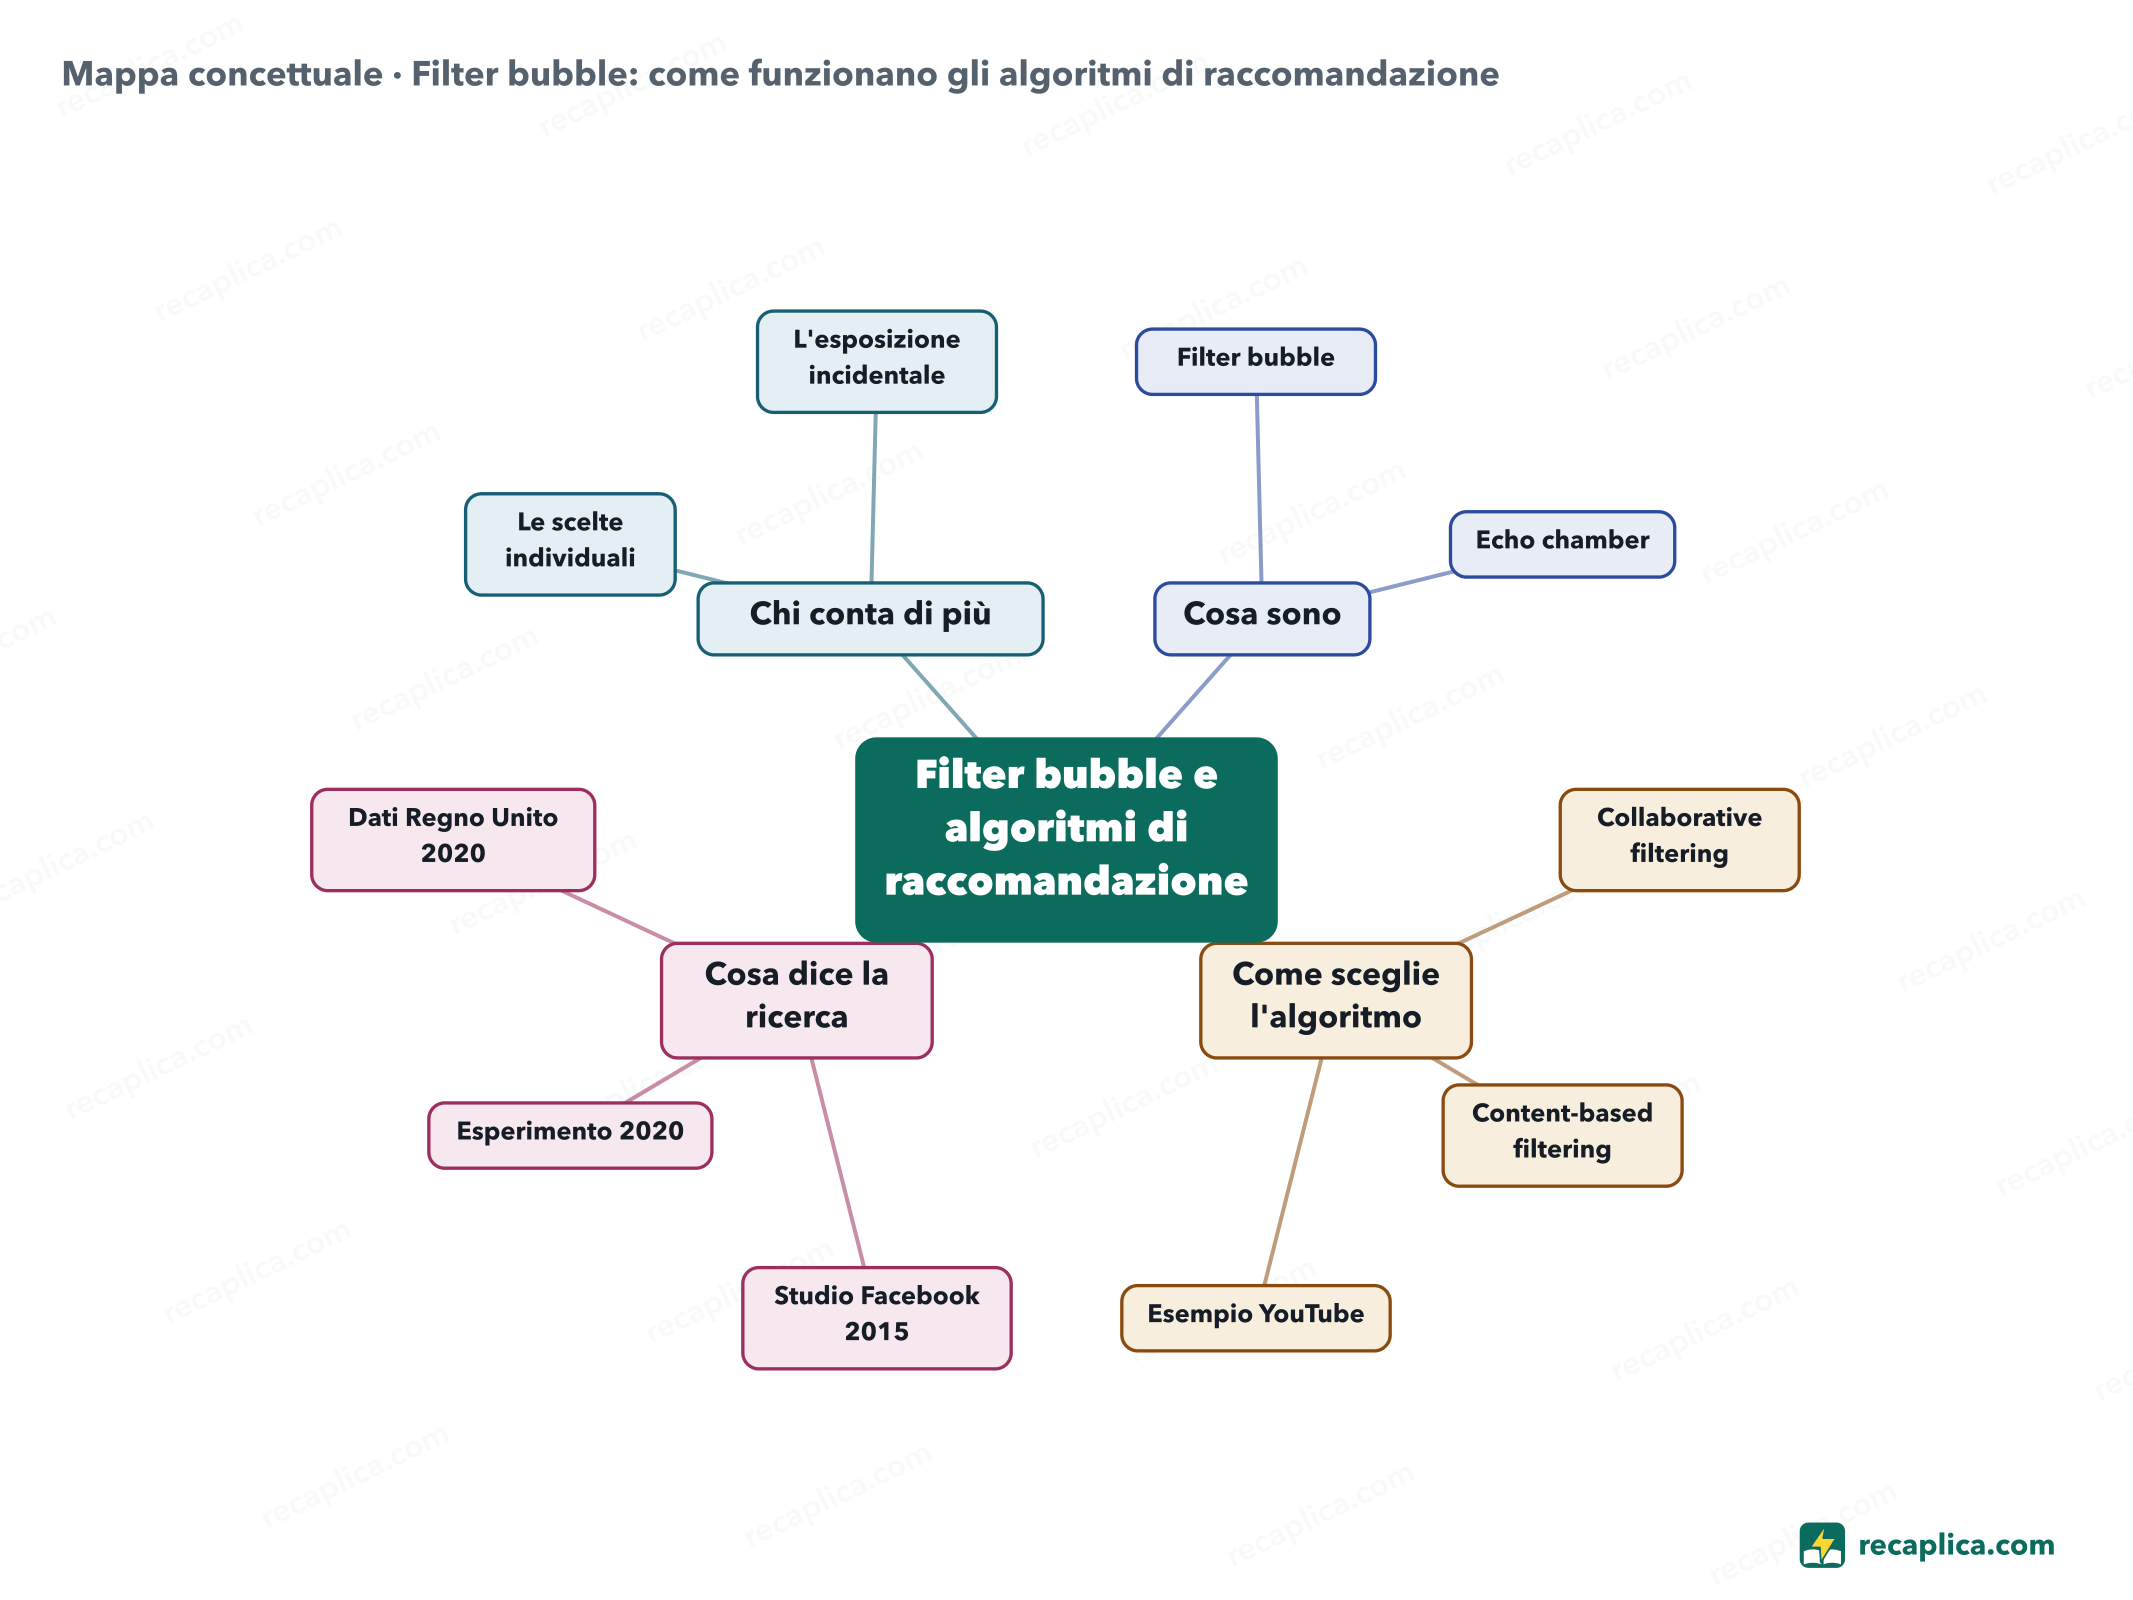
Quiz: mettiti alla provaRispondi alle domande per verificare quanto hai imparato: riceverai subito la correzione e una breve spiegazione. Voto 0/10 0/5
FlashcardsTocca la carta per girarla e verifica se ricordi la risposta, poi passa alla successiva. 1 / 7 Spiegalo con parole tueIl test definitivo: se sai spiegarlo con parole semplici, lo hai capito davvero. Scrivi la tua spiegazione, poi confrontala col Recap. La tua spiegazione resta salvata solo su questo dispositivo.
Domande e risposteCos'è un filter bubble?È la bolla di contenuti simili tra loro che un algoritmo di raccomandazione costruisce intorno a una persona, filtrando in modo implicito cosa mostrarle in base al suo comportamento passato (cosa ha guardato, cliccato, apprezzato). Il termine è stato coniato da Eli Pariser nel libro del 2011. Gli algoritmi di raccomandazione causano la polarizzazione politica?Non è stabilito con certezza. Uno studio del 2015 su Facebook ha trovato un effetto dell'algoritmo modesto rispetto alle scelte individuali; un esperimento del 2020, pubblicato nel 2023 su Nature, ha ridotto di un terzo l'esposizione a fonti affini senza trovare effetti misurabili sulla polarizzazione. La ricerca più rigorosa disponibile non conferma un nesso causale diretto. Qual è la differenza tra filter bubble ed echo chamber?La filter bubble nasce dalla personalizzazione algoritmica: è l'algoritmo a filtrare i contenuti in modo implicito. L'echo chamber è un fenomeno sociale più ampio, descritto in letteratura già dal 2008, che riguarda le persone e le fonti che si scelgono di frequentare, e può esistere anche senza alcun algoritmo di mezzo. Quante persone vivono davvero in una echo chamber?Meno di quanto si creda. Nel Regno Unito, nel 2020, solo il 2-5% della popolazione viveva in una vera echo chamber politica. Gli Stati Uniti sono un'eccezione, con una quota sopra il 10%, ma restano un caso fuori dalla media degli altri paesi monitorati. Come funziona in pratica un algoritmo di raccomandazione come quello di YouTube?In due fasi separate, secondo un paper di Google Research del 2016: prima un modello di "candidate generation" restringe un catalogo enorme di video a un gruppo ristretto di candidati plausibili, usando lo storico di visione dell'utente; poi un modello di ranking distinto ordina quei candidati per decidere cosa proporre per primo. Ogni Recap passa da una revisione indipendente prima della pubblicazione. |