|
recaplica
Le reti neurali: come funzionano davvero |
| © 2026 Recaplica · recaplica.com — Tutti i diritti riservati |
Le reti neurali: come funzionano davveroCosa stampare Con "Margini: predefiniti" compaiono anche i numeri di pagina. SlideScegli il taglio Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta17 slideTutti i capitoli e gli approfondimentiTutte e due hanno le note del relatore. In 30 secondi lettura lampoUna rete neurale è un sistema di migliaia di semplici unità di calcolo collegate a strati da milioni (o miliardi) di connessioni pesate, ispirato alla lontana ai neuroni del cervello. Ogni collegamento ha un peso regolabile: durante l'addestramento la rete aggiusta i pesi finché gli esempi producono le risposte giuste. Con molti strati diventa deep learning, la tecnologia dietro riconoscimento di immagini, voce e grandi modelli linguistici. Punti Chiave
I numeri chiave
L'ApprofondimentoUn’orchestra di calcolatori minuscoliDimentica il cervello elettronico dei film. Una rete neurale è qualcosa di più umile e più sorprendente: migliaia di unità di calcolo semplicissime, collegate tra loro a strati da milioni (nei modelli moderni, miliardi) di connessioni pesate. Come spiega il MIT, ogni nodo fa una cosa sola: riceve numeri dai collegamenti in ingresso, li moltiplica per i rispettivi pesi, somma tutto e confronta il risultato con una soglia. Sopra la soglia, il nodo “si accende” e passa il segnale allo strato successivo; sotto, tace. Nessuna di queste unità sa niente. L’intelligenza — se vogliamo chiamarla così — sta tutta nei pesi: milioni, oggi miliardi, di manopole che decidono quanto conta ogni collegamento. L’addestramento: regolare le manopoleEcco il punto che sorprende chiunque lo scopra: all’inizio i pesi sono numeri casuali. La rete appena nata non sa fare letteralmente nulla. Poi comincia lo studio. Le si mostra un esempio — una foto etichettata “gatto” — e si guarda cosa esce dall’ultimo strato. Risposta sbagliata? Un algoritmo di correzione ritocca i pesi, appena appena, nella direzione che avrebbe reso la risposta meno sbagliata. Si ripete con il secondo esempio, il millesimo, il milionesimo. A furia di micro-ritocchi, la rete arriva a dare con costanza risposte giuste anche su input mai visti.
Perché “profonde”: il potere degli stratiCon pochi strati una rete impara relazioni semplici. Il salto di qualità arriva quando gli strati diventano tanti — è il significato di deep in deep learning. In una rete per immagini, i primi strati imparano a cogliere bordi e contrasti; quelli intermedi combinano i bordi in forme; gli ultimi combinano le forme in oggetti. Questa gerarchia di astrazioni non la progetta nessuno: emerge da sola dall’addestramento. È lo stesso principio che, applicato al testo su scala colossale, produce i modelli dietro l’IA generativa: GPT-3 è una rete da 175 miliardi di pesi. Le manopole si sono moltiplicate a dismisura; il principio è rimasto quello del 1957. Una storia a montagne russeGià, il 1957: le reti neurali sono tutt’altro che nuove. La teoria nasce nel 1944 con Warren McCullough e Walter Pitts; nel 1957 Frank Rosenblatt presenta il Perceptron, la prima rete addestrabile. Poi una critica influente (Minsky e Papert, 1969) congela i finanziamenti per anni; gli anni Ottanta portano una rinascita, gli anni Duemila un nuovo inverno a favore di altri metodi. La svolta definitiva arriva con le GPU, le schede grafiche: nate per i videogiochi, si rivelano perfette per i miliardi di moltiplicazioni parallele dell’addestramento. Da lì, reti a decine di strati, dati su scala di internet, e il deep learning che esce dai laboratori per entrare nei telefoni. Per collocare il pezzo nel puzzle: le reti neurali sono il motore più potente del machine learning, e quello che una rete esegue resta un algoritmo, con tutti i suoi passi ben definiti. La rete non sa di essere intelligente. Esegue, e questo le basta. PresentazioneSlide pronte da scaricare e fare tue in PowerPoint o Google Slides, con le note del relatore. Scegli il taglio Lampo o quello Completo.     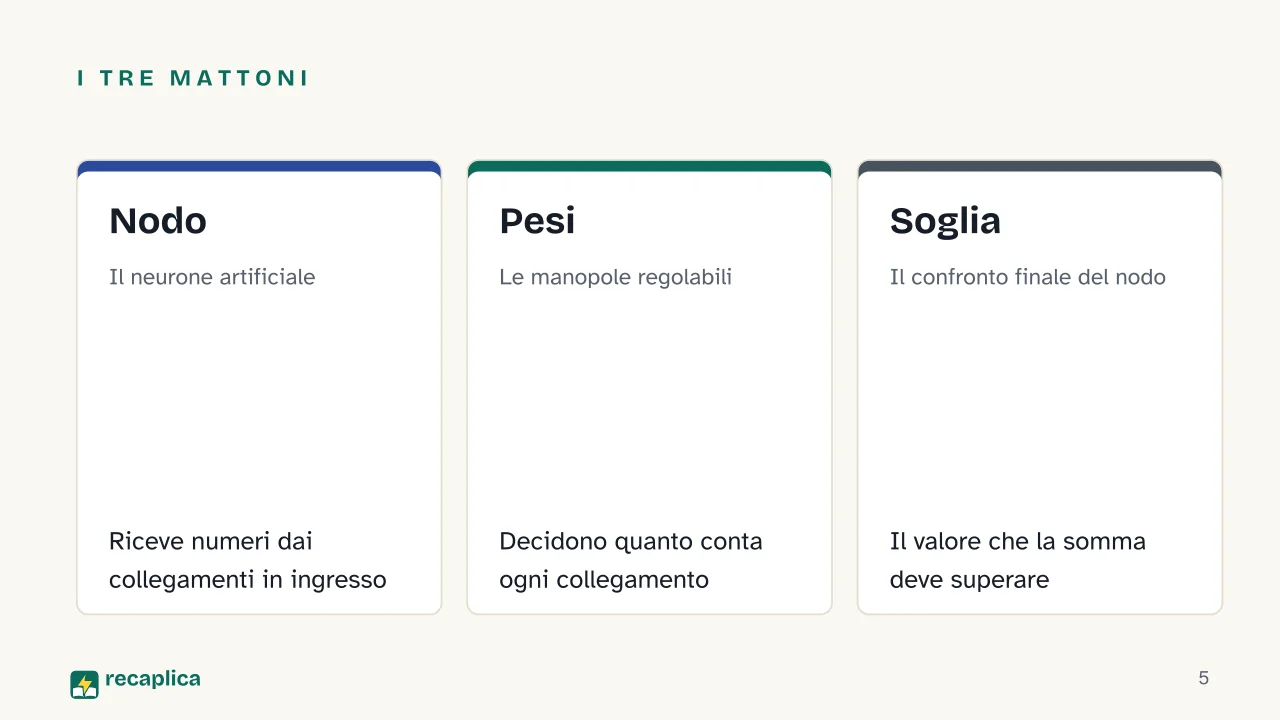   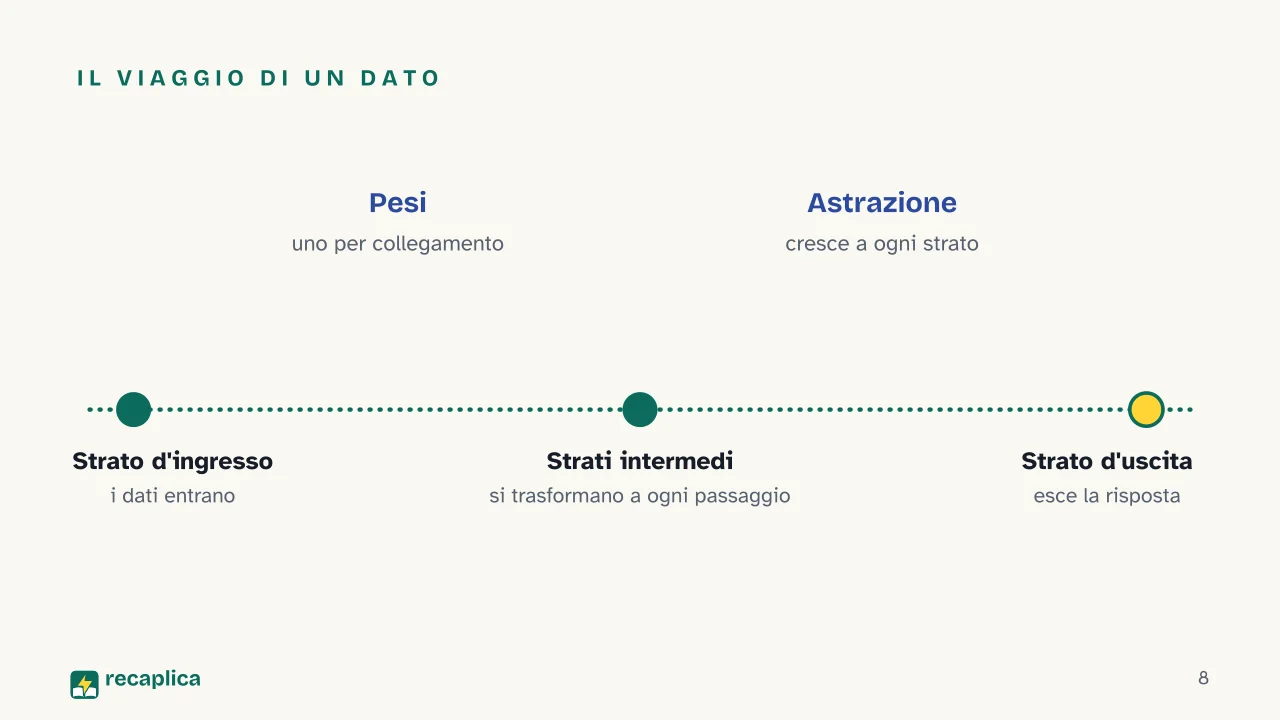 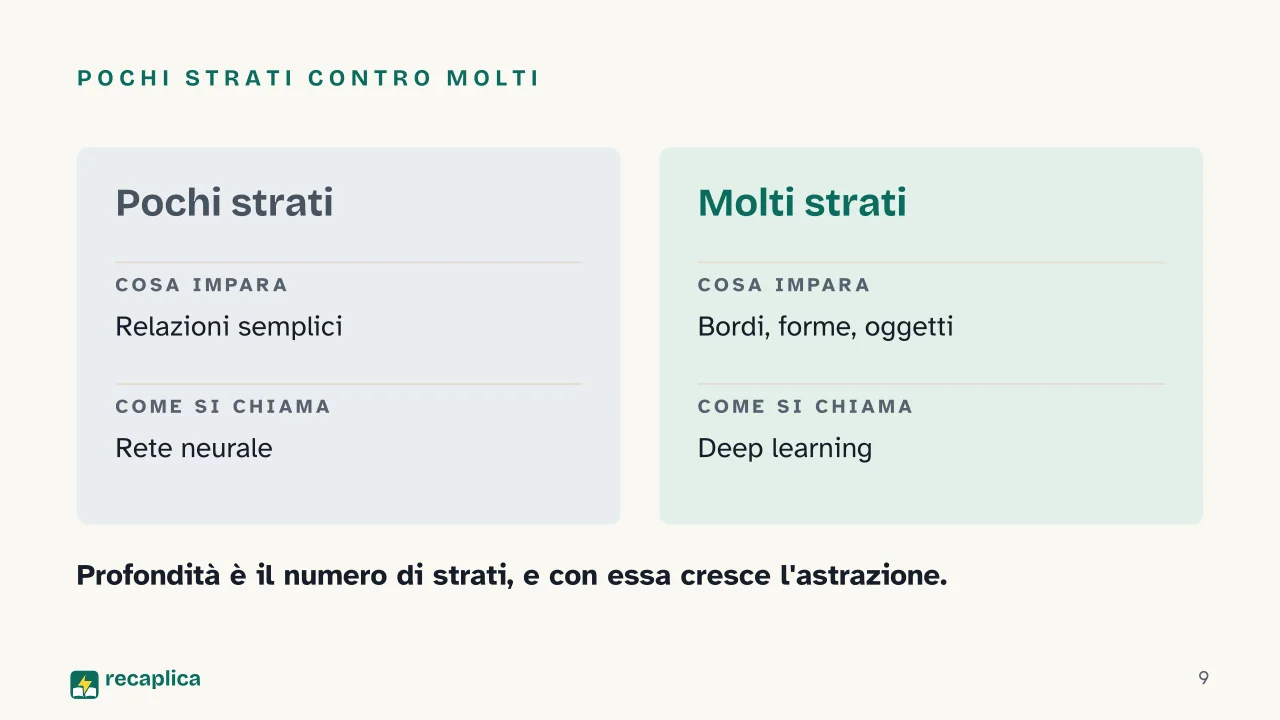  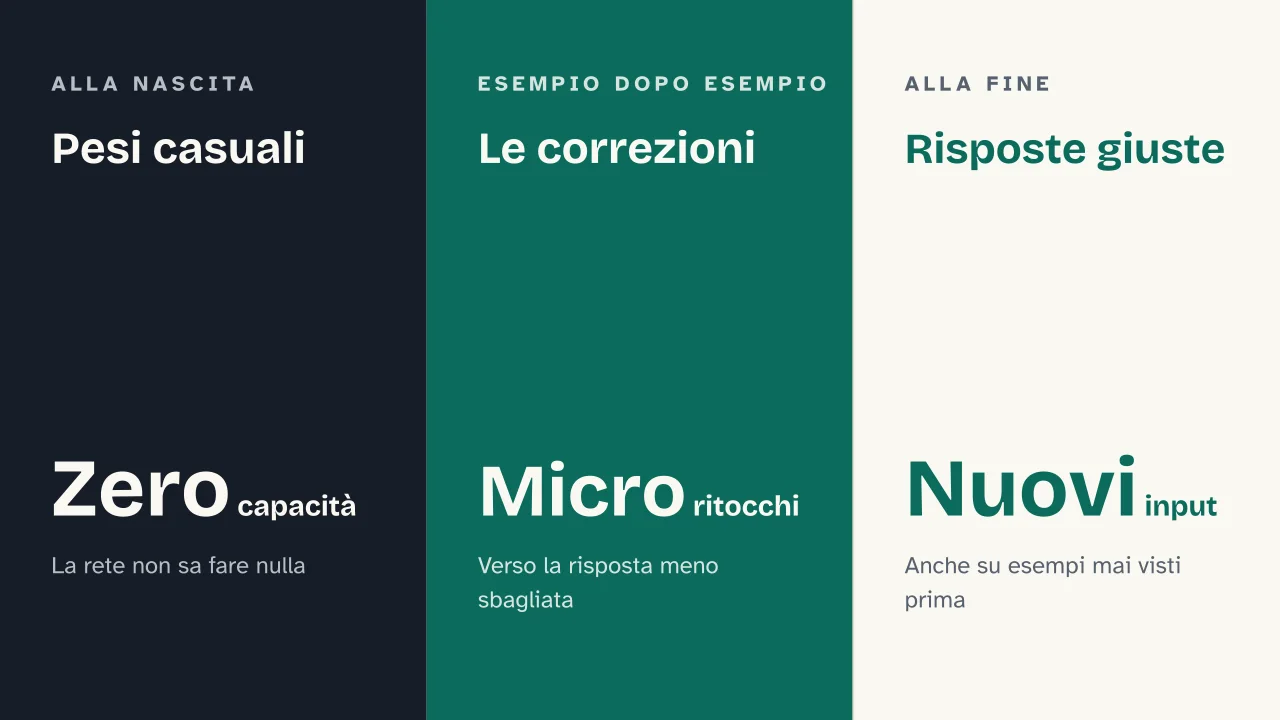  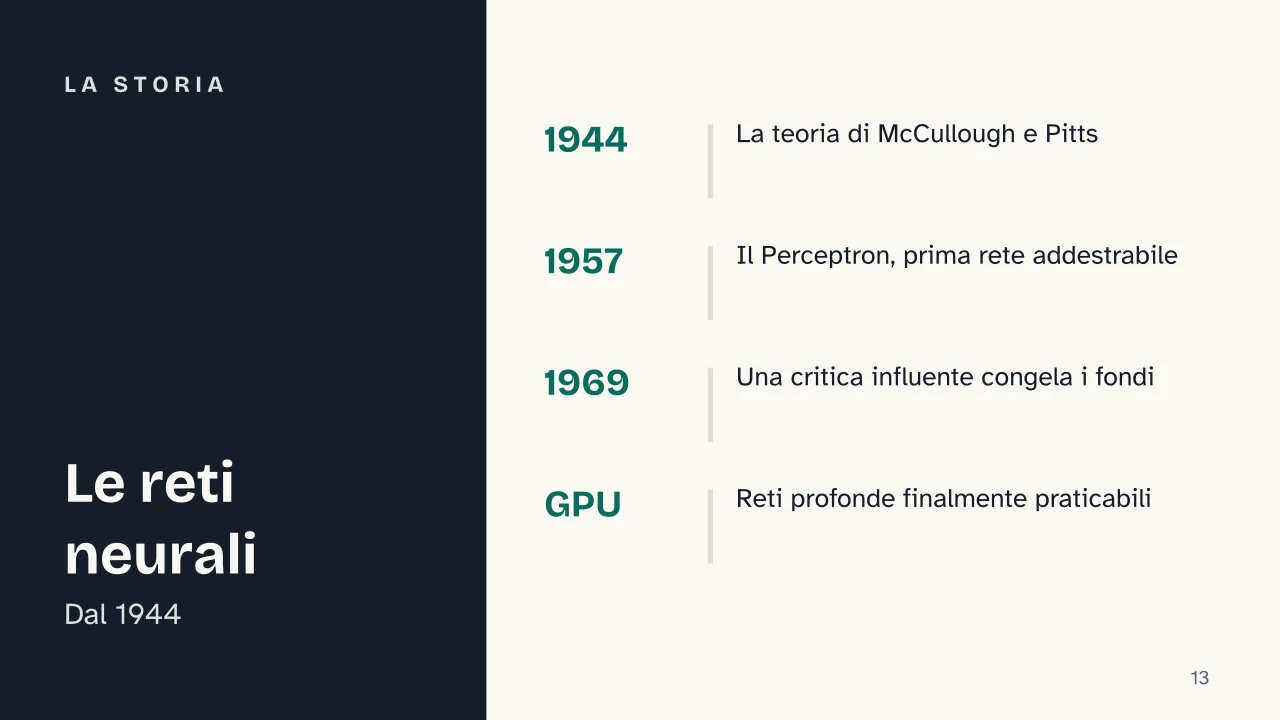 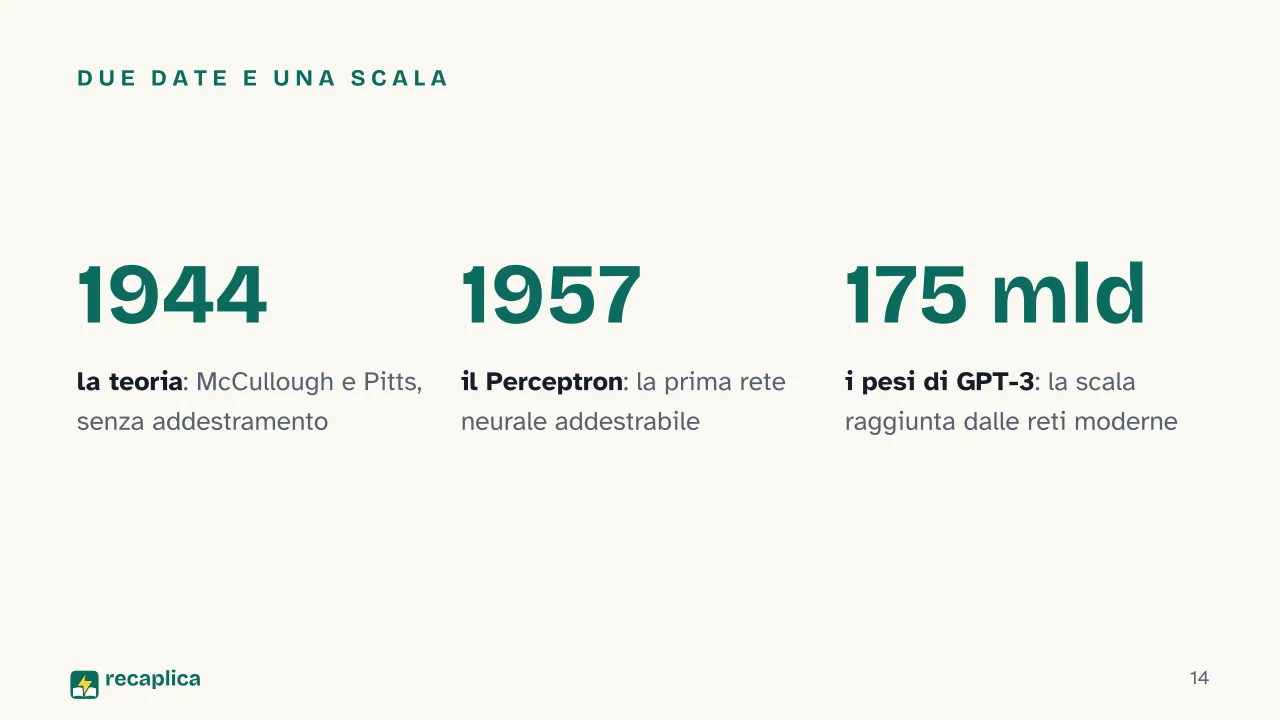    Falsi miti
Mappa concettualeTrascina lo sfondo per muoverti e i nodi per riposizionarli; usa − e + per chiudere e aprire i rami. 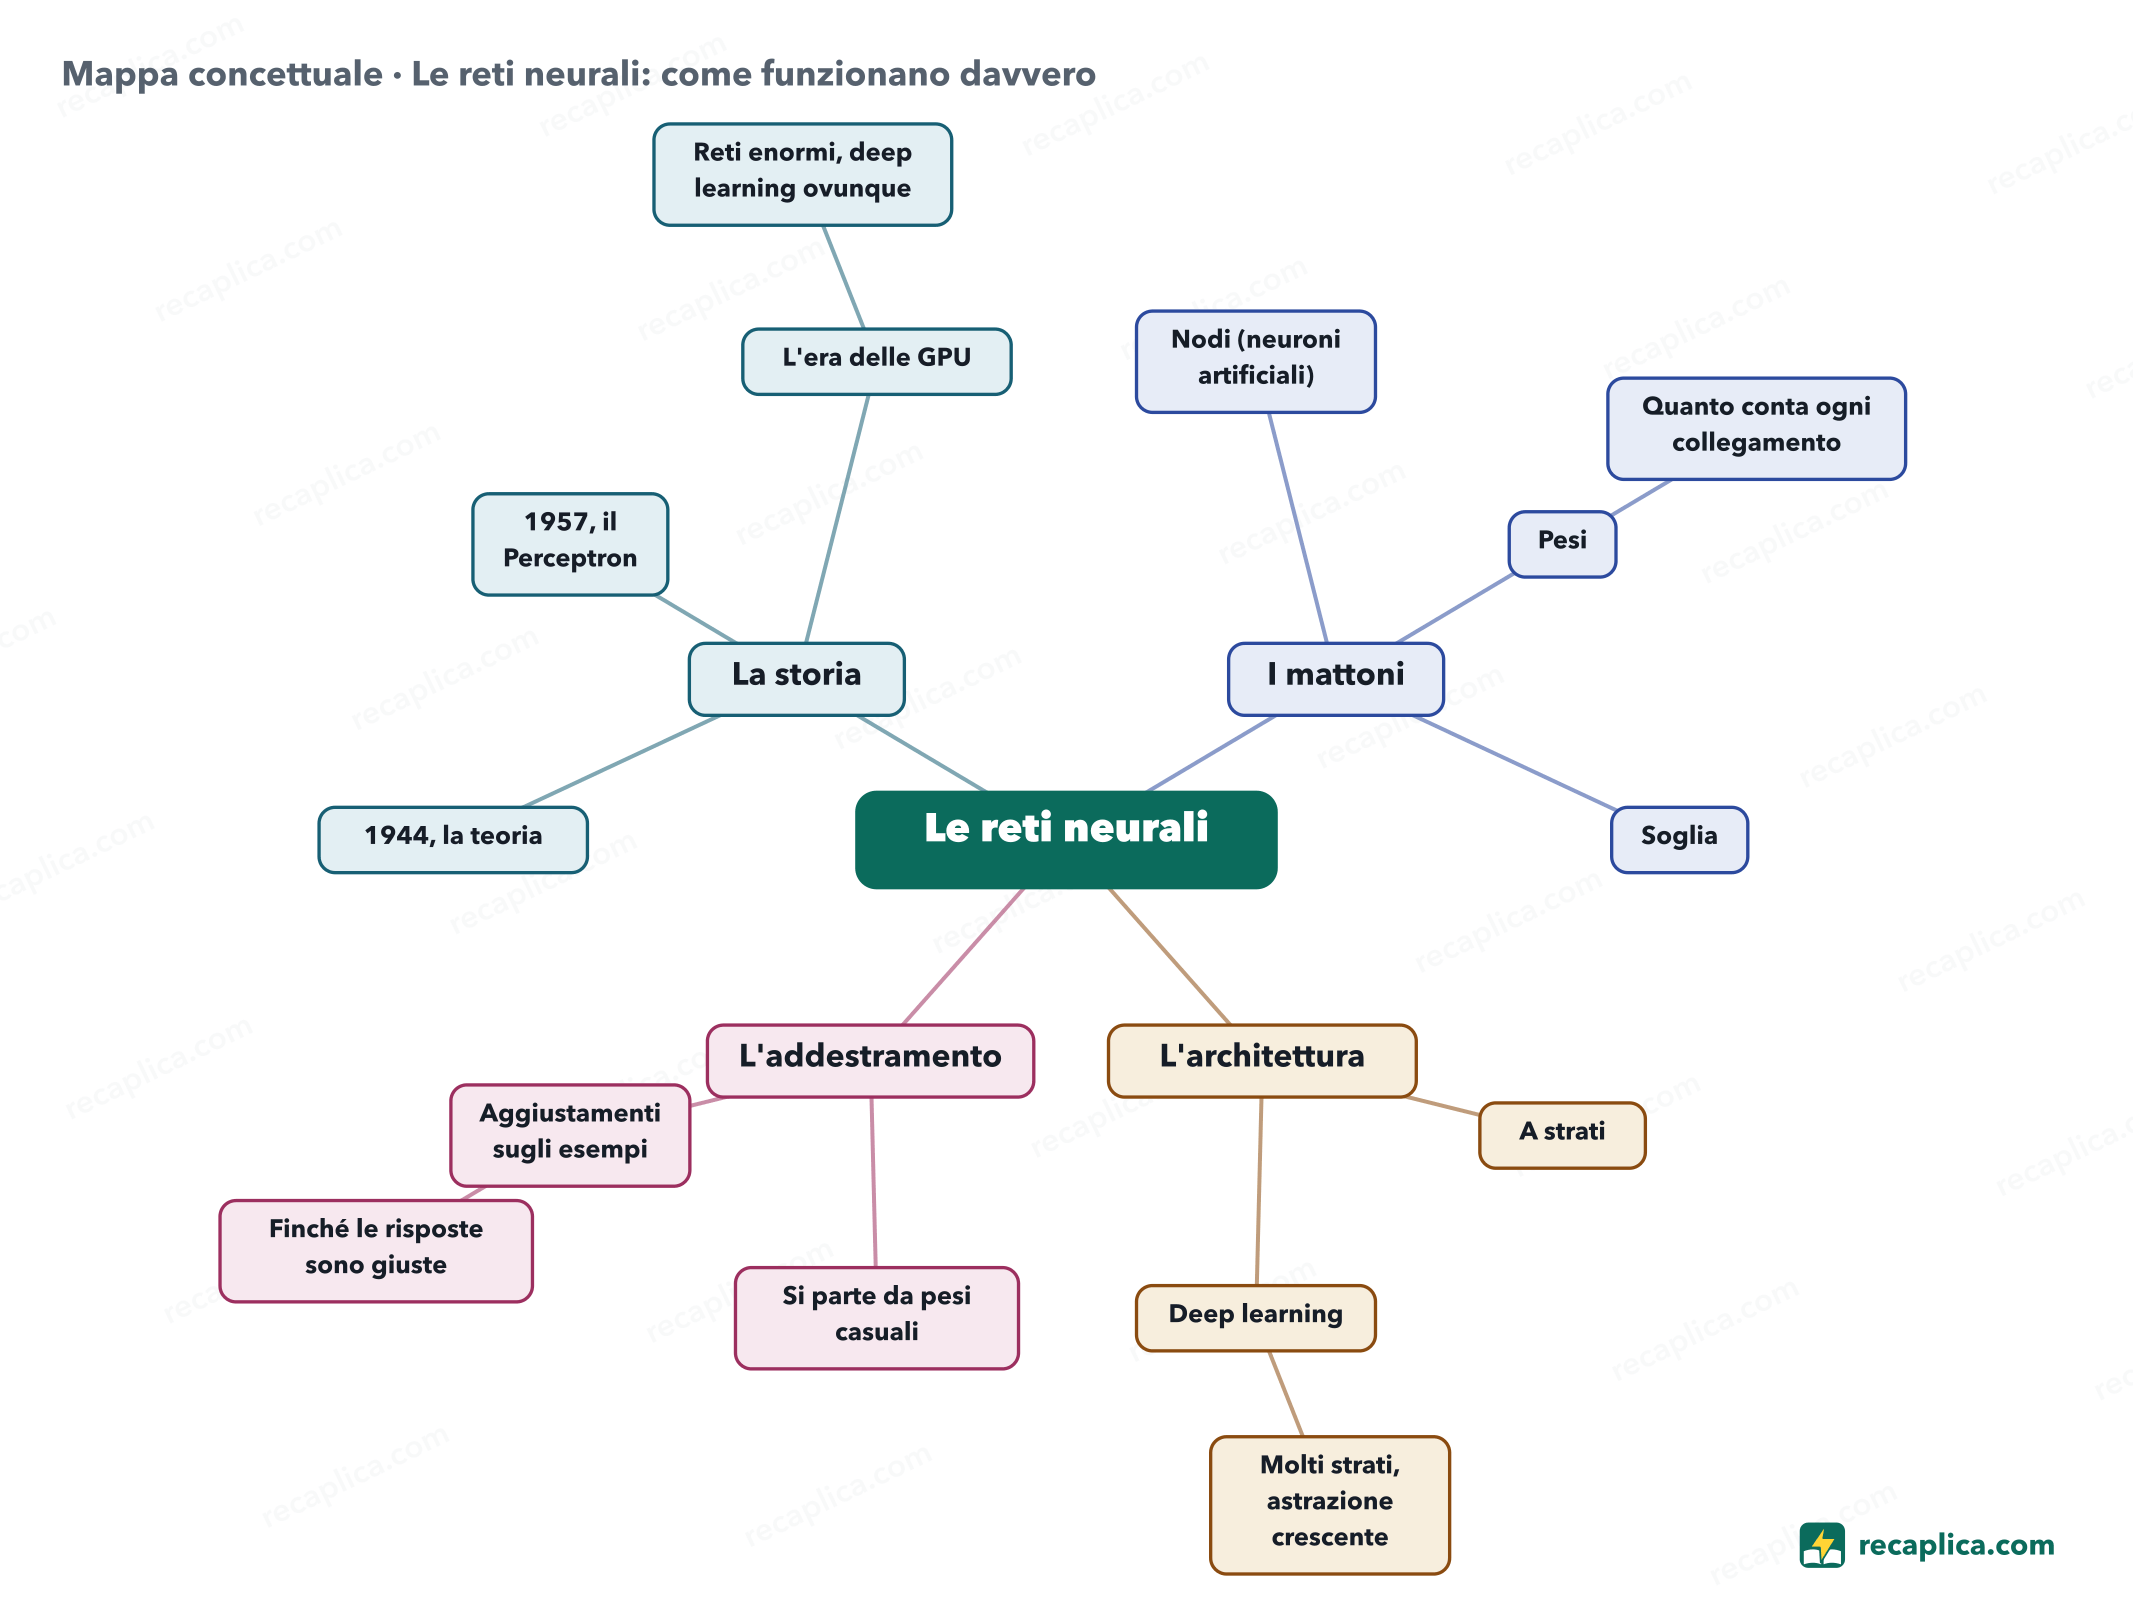
Quiz: mettiti alla provaRispondi alle domande per verificare quanto hai imparato: riceverai subito la correzione e una breve spiegazione. Voto 0/10 0/5
FlashcardsTocca la carta per girarla e verifica se ricordi la risposta, poi passa alla successiva. 1 / 7 Spiegalo con parole tueIl test definitivo: se sai spiegarlo con parole semplici, lo hai capito davvero. Scrivi la tua spiegazione, poi confrontala col Recap. La tua spiegazione resta salvata solo su questo dispositivo.
Domande e rispostePerché si chiamano 'neurali' se non funzionano come il cervello?Per l'ispirazione originaria: i pionieri degli anni Quaranta modellarono unità che si attivano superata una soglia, come i neuroni biologici. Il nome è rimasto, la somiglianza col cervello è rimasta superficiale. Cosa fa ogni strato di una rete profonda?Riconosce caratteristiche a un livello crescente di astrazione: in una rete per immagini, i primi strati colgono bordi e contrasti, quelli intermedi forme e trame, gli ultimi oggetti interi. Nessuno programma questa gerarchia: emerge dall'addestramento. Che rapporto c'è tra reti neurali e ChatGPT?I grandi modelli linguistici sono reti neurali gigantesche addestrate su testo: GPT-3, ad esempio, è una rete con 175 miliardi di pesi. La stessa architettura di base, portata a scala industriale. Perché le GPU sono state la svolta?Addestrare una rete richiede miliardi di moltiplicazioni ripetitive, il tipo di calcolo per cui le schede grafiche sono nate. Con le GPU è diventato pratico addestrare reti a decine di strati su enormi quantità di dati: da lì l'esplosione del deep learning. Ogni Recap passa da una revisione indipendente prima della pubblicazione. |