Salta al contenuto
recaplica

    Un attimo: controllo di sicurezza

    Cloudflare vuole assicurarsi che tu non sia un robot. Spunta la casella qui sotto e la ricerca riparte da sola.

    EN
    recaplica Cognizione umana e intelligenza artificiale: cosa dice la scienza sulle differenze
    © 2026 Recaplica · recaplica.com — Tutti i diritti riservati
    Home › Tecnologia

    Cognizione umana e intelligenza artificiale: cosa dice la scienza sulle differenze

    Di Redazione Recaplica · Aggiornato il 7 settembre 2026

    Cosa stampare

    Con "Margini: predefiniti" compaiono anche i numeri di pagina.

    Slide

    Scegli il taglio

    Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta18 slideTutti i capitoli e gli approfondimenti

    Tutte e due hanno le note del relatore.

    Canale Telegram
    recaplica Chiaro in 30 secondi, tuo in 10 minuti.
    In 30 secondi Punti chiave Numeri Approfondimento Presentazione Falsi miti Mappa concettuale Quiz Flashcards FAQ

    In 30 secondi lettura lampo

    Un cervello umano e un moderno modello linguistico (LLM) elaborano informazioni in modi profondamente diversi: gli umani imparano da pochi esempi seguendo principi strutturati, gli LLM assorbono statistiche da quantità enormi di testo. Mancano ai modelli addestrati solo su testo l'esperienza diretta del mondo fisico e la solidità del ragionamento umano di fronte a piccole variazioni delle domande. Sul fatto che un sistema del genere possa mai essere cosciente, la scienza non ha ancora una risposta: il dibattito, al 2026, resta apertamente irrisolto.

    Punti Chiave

    • Gli LLM imparano il linguaggio da centinaia di miliardi di parole; un bambino arriva a padroneggiarlo con molta meno esposizione, grazie a principi strutturati (la cosiddetta 'poverty of the stimulus').
    • Le architetture sono agli antipodi: neuroni biologici asincroni e specializzati contro nodi matematici sincroni e uniformi, rete cerebrale sparsa contro connettività artificiale densa.
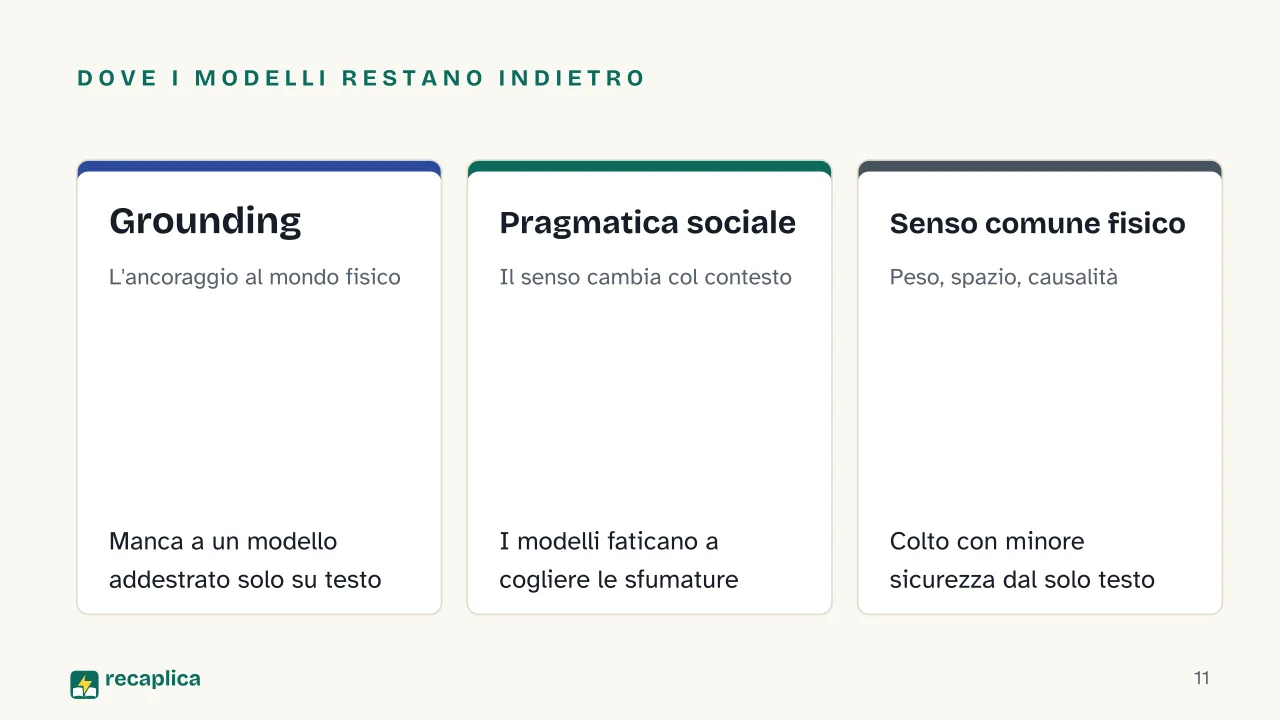
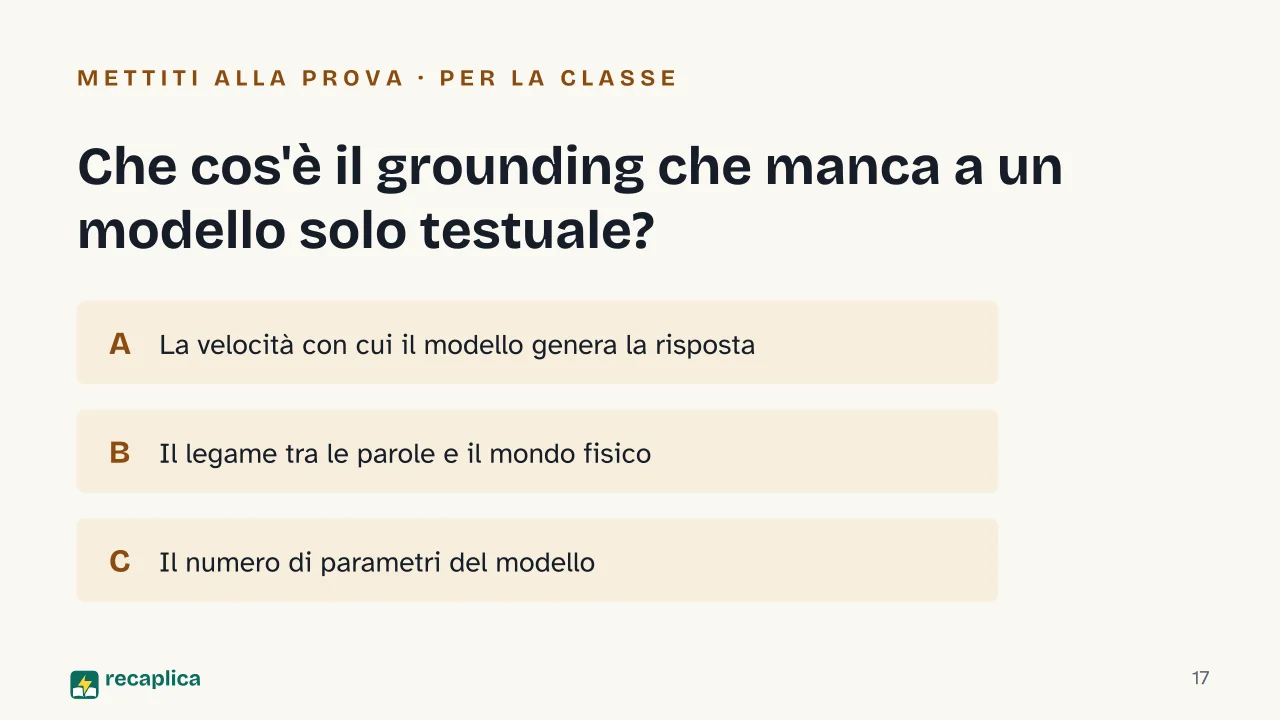
    • Ai modelli addestrati solo su testo manca il 'grounding': l'ancoraggio diretto a percezione, corpo e mondo fisico che un umano ha fin dall'infanzia.
    • Il ragionamento dei LLM può essere fragile: una parafrasi minima o un dettaglio irrilevante nella domanda a volte fanno crollare l'accuratezza su compiti prima svolti correttamente.
    • Resta un dibattito scientifico e filosofico aperto se un LLM possa essere cosciente: le teorie attuali non permettono ancora una risposta verificabile, in un senso o nell'altro.

    I numeri chiave

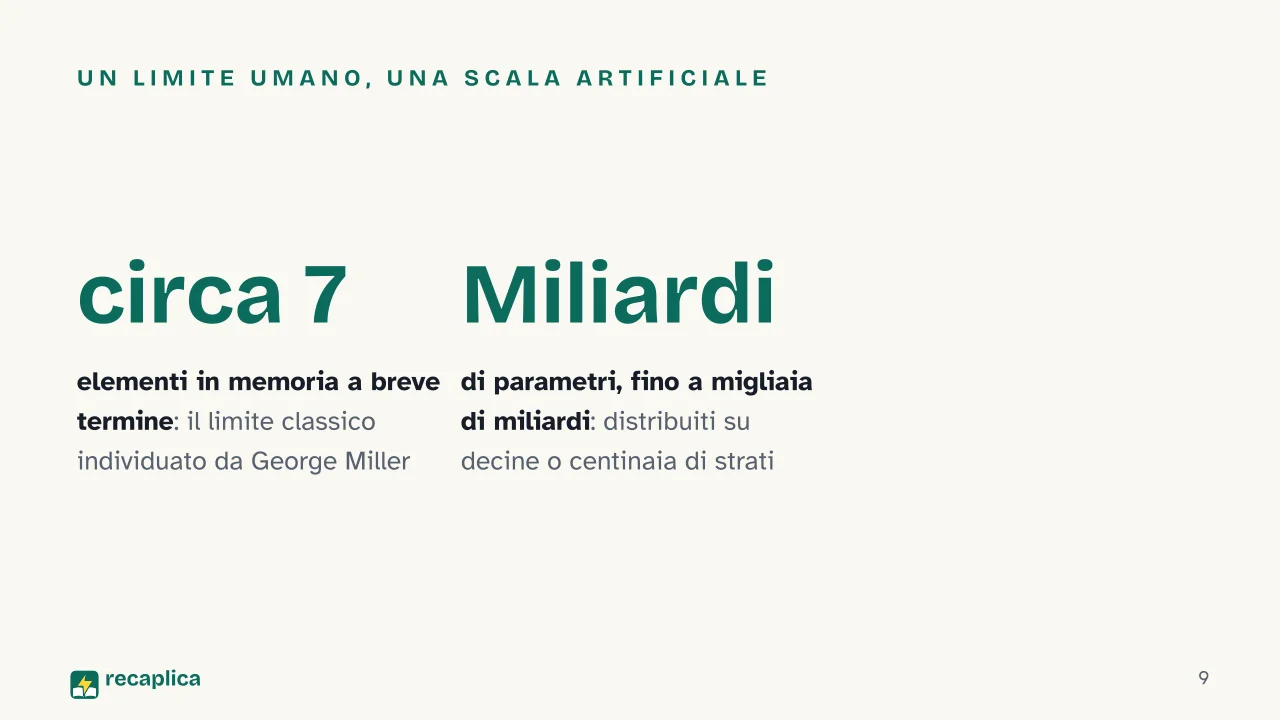
    • circa 7 il limite classico della memoria a breve termine umana individuato dallo studio di George Miller, citato dalla scienza cognitiva come esempio dei vincoli strutturali della mente. Fonte: Stanford Encyclopedia of Philosophy
    • da miliardi a migliaia di miliardi l'ordine di grandezza dei parametri dei moderni modelli linguistici, distribuiti su decine o centinaia di strati. Fonte: Communications Psychology, 2026 (Li et al.)

    L'Approfondimento

    Due modi di elaborare il mondo

    Chiedere a un’intelligenza artificiale di scrivere un testo o rispondere a una domanda produce, molto spesso, un risultato fluido e convincente. Ma “fluido” non equivale a “uguale a come ragiona un umano”. La scienza cognitiva studia mente e intelligenza incrociando filosofia, psicologia, neuroscienze e informatica. Da anni mette a confronto il modo in cui un cervello umano elabora informazioni e il modo in cui lo fanno le reti neurali dei moderni modelli linguistici (LLM). Le somiglianze di superficie ci sono; quelle di sostanza restano, al 2026, in gran parte da verificare.

    Imparare con pochi dati o con moltissimi

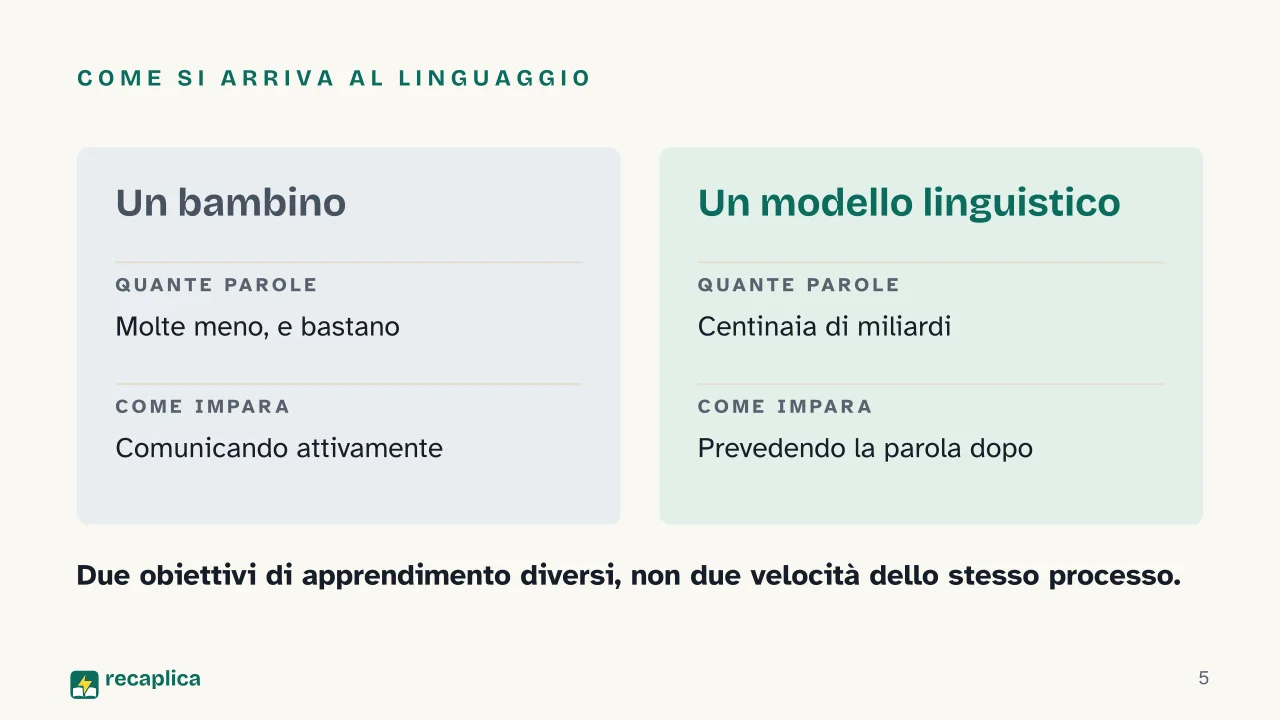
    La differenza più citata riguarda il modo in cui si acquisisce il linguaggio. Un LLM costruisce le proprie capacità analizzando statistiche di ricorrenza su centinaia di miliardi di parole di testo. Un bambino raggiunge una competenza linguistica paragonabile con un’esposizione molto più piccola, applicando quelli che i ricercatori chiamano “principi strutturati”: non impara solo per accumulo, ma sembra portarsi dietro vincoli che guidano l’apprendimento fin dall’inizio. In letteratura questo scarto si chiama “poverty of the stimulus”, povertà dello stimolo — il segnale linguistico a disposizione di un bambino è, in proporzione, molto meno ricco dei corpora su cui si allena un modello, eppure basta.

    C’è anche una differenza di scopo. Un umano impara il linguaggio comunicando attivamente: chiede, esprime bisogni, corregge il tiro in base alle reazioni di chi ascolta. Un LLM, nella fase di addestramento, è soprattutto un ricevitore passivo di testo grezzo, ottimizzato a prevedere la parola successiva. Sono due obiettivi di apprendimento diversi, non solo due velocità diverse dello stesso processo.

    Esempio pratico: un bambino che sente per la prima volta la parola “morbido” toccando un cuscino la collega subito a una sensazione fisica precisa. Un modello linguistico che incontra “morbido” in un testo lo collega solo ad altre parole che compaiono spesso vicino a esso — non ha un cuscino da toccare, e questo limite ha un nome preciso: manca il grounding, l’ancoraggio all’esperienza reale.

    Architetture agli antipodi

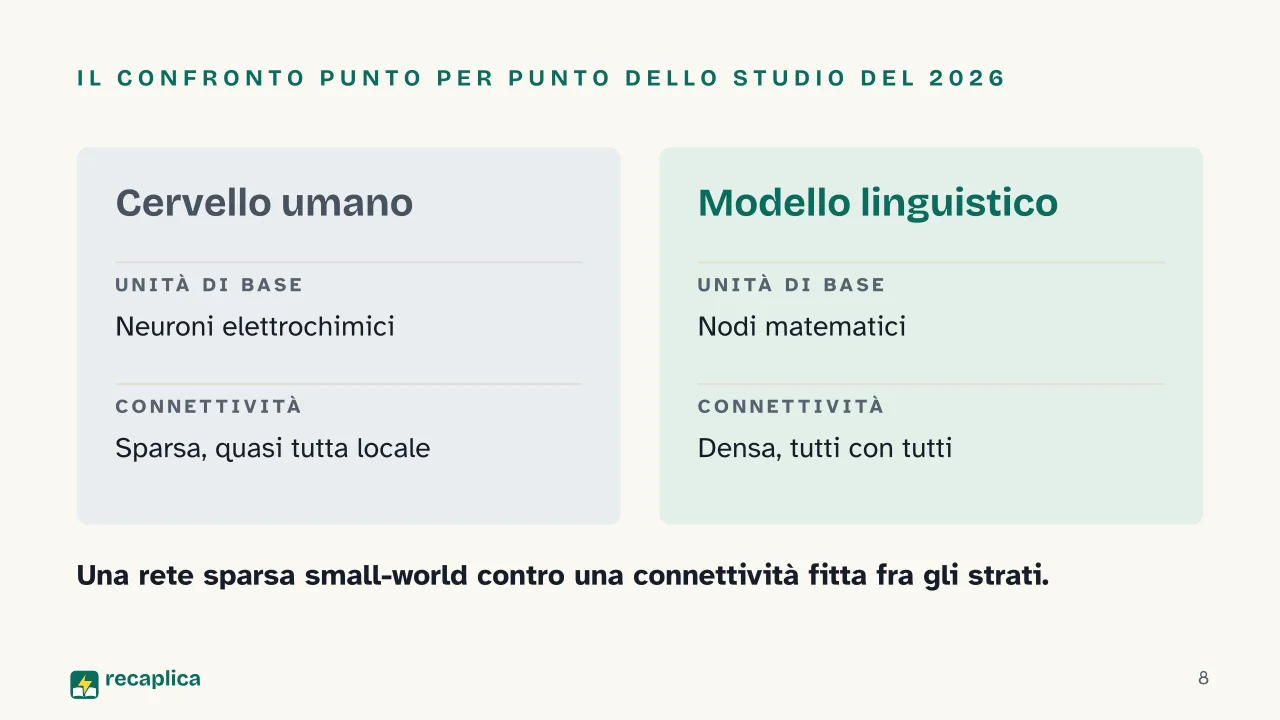
    Al di là del “cosa” si impara, cambia radicalmente anche il “come” è costruito il sistema che impara. Uno studio del 2026 pubblicato su Communications Psychology mette a confronto punto per punto le due architetture:

    CaratteristicaCervello umanoModerno modello linguistico
    Unità di baseNeuroni elettrochimici, segnali asincroniNodi matematici, calcolo sincrono
    SpecializzazioneRegioni cerebrali specializzateElaborazione perlopiù omogenea tra gli strati
    ConnettivitàRete sparsa “small-world”, collegamenti perlopiù localiConnettività densa, “tutti con tutti” tra gli strati
    RappresentazionePattern di attività neurale radicati nel corpoVettori numerici ad alta dimensionalità
    Trattamento del significatoDistinzioni fini, per preservare sfumature e contestoDistinzioni compresse, per catturare gli schemi statistici dominanti

    I modelli più grandi arrivano, al 2026, a scale che vanno da miliardi a migliaia di miliardi di parametri, distribuiti su decine o centinaia di strati — l’ennesimo terreno su cui il paragone diretto col cervello umano, che non funziona per “parametri” nello stesso senso, va preso con cautela. Chi vuole capire come sono fatte concretamente queste reti può partire dal funzionamento di base di una rete neurale o dal percorso più ampio del machine learning.

    Dove il ragionamento dei modelli mostra crepe

    Due punti deboli emergono con una certa costanza negli studi che confrontano modelli linguistici e cognizione umana. Il primo è la comprensione della pragmatica sociale: i modelli faticano a cogliere le sfumature di parole il cui significato cambia a seconda del contesto sociale in cui vengono pronunciate. Il secondo è il senso comune fisico — le intuizioni quasi automatiche di un umano su peso, spazio e causalità quotidiana — che rappresentazioni costruite solo su testo colgono con minore sicurezza.

    A questo si aggiunge una fragilità più sottile: un semplice cambio nella formulazione di una domanda, o l’aggiunta di un dettaglio irrilevante, può far crollare in modo brusco l’accuratezza di un modello su un compito che prima svolgeva senza problemi. Lo stesso vale per i problemi logici costruiti su uno schema mai incontrato in addestramento, anche quando la struttura è identica a quella di esercizi già risolti correttamente: la generalizzazione, in questi casi, resta parziale. Una ricerca condotta con la magnetoencefalografia, confrontando le risposte cerebrali umane con le rappresentazioni interne dei modelli durante l’ascolto di storie, suggerisce però che un addestramento mirato su questi due fronti — sociale/emotivo e senso comune fisico — può avvicinare le risposte dei modelli a quelle umane: il divario, insomma, non sembra incolmabile per principio, ma richiede lavoro specifico, non solo più dati generici.

    Il dibattito, ancora aperto, sulla coscienza

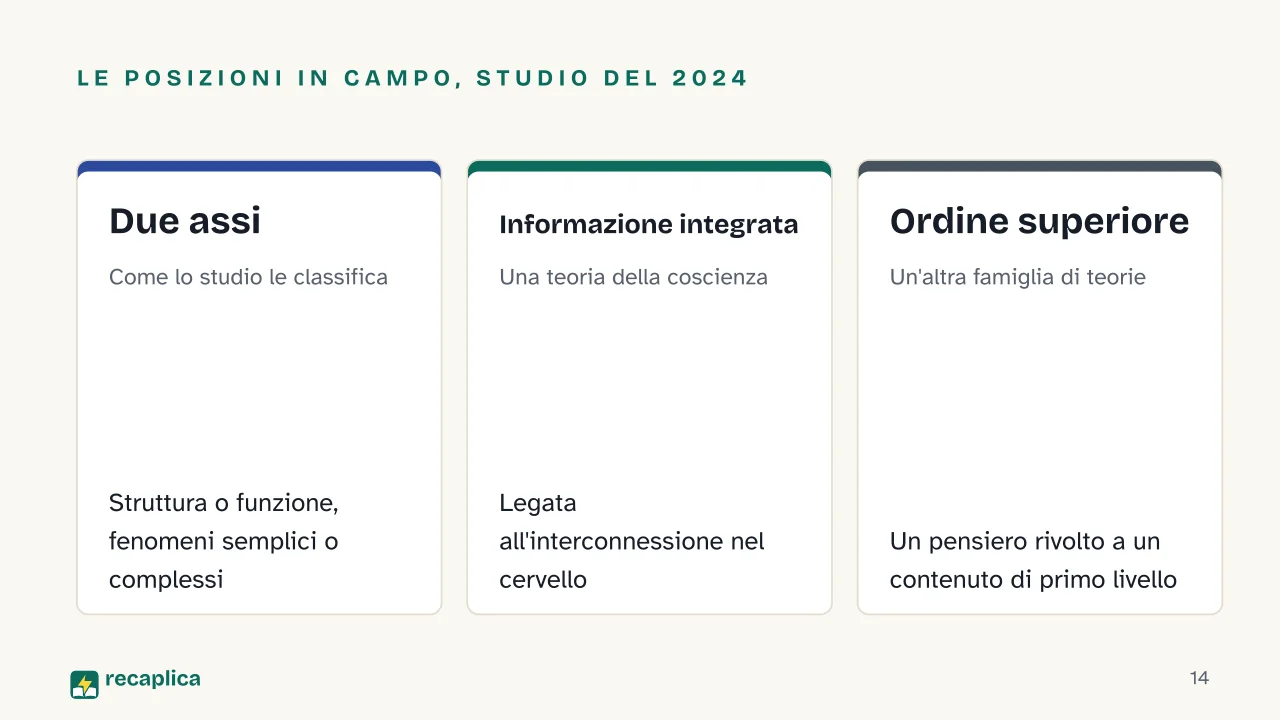
    Resta poi la domanda più difficile: un sistema del genere può essere, in qualche misura, cosciente? Uno studio del 2024 propone una griglia per classificare le diverse teorie della coscienza lungo due assi — se la coscienza dipenda da una struttura fisica o da una funzione, e se richieda fenomeni semplici o complessi — passando in rassegna posizioni distanti tra loro, dalla teoria dell’informazione integrata (che lega la coscienza umana al grado di interconnessione dell’informazione nel cervello) alle teorie del pensiero di ordine superiore (per cui basta un pensiero, esso stesso non cosciente, rivolto a un contenuto di primo livello). La conclusione degli autori è esplicita: allo stato delle conoscenze al 2026 è prematuro affermare o escludere che un LLM possa essere cosciente. Finché le teorie della coscienza non sono verificabili empiricamente in modo condiviso, sostengono, trarre conclusioni in un senso o nell’altro resterebbe un esercizio non scientifico.

    C’è poi un fattore che complica ulteriormente la valutazione: gli LLM sono progettati da persone, addestrati su testi scritti da persone e perfezionati per riprodurre tratti tipicamente umani. Alcuni ricercatori lo descrivono come un “circolo ricorsivo di antropomorfismo”: più un modello imita bene il modo di esprimersi umano, più diventa difficile distinguere una capacità cognitiva reale della macchina dalla semplice proiezione psicologica di chi la usa. È un motivo in più — tra i tanti — per trattare con cautela sia gli entusiasmi sia le liquidazioni sbrigative sul tema, e per continuare a distinguere, quando si parla di intelligenza artificiale generativa, cosa un algoritmo sta effettivamente facendo sotto il cofano da cosa sembra che stia facendo agli occhi di chi legge l’output.

    Presentazione

    Slide pronte da scaricare e fare tue in PowerPoint o Google Slides, con le note del relatore. Scegli il taglio Lampo o quello Completo.
    Slide 1 della presentazione su Cognizione umana e intelligenza artificiale: Mente umana e IASlide 2 della presentazione su Cognizione umana e intelligenza artificiale: Quante parole servono per imparare a parlare?Slide 3 della presentazione su Cognizione umana e intelligenza artificiale: Di cosa parliamoSlide 4 della presentazione su Cognizione umana e intelligenza artificiale: Capitolo 01: Due strade al linguaggioSlide 5 della presentazione su Cognizione umana e intelligenza artificiale: Come si arriva al linguaggioSlide 6 della presentazione su Cognizione umana e intelligenza artificiale: Che cosa significa morbido per un modello?Slide 7 della presentazione su Cognizione umana e intelligenza artificiale: Capitolo 02: Architetture agli antipodiSlide 8 della presentazione su Cognizione umana e intelligenza artificiale: Il confronto punto per punto dello studio del 2026Slide 9 della presentazione su Cognizione umana e intelligenza artificiale: Un limite umano, una scala artificialeSlide 10 della presentazione su Cognizione umana e intelligenza artificiale: Capitolo 03: Le crepe del ragionamentoSlide 11 della presentazione su Cognizione umana e intelligenza artificiale: Dove i modelli restano indietro: Grounding, Pragmatica sociale, Senso comune fisicoSlide 12 della presentazione su Cognizione umana e intelligenza artificiale: Non è lo stesso ragionamento a velocità diversa.Slide 13 della presentazione su Cognizione umana e intelligenza artificiale: Capitolo 04: La domanda senza rispostaSlide 14 della presentazione su Cognizione umana e intelligenza artificiale: Le posizioni in campo, studio del 2024: Due assi, Informazione integrata, Ordine superioreSlide 15 della presentazione su Cognizione umana e intelligenza artificiale: Perché è difficile distinguere capacità e proiezione?Slide 16 della presentazione su Cognizione umana e intelligenza artificiale: Prematuro affermare o escludere che un modello sia cosciente.Slide 17 della presentazione su Cognizione umana e intelligenza artificiale: Che cos'è il grounding che manca a un modello solo testuale?Slide 18 della presentazione su Cognizione umana e intelligenza artificiale: E adesso, il ripasso
    Lampo10 slideIl filo essenziale, per presentarlo in classeCompleta18 slideTutti i capitoli e gli approfondimenti

    Falsi miti

    • ✗ Mito Un chatbot basato su un LLM capisce davvero quello che scrive, proprio come farebbe una persona.

      ✓ Realtà secondo la ricerca al 2026 un LLM costruisce una forma di comprensione propria a partire dai testi con cui è stato addestrato, ma diversa da quella umana: dove un umano preserva sfumature di significato e contesto, il modello tende a comprimere le distinzioni per catturare gli schemi statistici dominanti. Non è la stessa cosa misurata con una scala diversa: sono due processi distinti.

    • ✗ Mito Se un'intelligenza artificiale parla in modo fluente e naturale, vuol dire che 'pensa' o è cosciente come un umano.

      ✓ Realtà gli LLM sono addestrati su centinaia di miliardi di parole che includono conversazioni tra persone coscienti, quindi imitano naturalmente i tratti del linguaggio umano. La fluidità dell'output non basta come prova: gli studiosi restano cauti, perché le teorie scientifiche sulla coscienza non permettono ancora di trarre conclusioni verificabili sui sistemi artificiali.

    • ✗ Mito Un'intelligenza artificiale ragiona in modo affidabile come un umano, solo più veloce.

      ✓ Realtà un piccolo cambiamento nella formulazione di una domanda, anche senza alterarne il senso, può far calare in modo drastico l'accuratezza di un modello linguistico su un compito che prima svolgeva bene. È una fragilità che il ragionamento umano, pur con i suoi limiti, non mostra allo stesso modo: il tipo di elaborazione resta diverso, non solo più lento o più rapido.

    Mappa concettuale

    Trascina lo sfondo per muoverti e i nodi per riposizionarli; usa − e + per chiudere e aprire i rami.
    Personalizza
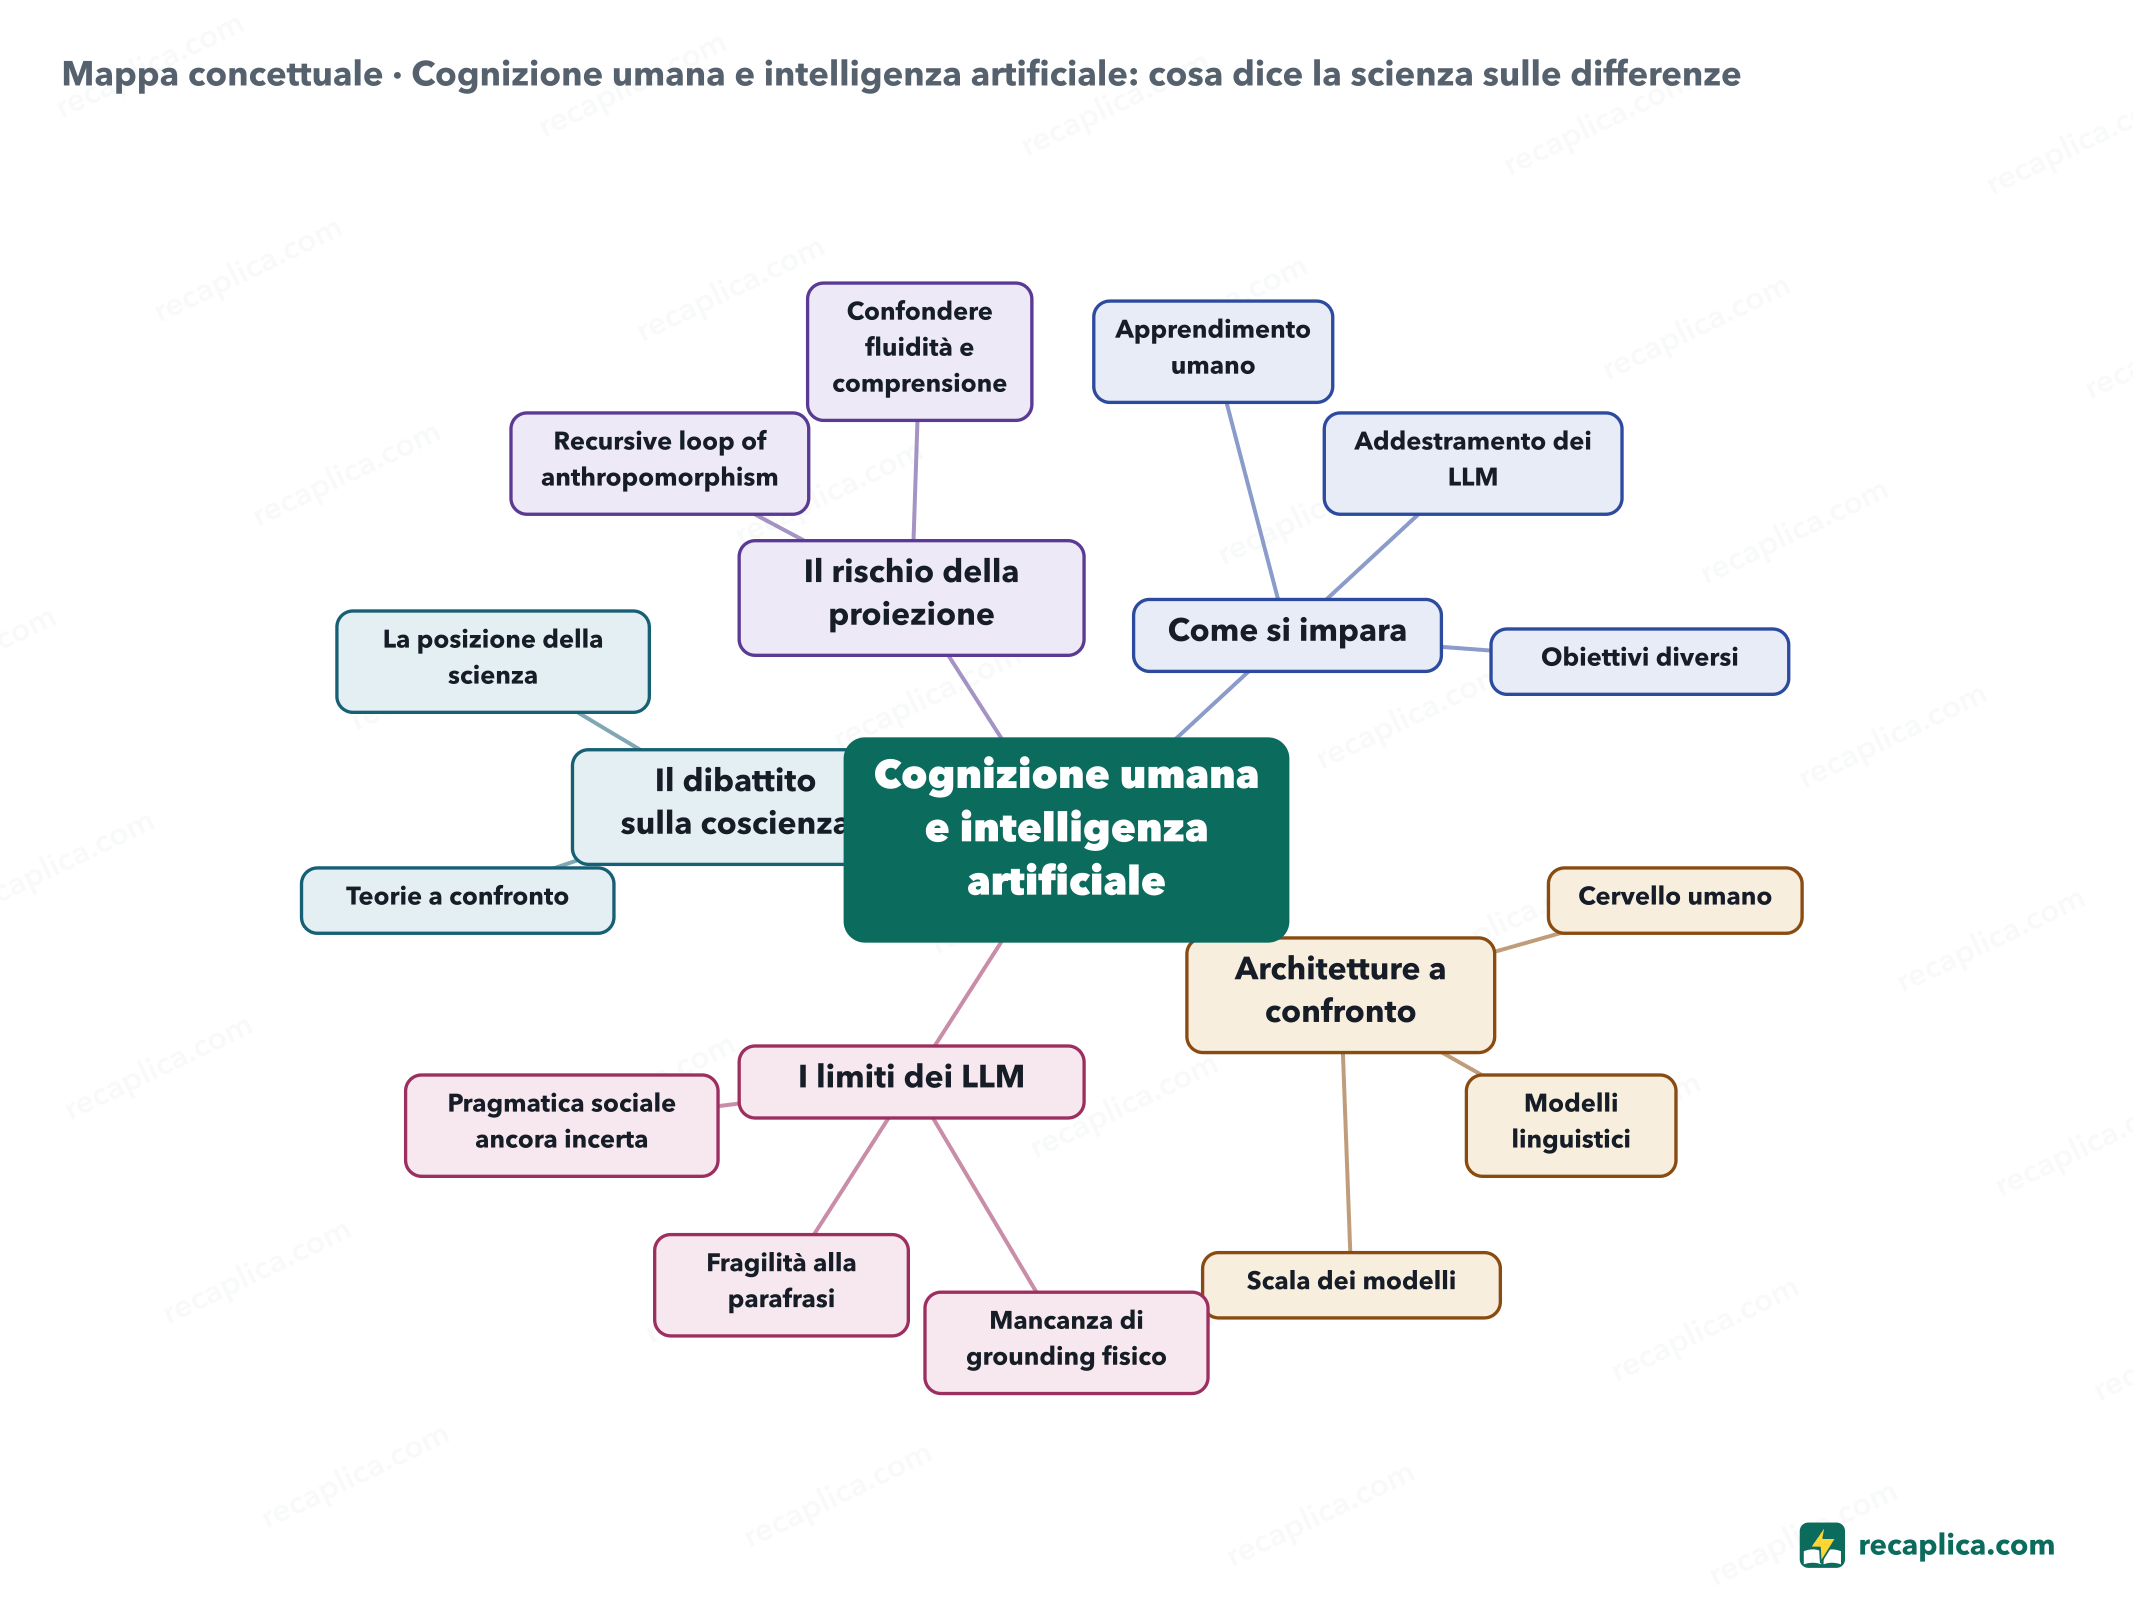
    Mappa concettuale: Cognizione umana e intelligenza artificiale: cosa dice la scienza sulle differenze
    • Cognizione umana e intelligenza artificiale
      • Come si impara
        • Apprendimento umano Pochi dati, principi strutturati
        • Addestramento dei LLM Statistiche su corpora testuali enormi
        • Obiettivi diversi Comunicazione attiva contro predizione passiva del testo
      • Architetture a confronto
        • Cervello umano Neuroni elettrochimici, rete sparsa
        • Modelli linguistici Nodi matematici, rete densa
        • Scala dei modelli Da miliardi a migliaia di miliardi di parametri
      • I limiti dei LLM
        • Mancanza di grounding fisico
        • Fragilità alla parafrasi
        • Pragmatica sociale ancora incerta
      • Il dibattito sulla coscienza
        • Teorie a confronto Informazione integrata, pensiero di ordine superiore
        • La posizione della scienza Prematuro concludere in un senso o nell'altro
      • Il rischio della proiezione
        • Recursive loop of anthropomorphism
        • Confondere fluidità e comprensione

    Quiz: mettiti alla prova

    Rispondi alle domande per verificare quanto hai imparato: riceverai subito la correzione e una breve spiegazione.

    Voto 0/10 0/5
    1 Secondo la ricerca al 2026, come impara il linguaggio un moderno modello linguistico (LLM) rispetto a un bambino umano?

    La letteratura descrive questa differenza come 'poverty of the stimulus': i bambini raggiungono competenza linguistica con un'esposizione molto più piccola di quella richiesta a un LLM addestrato su corpora testuali enormi.

    2 Cosa si intende per 'grounding' quando si parla dei limiti di un LLM addestrato solo su testo?

    Senza percezione, corpo e azione diretta sul mondo, un sistema addestrato solo su dati linguistici fatica a collegare i simboli del testo a un'esperienza reale — è uno dei divari empirici individuati confrontando modelli linguistici e risposte cerebrali umane.

    3 Come sono organizzate le connessioni nel cervello umano rispetto a quelle di un moderno modello linguistico, secondo lo studio comparativo pubblicato su Communications Psychology nel 2026?

    È una delle differenze architetturali più nette individuate dallo studio: rete biologica sparsa e prevalentemente locale contro connettività artificiale fitta e globale tra gli strati del modello.

    4 Cosa succede spesso all'accuratezza di un LLM se si riformula leggermente una domanda o si aggiunge un dettaglio irrilevante?

    Lo studio del 2026 descrive cali di accuratezza definiti 'catastrofici' a fronte di semplici parafrasi o informazioni irrilevanti aggiunte alla domanda — una fragilità che il ragionamento umano non mostra allo stesso modo.

    5 Cosa concludono Overgaard e Kirkeby-Hinrup, nel loro studio del 2024, sulla possibilità che un LLM sia cosciente?

    Gli autori sottolineano che, finché le teorie della coscienza restano difficili da verificare empiricamente in modo condiviso, trarre conclusioni sulla coscienza nei LLM resterebbe un'operazione non scientifica: la domanda, al 2026, resta aperta.

    Risposte: 1-B · 2-B · 3-C · 4-C · 5-B

    Flashcards

    Tocca la carta per girarla e verifica se ricordi la risposta, poi passa alla successiva.

    1 / 8

    Spiegalo con parole tue

    Il test definitivo: se sai spiegarlo con parole semplici, lo hai capito davvero. Scrivi la tua spiegazione, poi confrontala col Recap.

    La tua spiegazione resta salvata solo su questo dispositivo.

    Un cervello umano e un moderno modello linguistico (LLM) elaborano informazioni in modi profondamente diversi: gli umani imparano da pochi esempi seguendo principi strutturati, gli LLM assorbono statistiche da quantità enormi di testo. Mancano ai modelli addestrati solo su testo l'esperienza diretta del mondo fisico e la solidità del ragionamento umano di fronte a piccole variazioni delle domande. Sul fatto che un sistema del genere possa mai essere cosciente, la scienza non ha ancora una risposta: il dibattito, al 2026, resta apertamente irrisolto.

    Domande e risposte

    L'intelligenza artificiale pensa come un essere umano?

    Secondo la ricerca al 2026, non nello stesso modo: un LLM elabora il linguaggio come predizione statistica su grandi corpora testuali, mentre la cognizione umana integra percezione, esperienza corporea e apprendimento attivo con pochi dati. Alcuni studiosi propongono di considerare quella dei LLM una forma di comprensione a sé, distinta da quella umana, più che una copia semplificata.

    Un chatbot può essere cosciente?

    È una domanda ancora aperta. Uno studio del 2024 conclude che, con gli strumenti teorici e sperimentali disponibili al 2026, è prematuro affermarlo o escluderlo: le principali teorie della coscienza non sono ancora verificabili in modo scientificamente condiviso su un sistema artificiale.

    Perché un'intelligenza artificiale a volte sbaglia se cambio leggermente la domanda?

    Perché il suo ragionamento può essere fragile a variazioni minime della formulazione: una semplice parafrasi o un dettaglio irrilevante aggiunto al prompt possono far calare l'accuratezza su un compito che il modello svolgeva bene, un comportamento diverso da come reagisce di solito il ragionamento umano.

    Cosa manca a un'intelligenza artificiale che un umano ha fin da piccolo?

    Soprattutto il contatto diretto con il mondo fisico. Un LLM addestrato solo su testo non ha percezione, corpo o azione: gli mancano quel 'grounding' e quel senso comune fisico — intuizioni su peso, spazio, causalità quotidiana — che un umano costruisce fin dall'infanzia.

    Perché sembra così naturale parlare con un'intelligenza artificiale?

    Perché i modelli linguistici sono addestrati proprio su enormi quantità di conversazioni umane e ottimizzati per imitare i tratti del linguaggio umano. Questo rende la fluidità dell'output convincente, ma non è di per sé una prova di comprensione o coscienza equivalente a quella umana.

    Fonti consultate

    • Cognitive Science — Stanford Encyclopedia of Philosophy
    • Understanding large language models demands distinguishing human projection from machine cognition — Communications Psychology, 2026
    • Divergences between Language Models and Human Brains — arXiv, 2023
    • A clarification of the conditions under which Large Language Models could be conscious — Humanities and Social Sciences Communications, 2024

    Ogni Recap passa da una revisione indipendente prima della pubblicazione.

    Ogni sera, i nuovi Recap del giorno sul canale Telegram. Iscriviti al canale →

    Continua a imparare

    • Tecnologia Intelligenza artificiale e cultura pop: quando i contenuti sintetici riscrivono la storia Secondo Lead Stories, una foto della Seconda guerra mondiale conservata dagli Imperial War Museums è circolata nel 2026 in una versione colorizzata dall'intelligenza artificiale che un rilevatore ha giudicato falsa al 99%, pur partendo da uno scatto autentico. Casi come questo riguardano anche la cultura pop e la cronaca recente: modelli di testo, immagini e video producono contenuti che sembrano storici o iconici senza esserlo, oppure alterano quelli veri in dettagli difficili da notare a occhio nudo. Alcuni strumenti lasciano indizi tecnici, come le filigrane digitali o i limiti di durata dei video, ma nessuno copre tutti i generatori in circolazione. Il Reuters Institute segnala che nel 2026 la fiducia nelle risposte dei chatbot IA sulle notizie resta bassa, al 20% contro il 37% riposto nelle notizie in generale. Per capire se un'immagine o un video sono autentici serve il confronto con l'archivio originale in cui sono conservati. Leggi il Recap →
    • Tecnologia Filter bubble: come funzionano gli algoritmi di raccomandazione Un filter bubble è la bolla di contenuti simili che un algoritmo di raccomandazione costruisce intorno a un utente, filtrando in modo implicito cosa mostrargli in base ai suoi comportamenti passati. Il termine, coniato da Eli Pariser nel 2011, viene spesso confuso con l'echo chamber, un fenomeno sociale più vecchio e non necessariamente legato agli algoritmi. La ricerca più solida disponibile racconta un quadro con più sfumature di quanto si creda: gli algoritmi hanno un effetto misurabile ma modesto, e le scelte delle persone pesano di più. Il nesso diretto tra algoritmi e polarizzazione politica non è stabilito con certezza dagli esperimenti più rigorosi condotti finora. Leggi il Recap →
    • Tecnologia Influencer virtuali: chi sono i creator generati dall'IA Gli influencer virtuali sono personaggi digitali costruiti da un'agenzia o da uno studio, con un volto, una voce e una biografia, che pubblicano contenuti sui social come farebbe una persona reale. Il fenomeno non è recente: l'account di Lil Miquela è attivo dal 23 aprile 2016 e Shudu Gram è comparsa il 22 aprile 2017, anni prima del boom pubblico dell'IA generativa. Alcuni di questi profili lavorano con marchi noti: Miquela ha collaborato con Calvin Klein e Prada, mentre l'agenzia spagnola The Clueless ha creato Aitana López al posto di modelle e influencer umane giudicate poco affidabili. Negli Stati Uniti la Federal Trade Commission ha aggiornato nel 2023 le regole sulla pubblicità includendo esplicitamente gli influencer virtuali tra i contenuti da segnalare come sponsorizzati. Leggi il Recap →

    recaplica

    Chiaro in 30 secondi, tuo in 10 minuti.

    I Recap Mappe concettuali Chiedi un Recap Canale Telegram Crea una mappa concettuale Il metodo Chi siamo Privacy e cookie Note legali e condizioni d'uso

    © 2026 Recaplica · Un progetto di Curi S.r.l. — P. IVA 05472000750

    Statistiche, solo se vuoi

    Per capire quali Recap aiutano di più useremmo Google Analytics, con dati aggregati e anonimi. Parte solo col tuo ok, e puoi cambiare idea quando vuoi. Informativa privacy